



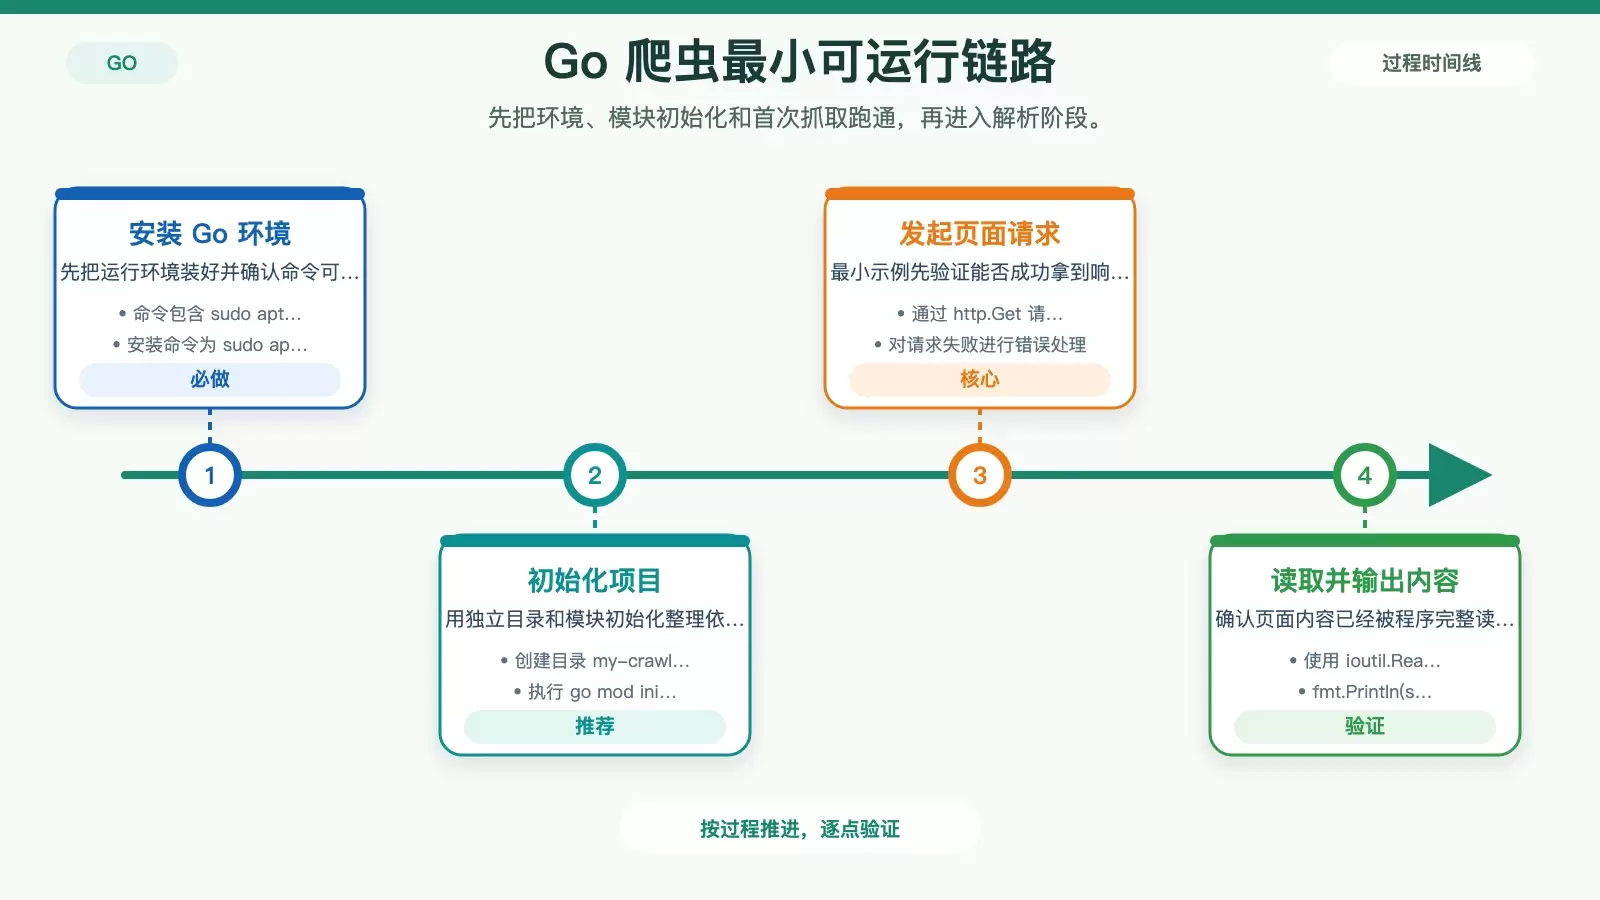
想在 Debian 上快速搭一个可运行的 Go 爬虫,核心并不在“代码有多复杂”,而在于先把环境、项目结构和最小抓取流程跑通。下面按“安装环境、创建项目、完成首次请求、解析页面、再看扩展与规范”的顺序整理一遍,读完你可以判断自己当前更适合停在基础抓取,还是继续往并发和数据处理方向扩展。
在 Debian 上安装 Go 环境
第一步先确认系统里是否已经具备 Go 运行环境。如果还没安装,可以直接使用 Debian 的软件包完成部署:
sudo apt update
sudo apt install golang-go
安装完成后,再用下面的命令确认 Go 是否已经可用:
go version如果命令能正常返回版本信息,说明基础运行环境已经准备好,可以继续创建爬虫项目。
创建项目并初始化 Go 模块
爬虫即使只是一个小脚本,也建议放进独立目录,并使用 Go Modules 管理依赖。这样后续引入解析库或拆分代码时会更清晰。
mkdir my-crawler
cd my-crawler
go mod init my-crawler
执行完以后,当前目录就是一个标准的 Go 项目。接下来只需要添加 main.go,就能开始写最小可运行的抓取逻辑。
先写一个最基础的 HTTP 抓取程序
对于入门场景,先不要急着上并发或复杂解析,先验证“能否成功请求网页并读出返回内容”。下面这段代码就是最小可运行示例,直接抓取指定 URL 的 HTML 内容:
package main

import (
    "fmt"
    "io/ioutil"
    "net/http"
)

func main() {
    url := "https://example.com"
    resp, err := http.Get(url)
    if err != nil {
        fmt.Println("Error fetching URL:", err)
        return
    }
    defer resp.Body.Close()
    body, err := ioutil.ReadAll(resp.Body)
    if err != nil {
        fmt.Println("Error reading response body:", err)
        return
    }
    fmt.Println(string(body))
}
这段程序完成了几个关键动作:向目标地址发起 GET 请求、读取响应体、输出 HTML 字符串,并对请求失败和读取失败分别做了错误处理。对于初次搭建环境的人来说,只要这一步能跑通,后面的解析与存储基本就是在此基础上叠加能力。
运行程序并确认抓取结果
在项目目录里执行下面的命令:
go run main.go如果程序正常工作,终端里会打印出目标页面的 HTML 内容。这一步的重点不是“输出是否好看”,而是确认整个链路已经打通:Go 环境可用、依赖正常、网络请求成功、响应体能够被读取。
一旦这里出现错误,排查顺序通常也很明确:先看 Go 是否安装成功,再看代码文件是否在当前目录,最后检查目标 URL 是否能访问。
用 goquery 解析 HTML 并提取链接
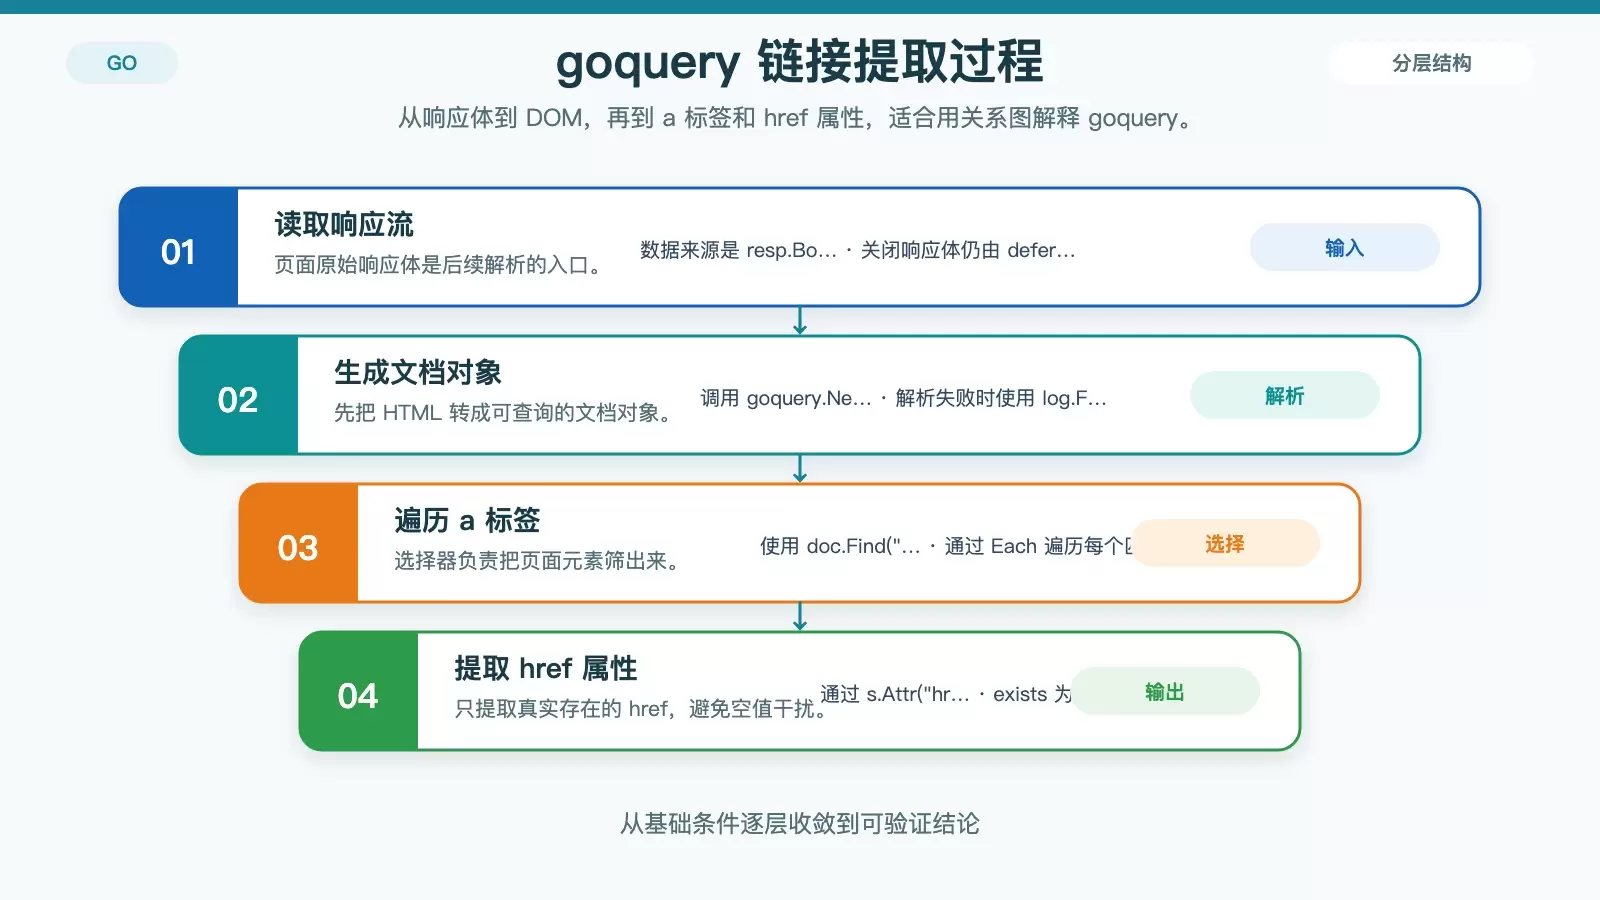
只拿到整页 HTML 往往还不够,实际爬虫通常需要从页面里提取结构化信息。这里可以引入 goquery,它的使用方式接近前端常见的 DOM 选择器,适合做初步页面解析。
安装 goquery
go get github.com/PuerkitoBio/goquery提取页面中所有 a 标签的 href
安装完成后,可以把 main.go 改成下面这样,直接遍历页面中的链接地址:
package main

import (
    "fmt"
    "log"
    "net/http"

    "github.com/PuerkitoBio/goquery"
)

func main() {
    url := "https://example.com"
    resp, err := http.Get(url)
    if err != nil {
        log.Fatal(err)
    }
    defer resp.Body.Close()

    doc, err := goquery.NewDocumentFromReader(resp.Body)
    if err != nil {
        log.Fatal(err)
    }

    doc.Find("a").Each(func(i int, s *goquery.Selection) {
        href, exists := s.Attr("href")
        if exists {
            fmt.Println(href)
        }
    })
}
这段代码与前面的基础版本相比,变化主要在两点:一是把响应体交给 goquery.NewDocumentFromReader 解析成文档对象;二是通过 doc.Find("a") 定位所有链接节点,再逐个输出 href 属性。
如果你的目标是采集文章链接、分页地址或导航入口,这种写法已经足够作为第一版原型。
从入门脚本到可用爬虫,还要补哪些能力
当基础抓取和 HTML 解析都能正常工作后,爬虫通常会继续往下面几个方向扩展:
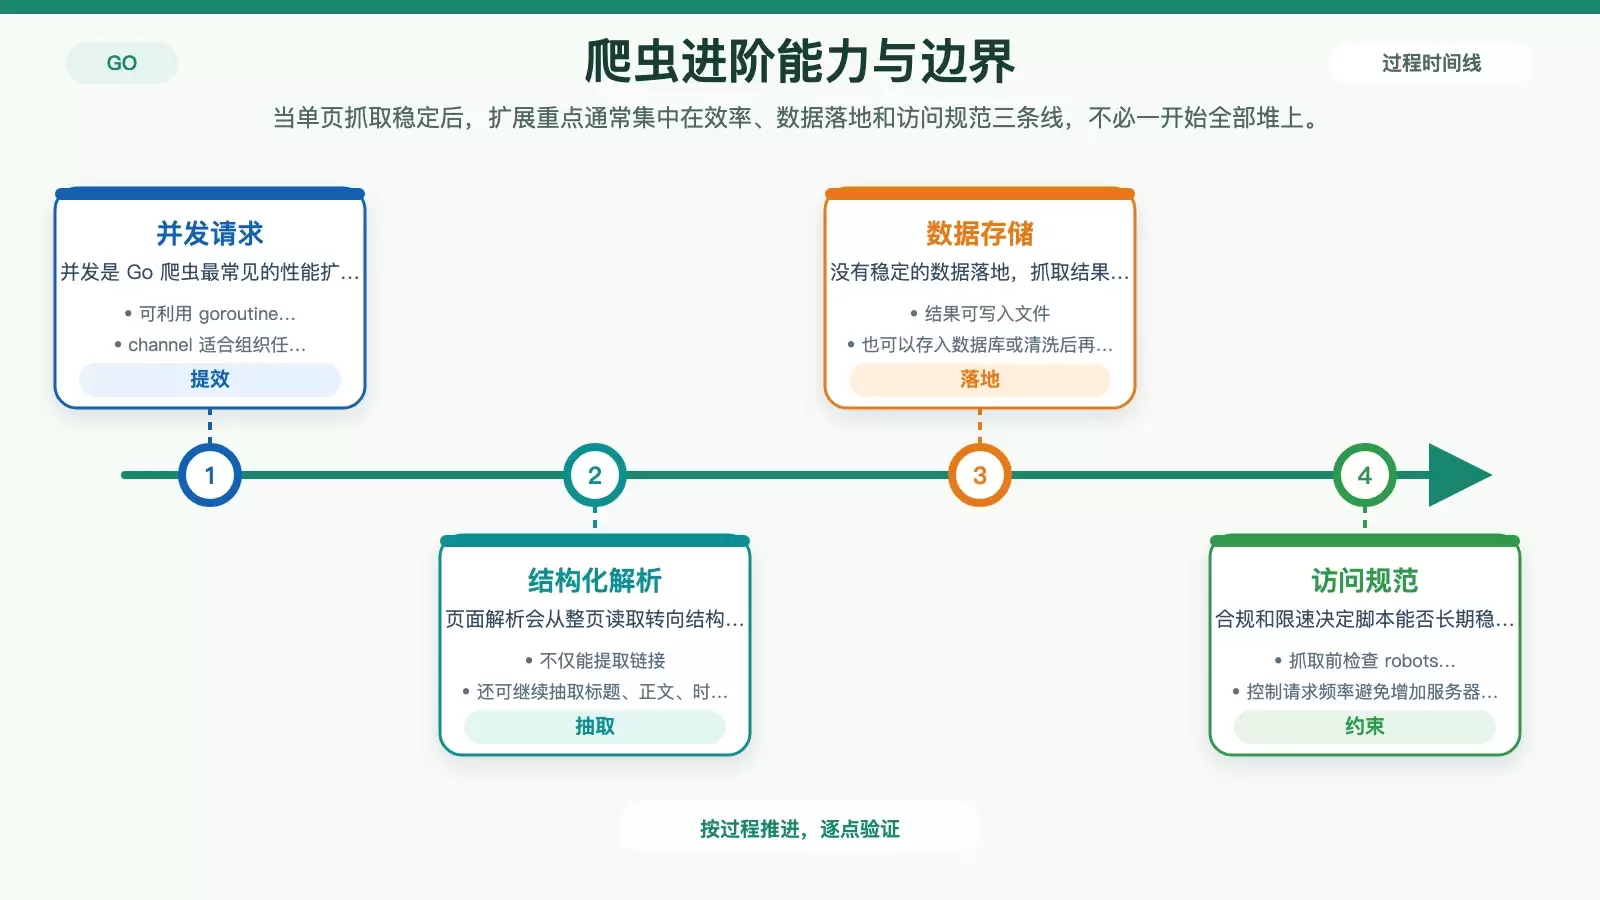
- 并发请求:利用 Go 的 goroutine 和 channel 同时抓取多个页面,可以明显提升吞吐效率。
- 数据存储:把抓到的结果写入文件、数据库,或者先做清洗再进入后续处理流程。
- 结构化抽取:除了链接,还可以提取标题、正文、时间、分页信息等具体字段。
这部分并不要求一开始就全部完成。更实际的做法是:先保证单页抓取稳定,再按业务需求逐项增加复杂度。这样出现问题时,也更容易判断是请求、解析还是存储环节出了偏差。
抓取前别忽略 robots.txt 和请求频率
技术上能抓,不代表就应该无节制地抓。正式运行前,至少要检查目标站点的 robots.txt,确认允许访问的范围;同时控制请求频率,避免对对方服务器造成不必要的压力。
这不仅是常见的爬虫礼仪,也是实际项目里减少封禁、限流和访问失败的重要前提。尤其在并发抓取场景下,请求速度一旦放开,很容易把原本可用的脚本变成高风险程序。
小结
在 Debian 上搭建一个 Golang 爬虫,起步流程可以压缩成几件事:安装 Go、初始化模块、完成一次 HTTP 请求、读取页面内容,再根据需求引入 goquery 做 HTML 解析。把这条基础链路跑通后,你再去增加并发、抽取规则和数据存储,整体会顺畅得多,也更容易定位问题。















