


小型Python脚本需要遵循软件设计原则吗

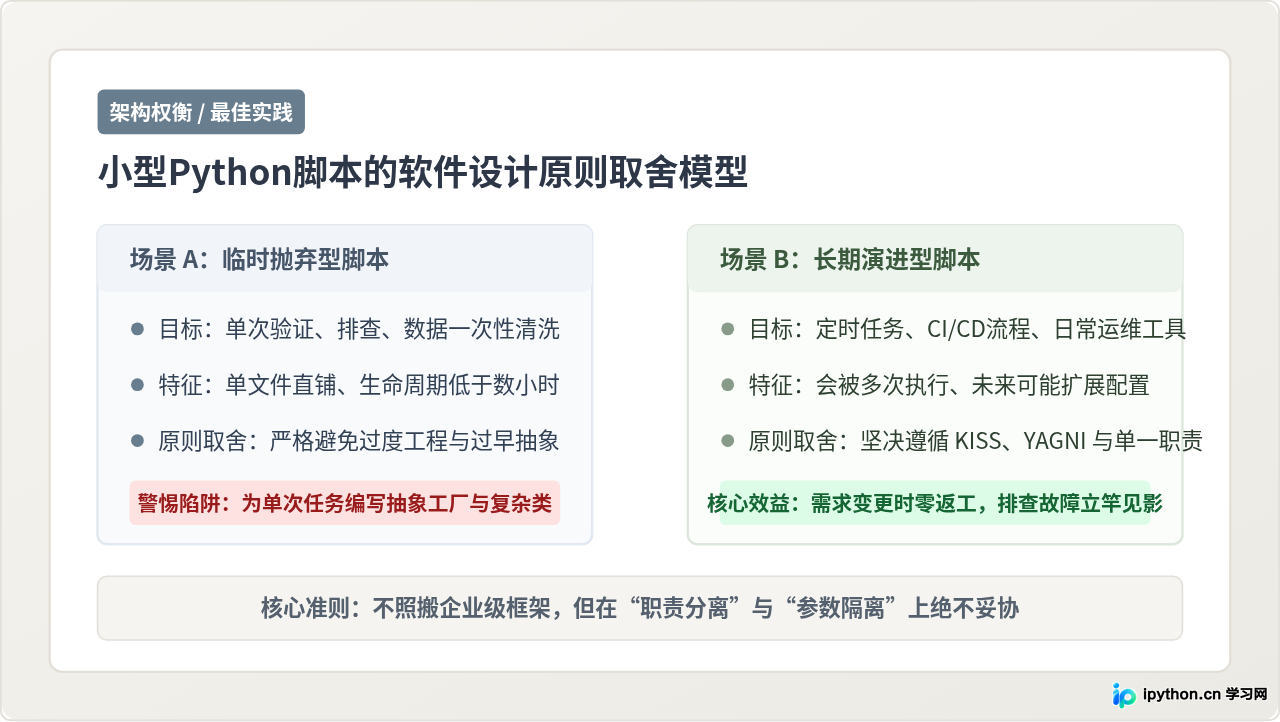
一、两种典型情境下的维护成本差异
为了清晰界定“软件设计原则对小型脚本是否有价值”,我们需要在完全一致的需求变更条件下,对比两种开发方式的实际反应:一种是“不考虑任何原则、单文件从头写到尾的线性流水账”,另一种是“仅遵循最简单一职责与参数解耦的轻量脚本”。
假设我们有一个初版仅有40行的小脚本,其核心功能是:从本地读取一份用户操作日志文件,筛选出所有发生超时的请求ID,并将结果追加保存到本地的CSV文件中。
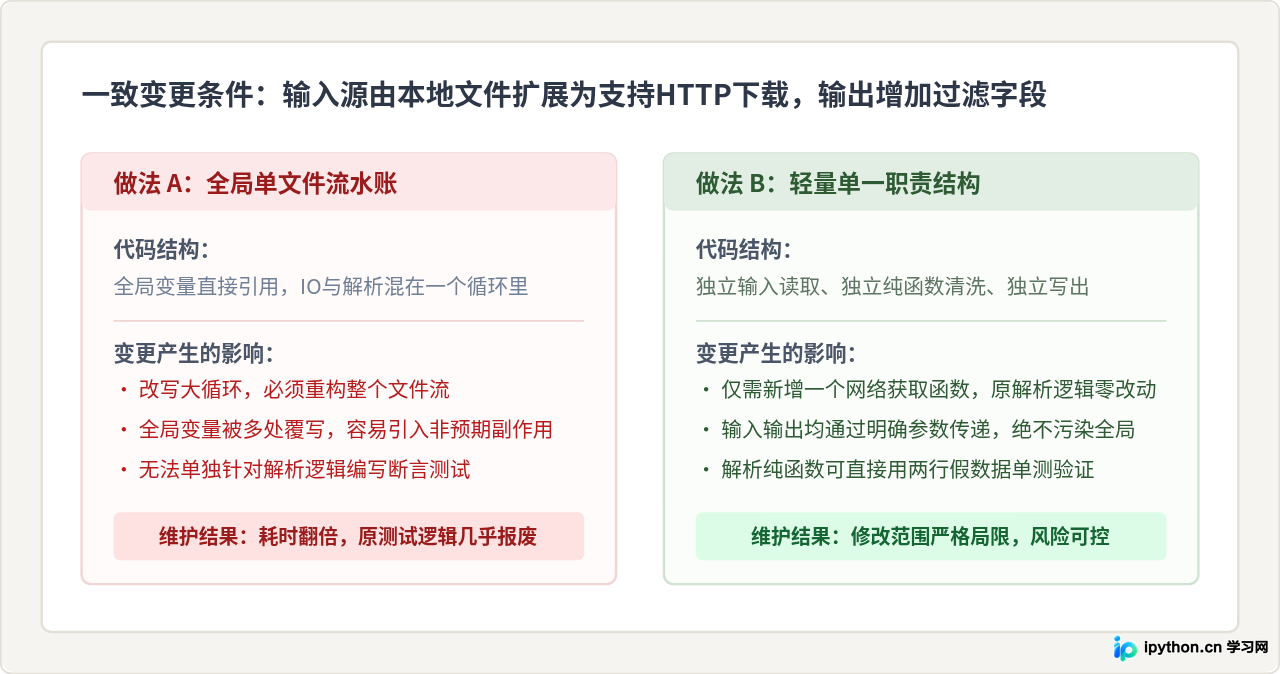
从上面的对比可以看出,差异的关键并不在于是否写了多余的类,而在于职责是否被混在了一起。无原则的脚本虽然写第一版时快了三分钟,但一旦需求稍微变动,修改者必须通读全文、重构循环,并且很容易破坏原有的处理细节。
二、哪些原则应当优先吸纳,哪些原则需要警惕
经典软件工程提出了许多原则,例如经典的SOLID原则(单一职责、开闭原则、里氏替换、接口隔离、依赖倒置)。对于小型Python脚本而言,照单全收只会走向过度工程的反面。我们需要对设计原则进行分层取舍。
| 设计原则 | 在小型脚本中的适用度 | 具体建议与边界 |
|---|---|---|
| KISS (保持简单直接) | 必须遵守(核心优先级) | 用最直接的内置数据结构(列表、字典、集合)解决问题,杜绝无意义的类分层。 |
| YAGNI (你不会需要它) | 必须遵守(核心优先级) | 只写当前用得到的功能,不预先写多余的通用适配器、动态插件机制或过早配置项。 |
| SRP (单一职责原则) | 高度推荐(轻量遵守) | 函数粒度拆分:让“读取数据”、“清洗转换”、“保存结果”分别属于独立函数。 |
| DRY (不要自我重复) | 适度遵守 | 避免大段复制粘贴逻辑;但在只有两处相似的小脚本中,适度重复优于过早抽象。 |
| OCP / DIP (开闭与依赖倒置) | 谨慎遵守(暂缓引入) | 小型脚本不需要定义抽象基类(ABC)和依赖注入容器,通过函数传参即可达到解耦目的。 |
三、代码重构对比:从紧耦合到清晰职责
下面我们通过具体的Python代码演示这种轻量级设计原则的落地过程。
1. 典型的紧耦合反模式实现(无原则代码)
# process_logs_bad.py
# 缺点:配置硬编码、IO与清洗混杂、全局直接执行、无异常隔离
import csv

input_file = "raw_events.log"
output_file = "filtered_events.csv"

# 直接在全局范围执行,无法被导入测试
rows = []
with open(input_file, "r", encoding="utf-8") as f:
    for line in f:
        # 业务解析与字符串清洗混在一起
        parts = line.strip().split(" - ")
        if len(parts) >= 3 and "TIMEOUT" in parts[2]:
            event_id = parts[0].strip("[]")
            duration = float(parts[2].split("=")[-1].replace("ms", ""))
            rows.append([event_id, duration])

with open(output_file, "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["event_id", "duration_ms"])
    writer.writerows(rows)

print("处理完成,共写入条目数:", len(rows))
2. 遵循轻量设计原则后的重构实现
我们不需要定义任何复杂的类,只需将代码按“参数定义”、“读取与转换”、“写出结果”三个单一职责函数进行拆解,并加上标准的入口保护。
# process_logs_clean.py
# 优点:单一职责、纯函数易测、配置外置、安全入口
import csv
import sys
from pathlib import Path
from typing import List, Tuple

def parse_timeout_event(line: str) -> Tuple[str, float] | None:
    """单一职责:解析单行日志文本,返回结构化元组。纯函数,不进行磁盘IO。"""
    parts = line.strip().split(" - ")
    if len(parts) >= 3 and "TIMEOUT" in parts[2]:
        event_id = parts[0].strip("[]")
        duration_str = parts[2].split("=")[-1].replace("ms", "")
        return event_id, float(duration_str)
    return None

def extract_timeout_records(file_path: Path) -> List[Tuple[str, float]]:
    """单一职责:负责文件读取与收集,委托解析函数完成转换。"""
    records = []
    with file_path.open("r", encoding="utf-8") as f:
        for line in f:
            if parsed := parse_timeout_event(line):
                records.append(parsed)
    return records

def save_to_csv(records: List[Tuple[str, float]], target_path: Path) -> None:
    """单一职责:负责将结构化记录可靠写入目标文件。"""
    target_path.parent.mkdir(parents=True, exist_ok=True)
    with target_path.open("w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["event_id", "duration_ms"])
        writer.writerows(records)

def main() -> None:
    """编排主流程,管理输入输出参数。"""
    input_path = Path("raw_events.log")
    output_path = Path("filtered_events.csv")

    if not input_path.exists():
        print(f"错误: 找不到输入文件 {input_path}", file=sys.stderr)
        sys.exit(1)

    records = extract_timeout_records(input_path)
    save_to_csv(records, output_path)
    print(f"处理完成,共成功提取 {len(records)} 条超时记录。")

if __name__ == "__main__":
    main()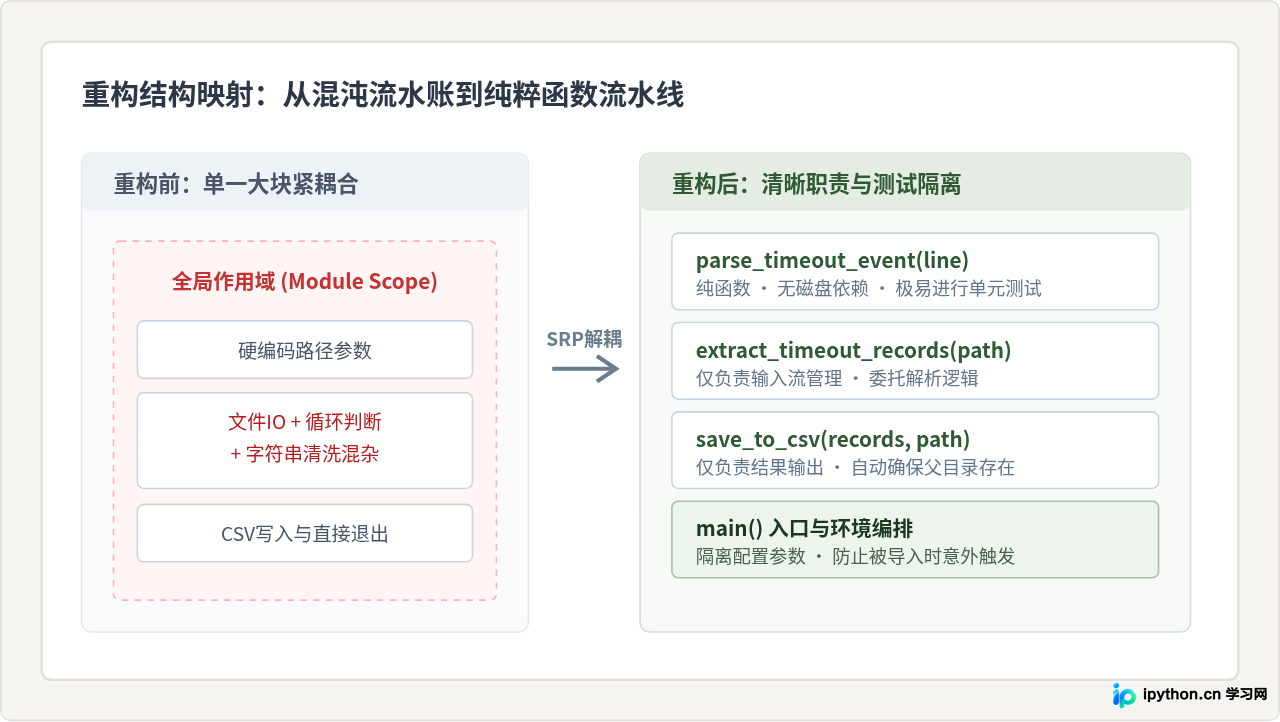
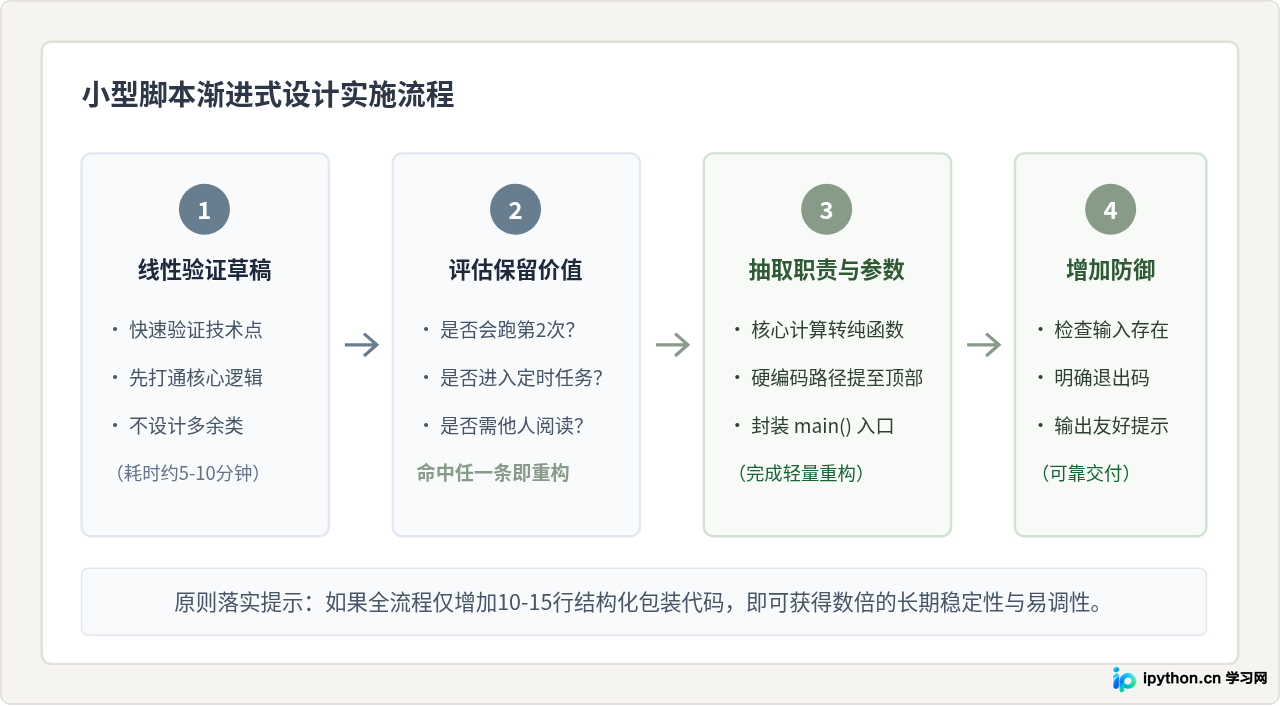
四、小型脚本引入设计原则的决策与操作步骤
在实际编写脚本时,无需一开始就设计完备架构。遵循“渐进演进”的操作步骤,可以在开发效率与代码质量之间找到最佳平衡:
执行与验证示例
在终端中运行规范化后的脚本时,应当具有明确的标准输出与错误流反馈。例如在缺少输入文件时:
$ python3 process_logs_clean.py
错误: 找不到输入文件 raw_events.log
$ echo $?
1
当准备好合法的测试数据时:
$ cat raw_events.log
[EVT-1001] - 2026-10-10 10:00:01 - STATUS=TIMEOUT duration=1500ms
[EVT-1002] - 2026-10-10 10:00:02 - STATUS=SUCCESS duration=20ms
[EVT-1003] - 2026-10-10 10:00:05 - STATUS=TIMEOUT duration=2300ms

$ python3 process_logs_clean.py
处理完成,共成功提取 2 条超时记录。

$ head -n 3 filtered_events.csv
event_id,duration_ms
EVT-1001,1500.0
EVT-1003,2300.0
五、小型脚本必须规避的三个常见陷阱
-
滥用面向对象,导致结构膨胀:
许多开发者误以为“遵循软件设计原则”就等于“必须写类(class)”。在小型脚本中,如果一个类内部只有
__init__和一个方法,或者类属性在全局只被实例化一次,直接将其写为普通函数通常更为清晰直接。 -
吞掉异常或裸写
except: pass: 为了让脚本“不报错中断”,有些开发者习惯使用宽泛的异常捕获。这会导致网络失败、文件权限缺失或语法错误全部被静默掩盖,给后续排查带来巨大痛苦。只捕获可预期的具体异常,其余异常应让其正常抛出并附带堆栈。 -
在全局作用域中直接执行代码:
没有
if __name__ == "__main__":保护的脚本,无法被任何外部测试文件直接导入其中的某个函数。一旦你想给核心解析逻辑写一个测试用例,导入模块的同时就会立即触发文件读写与打印,导致测试完全不可行。
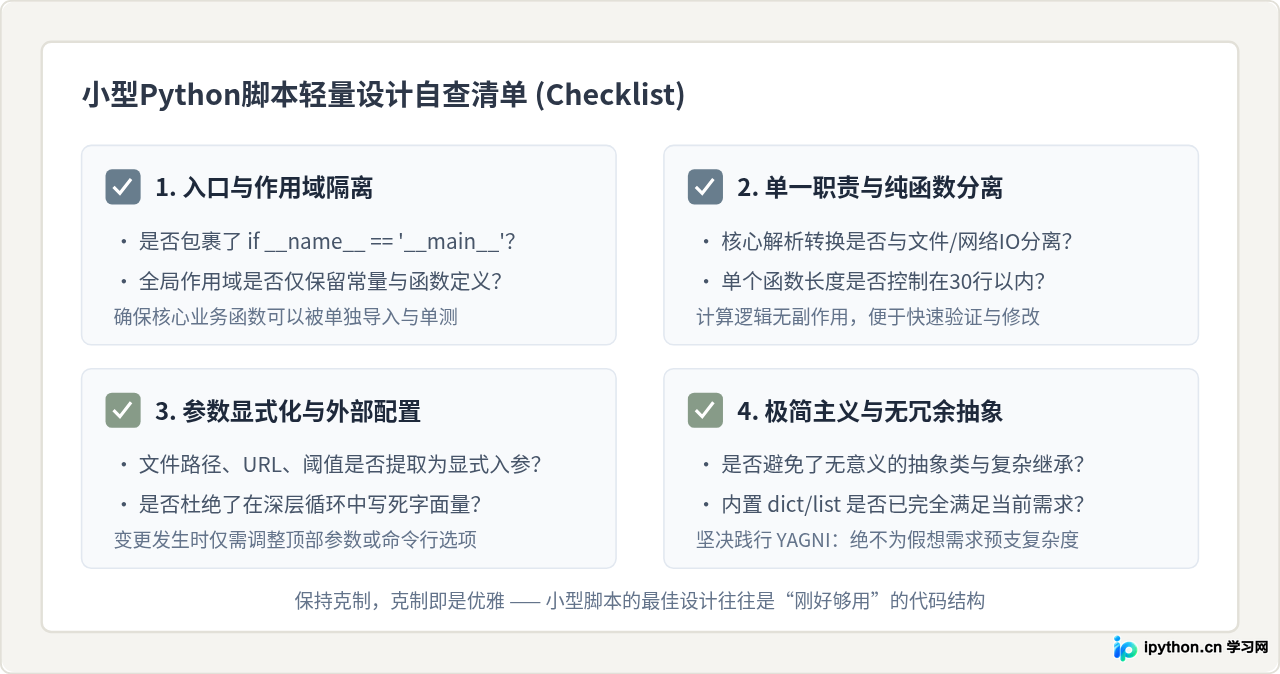
六、总结与实践自查清单
回顾最初的问题:“小型Python脚本需要遵循软件设计原则吗?”
答案是:需要遵循,但必须经过审慎裁剪。 小型脚本的灵魂在于敏捷与简洁,遵循设计原则的终极目的从来不是“展示架构技巧”,而是“用最低的认知成本保证代码能够平稳运行、并在必要时能够被轻松修改”。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















