


Python基础语法详解:变量、数据类型与控制流结构

掌握任何一门编程语言,核心在于理清其基础构件的运作逻辑。在Python中,编写逻辑清晰、运行稳健程序的基石由三部分构成:变量的引用机制、内置数据类型的分类与特性,以及组织代码执行顺序的控制流结构。本文将抛弃繁杂概念,直接从内存引用机制、常用数据形态到条件与循环控制展开细致剖析,帮助读者建立端到端的Python语法认知模型。
一、变量:动态类型与对象引用机制
在C或Java等静态类型语言中,定义变量通常需要声明类型(例如 int a = 10;),此时变量就像一个固定大小的盒子,只能存放指定规格的数据。而Python采用的是“动态类型”与“基于引用的对象模型”。
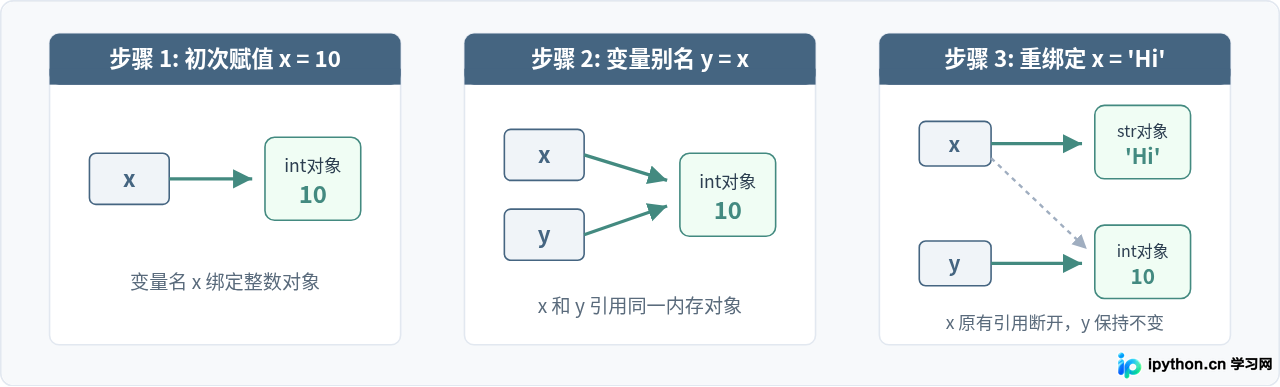
在Python中,等号 = 并非单纯的值复制,而是建立名称与内存中对象的绑定关系。变量名本身并不拥有类型,拥有类型的是变量所指向的对象。
# 变量赋值示例
x = 10        # 在内存中创建整数对象 10,并将变量名 x 指向该对象
x = "Python"  # x 重新绑定到字符串对象 "Python",原整数对象等待垃圾回收机制处理
y = x         # y 同样指向 "Python" 对象,两者共享同一内存地址
为了直观展现变量绑定的演进步骤,下方图示演示了变量赋值、重命名及重新绑定过程中底层引用的变化流程。
user_count、total_price);常量全大写(如 MAX_RETRIES);禁止以数字开头或使用 Python 保留关键字(如 if、class、def)。
二、核心数据类型体系与可变性分类
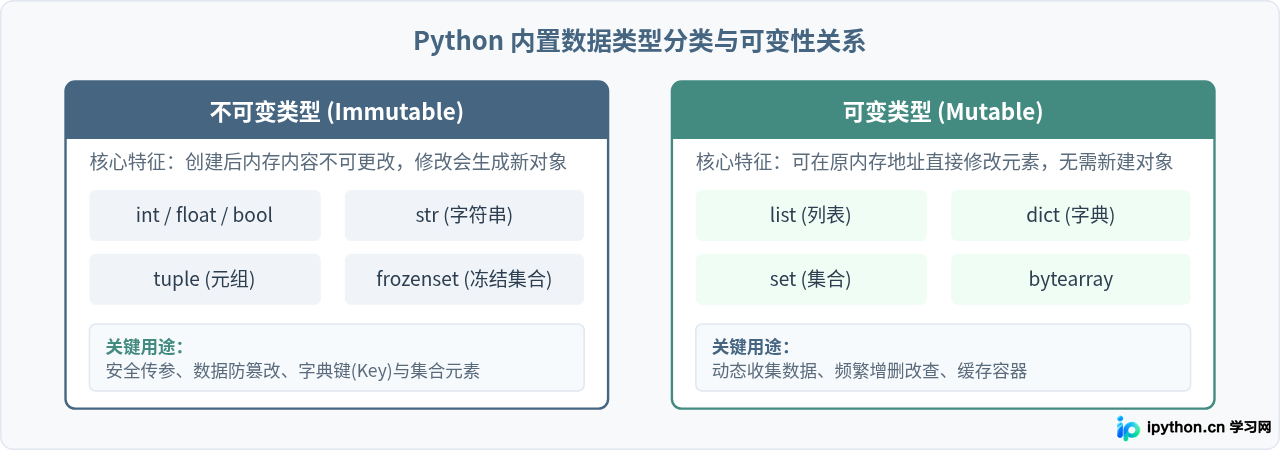
Python 具备丰富且表达力极强的内置数据类型。按结构可分为基础标量与复合容器,而按内在行为分类,则极其关键地划分为不可变类型(Immutable)与可变类型(Mutable)。
1. 基础标量类型
- 整数(int):在 Python 3 中整数支持任意精度运算,不会出现传统 32/64 位语言的溢出问题。
- 浮点数(float):双精度浮点表示,适用于带小数计算(注意二进制浮点数固有的微小精度偏差)。
- 布尔值(bool):包含
True和False,本质是整数1和0的子类。 - 空值(NoneType):唯一常量
None,用于表达“缺失”、“无返回值”或“未初始化”。
2. 复合序列与容器类型
- 字符串(str):字符序列,属于不可变类型。任何拼接或替换操作均产生新字符串。
- 列表(list):有序且支持任意类型的可变序列,使用方括号声明,如
[1, "abc", 3.14]。 - 元组(tuple):有序但不可变的序列,使用圆括号声明,如
(10, 20),常用于固定参数传递与多值返回。 - 字典(dict):键值对映射集合,键必须是不可变哈希对象,查询时间复杂度为 O(1)。
- 集合(set):无序且不重复的元素集合,支持交集、并集和差集等数学运算。
理解“可变与不可变”是避免代码逻辑出现偶发性缺陷的核心所在。如下方关系矩阵所示:
以下代码清晰地展示了可变对象原地修改带来的影响:
# 可变对象行为演示
list_a = [1, 2, 3]
list_b = list_a          # 两个变量指向同一底层列表
list_b.append(4)         # 原地修改列表内容

print(f"list_a: {list_a}")  # 示例输出: list_a: [1, 2, 3, 4]
print(f"list_b: {list_b}")  # 示例输出: list_b: [1, 2, 3, 4]
三、控制流:条件分支判断与决策流程
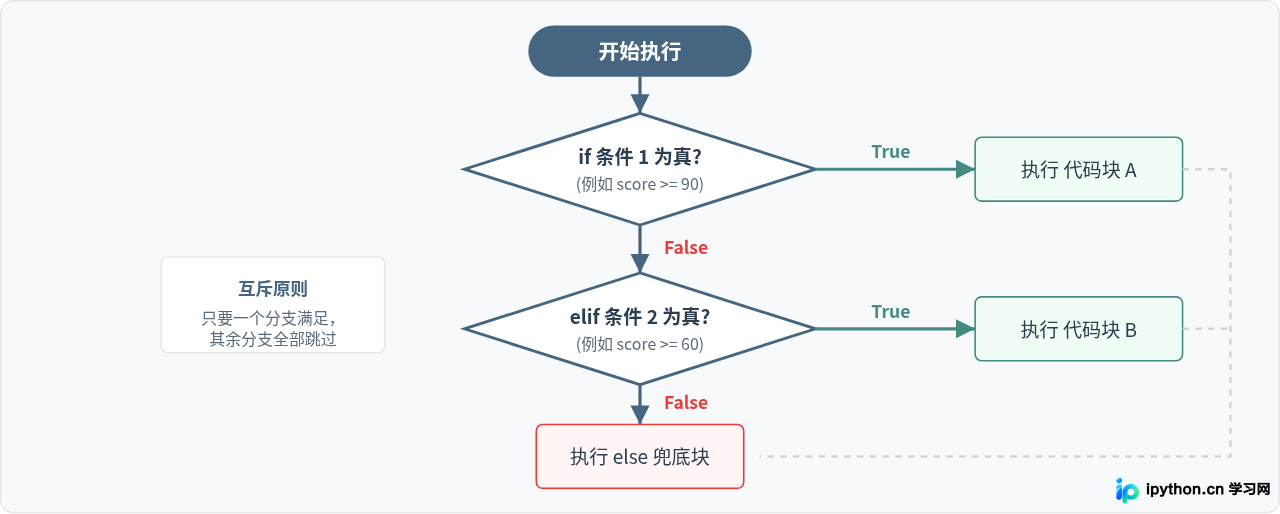
计算机程序的智能体现在对不同情境做出不同反应。Python 依靠 if、elif 和 else 语句驱动分支逻辑。在结构书写上,Python 严格遵循缩进机制(通常为 4 个空格),取消了传统的大括号 {}。
在条件判断中,除了显式的比较操作符(>、<、==、!=)外,Python 还内建了“真值测试(Truthy / Falsy)”规则:数字 0、空字符串 ""、空列表 []、空字典 {}、空元组 () 以及 None 在条件评估中均自动视为 False;其余非空对象则评估为 True。
下面的流程图清晰还原了一个具备多级校验逻辑的条件决策执行路径:
落地到实际场景的代码示范:
# 条件控制具体示例
score = 85

if score >= 90:
    grade = "A"
elif score >= 75:
    grade = "B"
elif score >= 60:
    grade = "C"
else:
    grade = "D"

print(f"最终评级: {grade}")  # 示例输出: 最终评级: B
四、控制流:循环迭代与控制指令
在处理重复任务或批量数据时,Python 提供了两种主要循环形式:针对可迭代对象的 for 循环,以及基于布尔状态检查的 while 循环。
1. for ... in 迭代循环
Python 的 for 循环实际上是迭代器协议的优雅封装。它能够直接遍历字符串、列表、元组、字典与文件对象,而无需通过下标索引手动递增。
# 遍历列表
fruits = ["apple", "banana", "orange"]
for item in fruits:
    print(f"当前水果: {item}")

# 结合 range() 进行固定次数或索引遍历
for i in range(1, 4):
    print(f"第 {i} 次迭代")
2. while 条件循环
当迭代次数未知,仅依赖某个运行条件时使用。务必确保循环体内有促使条件向 False 推进的语句,否则将陷入死循环。
# while 循环计数
retry_count = 0
while retry_count < 3:
    print(f"尝试连接... 当前计数: {retry_count}")
    retry_count += 1
3. break、continue 与循环专属 else
break:立即强制终止并跳出当前整层循环。continue:放弃本次循环尚未执行的剩余代码,直接进入下一次迭代。- 循环
else:当循环自然迭代完毕(未被break强行打断)时执行,极适合用于“搜索若未找到则处理”的场景。
五、综合总结:Python 核心语法全景体系
在实际编码中,变量、数据类型与控制流绝非孤立存在,而是紧密结合。数据结构决定了信息的存储形态,变量提供了对数据的索引与生命周期引用,而控制流负责对这些数据进行状态判断、筛选过滤与批量转换。
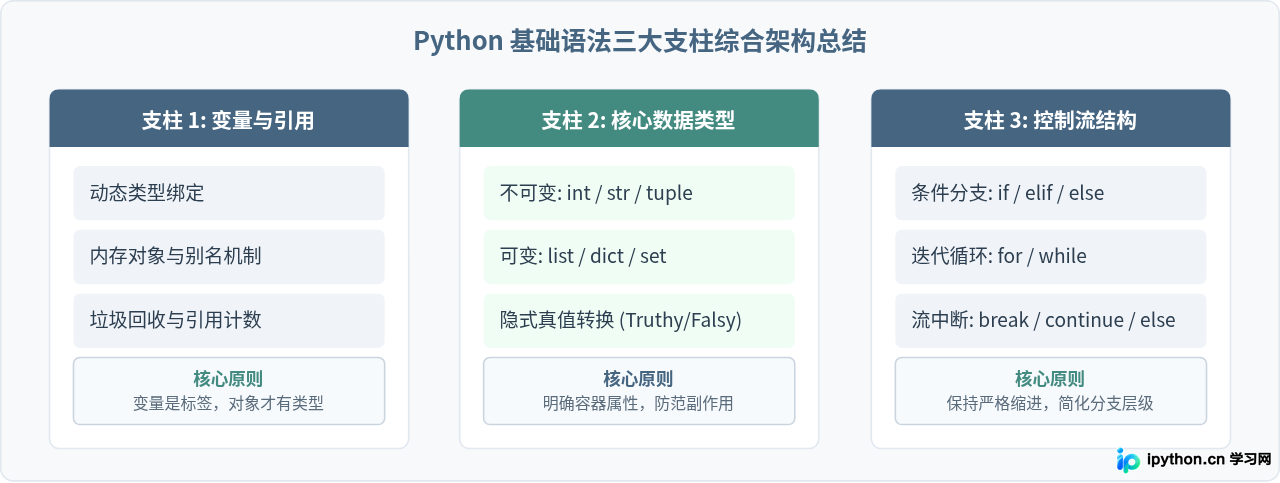
综上所述,写好 Python 基础代码的关键可以归纳为三点:
- 始终清楚变量指向的具体对象类型,并在处理复合数据时区分其是否可原地修改。
- 善用可迭代对象与
for ... in惯用语法替代传统的计数器循环,提升代码的紧凑度与可读性。 - 遵循 PEP 8 缩进与命名约定,保持条件判断与分支逻辑的扁平与直观。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















