


Python pathlib模块怎么实现文件拷贝

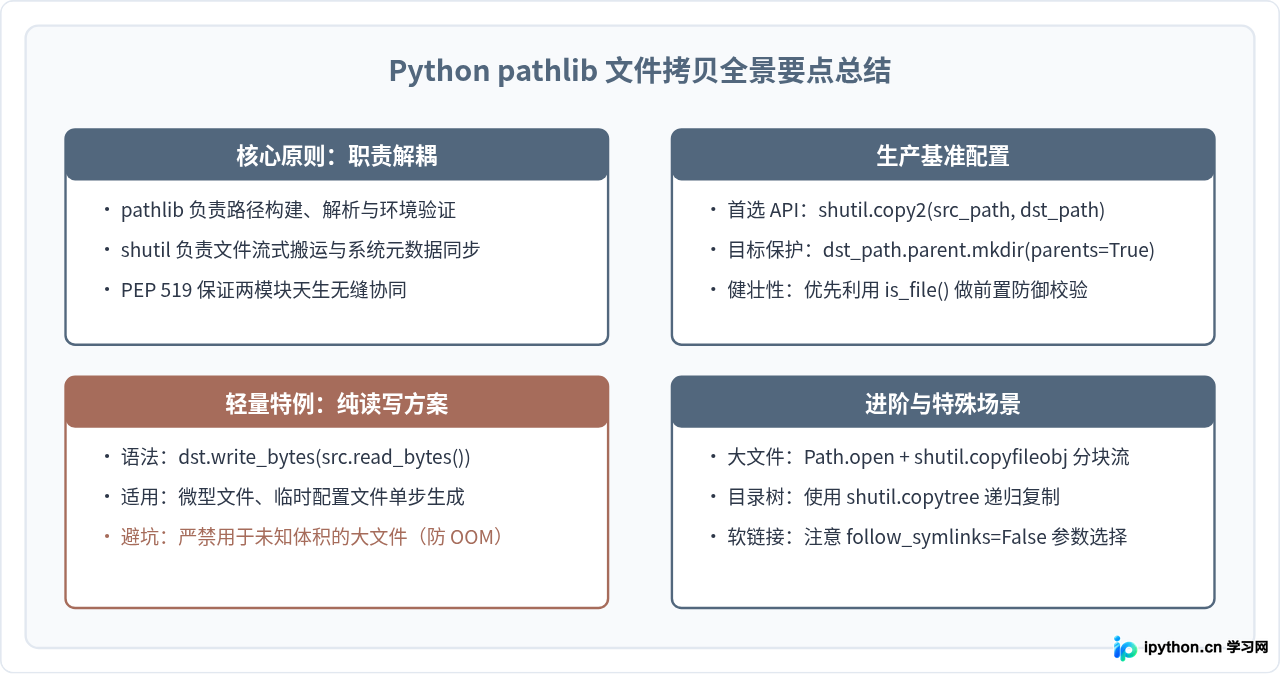
在 Python 的文件操作体系中,pathlib 提供了优雅且面向对象的路径处理体验,但很多开发者在试图直接调用类似于 path.copy() 的方法时会发现,pathlib.Path 对象本身并没有内置专门的高级拷贝函数。核心结论是:实现文件拷贝的最稳健方案,是将 pathlib.Path 与标准库 shutil 模块组合使用;在仅需处理极小文件的纯内容拷贝场景下,也可以直接利用 Path.read_bytes() 和 Path.write_bytes() 快速完成。
一、为什么 pathlib 没有提供 Path.copy() 方法
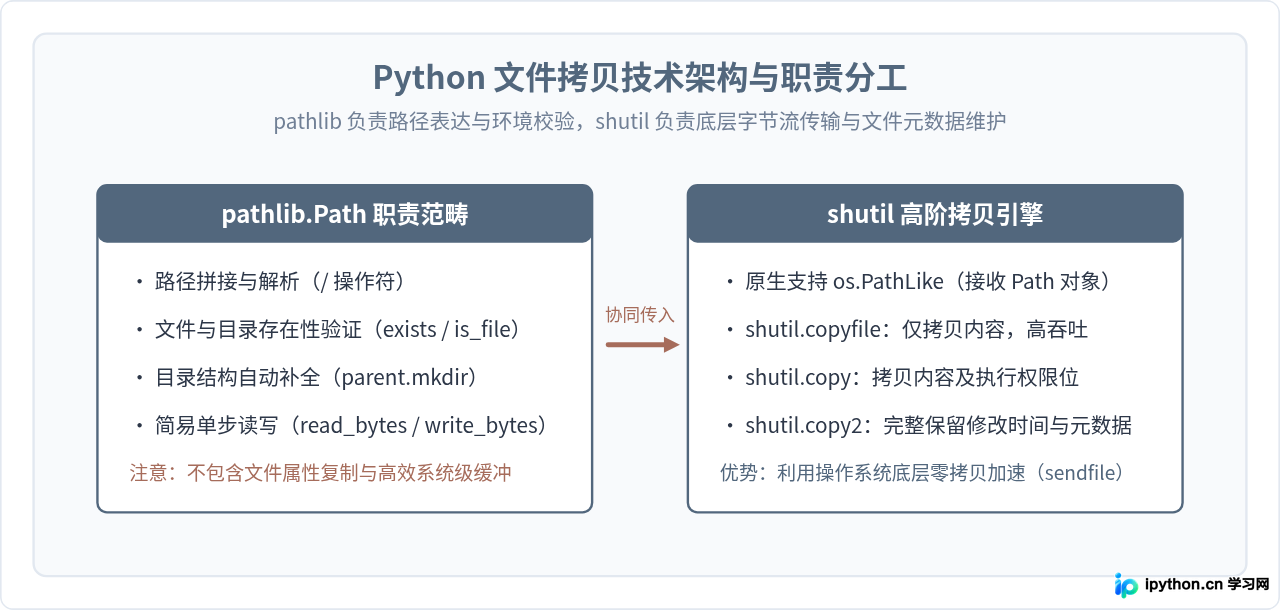
很多刚从其他语言转向 Python 的开发者常对 pathlib 缺少 Path.copy() 感到困惑。这其实是 Python 标准库的明确设计哲学:
- 功能单一原则:
pathlib的设计定位是作为文件系统路径的“抽象与计算工具”(纯路径运算及基础单项文件系统调用),避免将复杂的I/O缓冲策略与繁重的元数据同步绑定在基础对象上。 - 已有专职模块:Python 标准库中早已存在成熟稳定的高阶文件操作模块
shutil(Shell Utilities)。自 Python 3.6 起引入了PEP 519(文件系统路径协议),shutil的全部函数均已原生支持Path对象。 - 保持底层与高阶分离:文件拷贝在底层涉及普通内容复制、权限标志保留、创建及修改时间同步、扩展属性乃至软符号链接解析等多种复杂策略,交给
shutil集中处理更加严谨。
二、主流实现方案一:pathlib 协同 shutil(生产环境首选)
在实际项目开发中,最推荐的做法是利用 Path 构建和校验路径,然后直接传给 shutil.copy2() 或 shutil.copy()。
1. 完整保留元数据的拷贝(shutil.copy2)
shutil.copy2() 是绝大多数业务场景下的第一选择。它不仅复制文件内容,还会尽可能保留源文件的时间戳(访问时间与修改时间)以及权限标记。
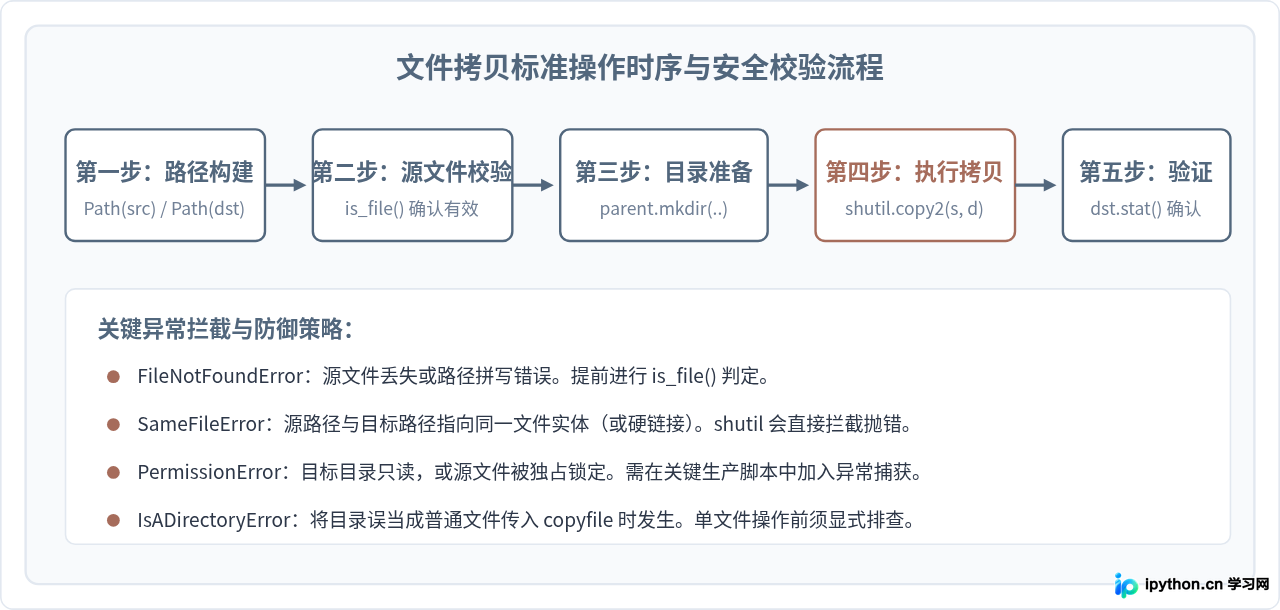
from pathlib import Path
import shutil

source_path = Path("/data/reports/summary.xlsx")
target_path = Path("/backup/reports/summary_bak.xlsx")

# 1. 确保源文件存在且为普通文件
if not source_path.is_file():
    raise FileNotFoundError(f"源文件不存在或非普通文件: {source_path}")

# 2. 确保目标目录已存在,如不存在则级联自动创建
target_path.parent.mkdir(parents=True, exist_ok=True)

# 3. 执行拷贝(直接传入 Path 对象)
copied_file = shutil.copy2(source_path, target_path)

print(f"成功拷贝并保留元数据至: {copied_file}")
shutil.copy2 的目标参数可以是完整的目标文件路径,也可以是已存在的目标目录。如果目标是目录,新文件会保持原文件名放置在该目录下。
2. 仅拷贝内容与基本权限(shutil.copy)与纯内容拷贝(shutil.copyfile)
| API 名称 | 源与目标要求 | 内容复制 | 权限保留 | 元数据(时间戳) |
|---|---|---|---|---|
shutil.copyfile(src, dst) |
两者均必须为完整文件路径 | 是 | 否 | 否(刷新为当前时间) |
shutil.copy(src, dst) |
dst 可为目录或完整文件路径 | 是 | 是(保留可执行等权限) | 否(刷新为当前时间) |
shutil.copy2(src, dst) |
dst 可为目录或完整文件路径 | 是 | 是 | 是(尽可能完整保留) |
三、主流实现方案二:使用 Path 原生读写方法(小文件独立方案)
如果你的场景非常轻量(例如小型配置文件、临时日志片段、几 KB 的 JSON 或文本),并且脚本严格限制不能引入额外模块,或者无需保留文件的时间戳和特定系统权限,可以直接用 pathlib 自身的方法实现纯内容复制。
1. 二进制读写直通(适用于微型文件)
from pathlib import Path

src = Path("config.json")
dst = Path("config_backup.json")

# 一行代码完成纯数据二进制拷贝
dst.write_bytes(src.read_bytes())
机制与局限:src.read_bytes() 会将整个文件的数据一次性读入 Python 进程内存,接着 dst.write_bytes() 打开目标文件并完整覆写。对于小于几十兆的文件,这种写法非常方便;但如果文件达到数百兆甚至数吉字节(GB),会导致内存瞬间飙升甚至触发操作系统 OOM(内存溢出)异常,因此不可用于不确定大小的未知文件。
2. 文本模式写入(注意编码问题)
# 文本文件需显式指定统一编码,防止跨平台乱码
dst.write_text(src.read_text(encoding="utf-8"), encoding="utf-8")
通常情况下更推荐使用 write_bytes 进行文件复制,因为以文本模式打开二进制文件(如图片、可执行文件)会导致编码解码错误甚至破坏文件内部结构。
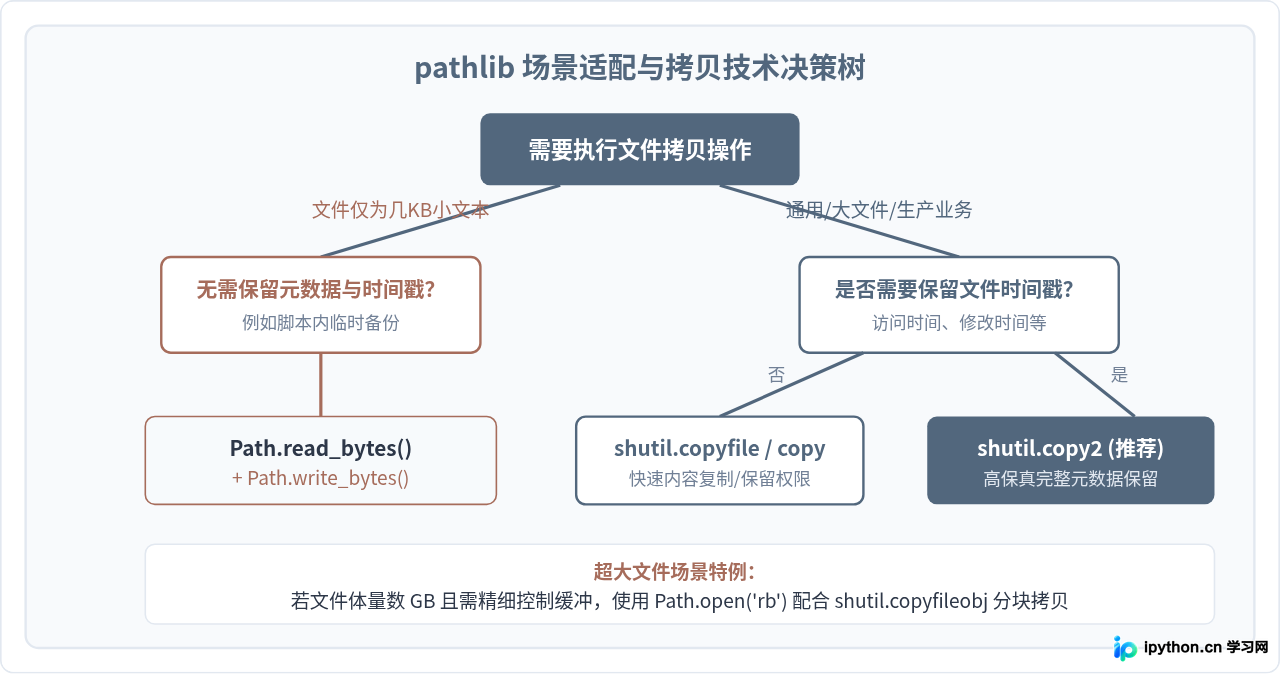
四、方案选型决策图
在面对不同体量、不同系统平台及不同业务需求时,应合理评估拷贝方案:
五、超大文件流式处理与细粒度拷贝
当处理数 GB 的数据库转储文件或视频素材时,如果需要对读取与写入缓冲区进行细粒度控制,可以组合使用 Path.open() 与 shutil.copyfileobj():
from pathlib import Path
import shutil

src_large = Path("/var/log/system_large.dump")
dst_large = Path("/backup/logs/system_large.dump")

dst_large.parent.mkdir(parents=True, exist_ok=True)

# 缓冲区设置为 16MB(默认通常为 64KB)
BUFFER_SIZE = 16 * 1024 * 1024

with src_large.open("rb") as fsrc, dst_large.open("wb") as fdst:
    shutil.copyfileobj(fsrc, fdst, length=BUFFER_SIZE)

print("大文件分块流式拷贝完成")
六、实践中的常见问题与避坑指南
-
目标路径必须显式确保父级目录存在:
无论使用
shutil还是Path,如果目标文件所在的父级目录尚未创建,操作系统都会直接抛出FileNotFoundError。因此在调用拷贝前,养成执行dst.parent.mkdir(parents=True, exist_ok=True)的习惯至关重要。 -
注意目录拷贝的 API 区分:
本文讨论的是单文件拷贝。如果需要递归拷贝整个文件夹及其子目录,应该使用
shutil.copytree(src_dir, dst_dir),而不能对目录直接调用shutil.copy2。 -
符号链接(Symlink)的行为差异:
默认情况下,
shutil.copy2会跟随软链接(follow symlinks),即拷贝链接所指向的真实物理文件内容。如果需要拷贝软链接本身而不是实际目标文件,应显式传入follow_symlinks=False参数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















