


Python自动化脚本入门:常用库推荐与第一个脚本编写
本文系统介绍Python自动化脚本的基础概念、核心库选型以及编写实战。通过详细讲解文件操作、表格处理、网络抓取与定时调度的常用库,并带您手把手编写第一个自动分类整理文件的自动化脚本,掌握生产级避坑指南。
一、自动化脚本的工作模型与核心价值
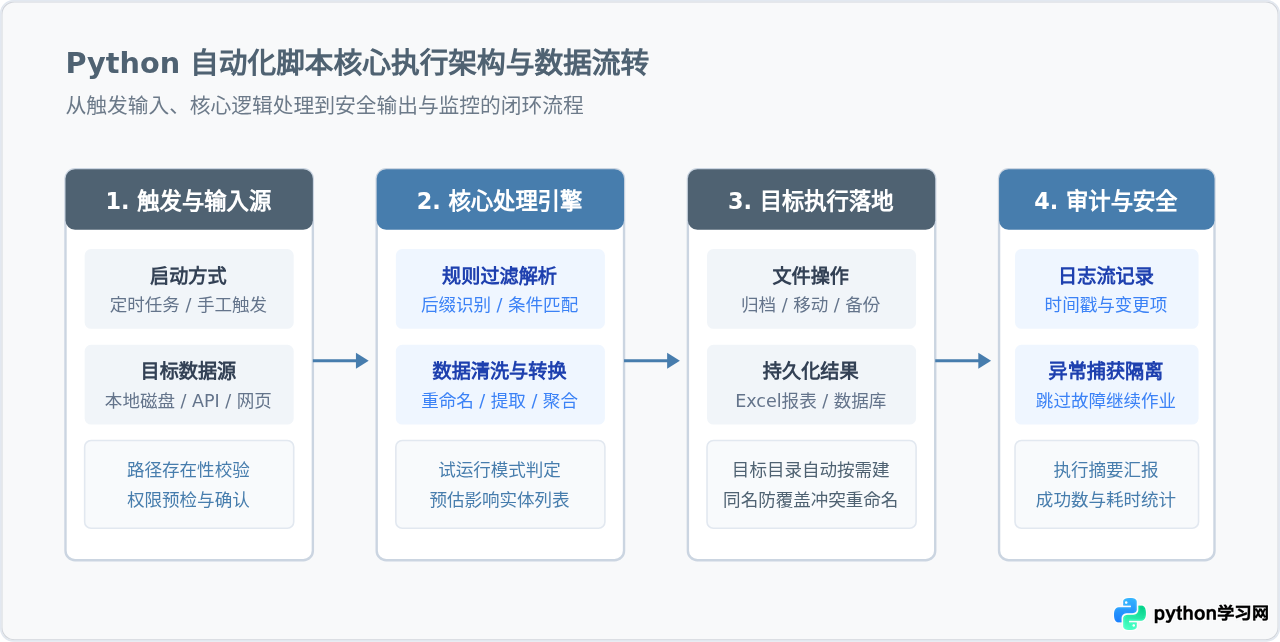
很多初学者常将自动化脚本与庞大的软件开发混淆。自动化脚本通常目标专注、逻辑单一,核心任务是在无人工干预或低人工干预的情况下完成固定的数据处理。一个稳健的自动化脚本通常由四个阶段构成:
- 触发与输入源:通过定时器、目录变动监控或手动单次命令启动,读取目标文件夹、本地文件或网络接口。
- 核心转换逻辑:根据业务规则进行过滤、提取、清洗、归类或计算。
- 目标端写入:将处理结果移动至新路径、写入 Excel 报表或调用下游服务接口。
- 状态反馈与防御:通过试运行检查(Dry Run)、文件同名覆写防御以及日志追溯,确保脚本不会损坏既有数据。
二、Python 常用自动化库推荐与应用场景选型
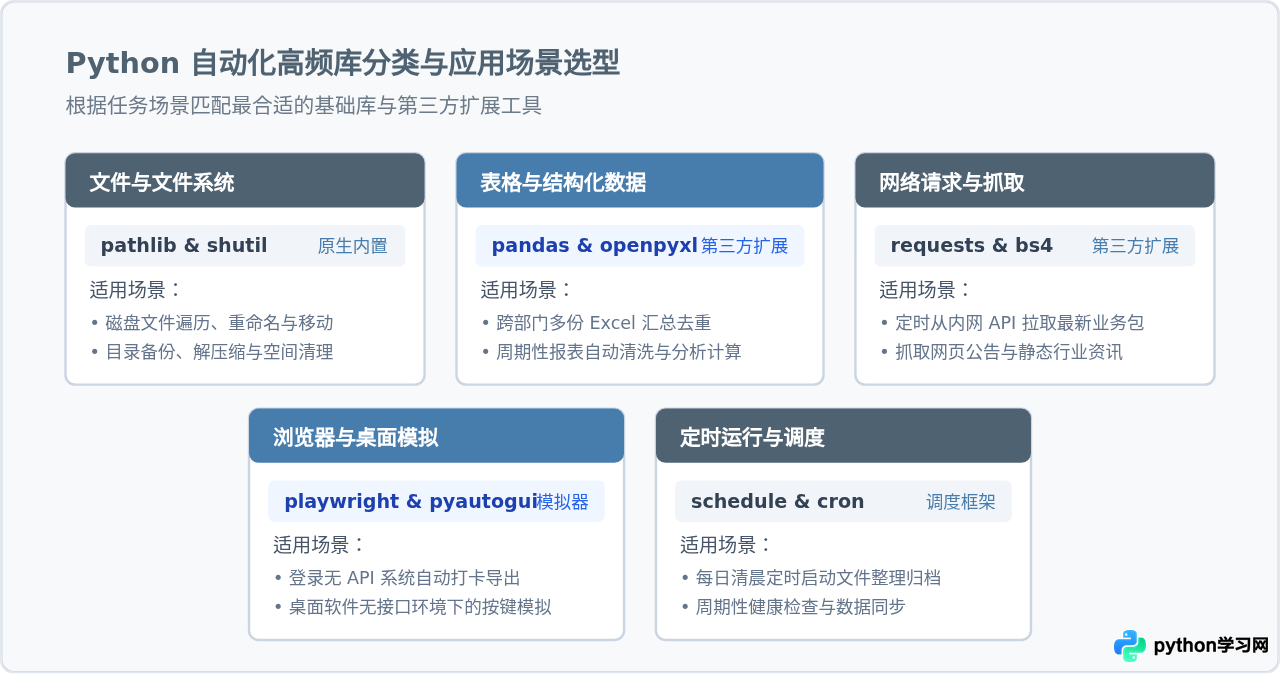
Python 之所以在自动化领域占据主导地位,关键在于其丰富的标准库和第三方生态。在开始编写具体脚本前,按任务属性选用最恰当的库,能节省大量重复开发时间。
1. 文件与操作系统管理
对于本地文件批量重命名、移动、解压缩等任务,优先使用 Python 原生内置模块,无需安装额外依赖:
pathlib:面向对象的文件系统路径库(Python 3.4+ 内置),大幅简化路径拼接、后缀提取和目录遍历,推荐作为路径处理的首选。shutil:提供高级别的文件操作功能,如shutil.move()(移动文件)、shutil.copy2()(保留元数据的文件复制)和目录树压缩解压。os:用于读取系统环境变量、工作路径探测及执行底层操作系统调用。
2. 办公文档与表格处理
当需要自动化整理业务报表、合并多个 Excel 文件或生成周期性摘要时:
openpyxl:专门用于读写 Excel 2010+ 格式文件(.xlsx),支持对单元格样式、公式和图表的细粒度控制。pandas:处理多行多列结构化数据的标准库。若需要清洗海量 CSV、按条件筛选多表并导出统计分析,pandas拥有极高的执行效率。python-docx与PyPDF2/pdfplumber:分别用于 Word 合同文档的模板变量替换与 PDF 文本信息提取。
3. 网络数据提取与 API 交互
当自动化任务的数据源来自内部系统或互联网网页:
requests:极具人性化的 HTTP 请求库,用于调用各类 Web API、下载远程文件或提交表单。beautifulsoup4:HTML 与 XML 解析库,适合静态网页中的特定文字或表格抓取。
4. 桌面交互与浏览器自动化
若系统未开放 API 接口,必须通过模拟人类点击与输入实现操作:
playwright/selenium:控制无头或有头浏览器,自动化完成登录系统、填表、导出报表等繁琐交互。推荐优先使用 Playwright,其对异步操作和网络等待的处理更为现代化。pyautogui:控制本地鼠标指针移动、单击及模拟键盘敲击,适用于无代码接口的旧版桌面客户端。
5. 自动化任务调度
脚本写好后需要按预定周期执行:
schedule:轻量级 Python 调度库,可以用接近自然语言的语法配置周期任务(如schedule.every().day.at("09:00").do(job))。- 系统原生调度器:Linux 的
cron或 Windows 的“任务计划程序”,适合作为生产环境的常驻调度工具,无需让 Python 进程始终驻留后台。
三、第一个自动化脚本编写:文件夹按类型自动归类整理
为了真正掌握自动化脚本的编写,我们来动手实现一个最实用、零外部依赖的高频场景:桌面或下载目录文件自动归类器。
电脑的“下载”文件夹或桌面经常堆满各种格式的文件。人工逐个建立文件夹、移动文件既费时又容易误删。我们将编写一个 Python 脚本,自动扫描指定目录,根据文件后缀(如 .pdf、.png、.zip)将文件安全分拣到对应类型的子目录中。
1. 任务逻辑拆解
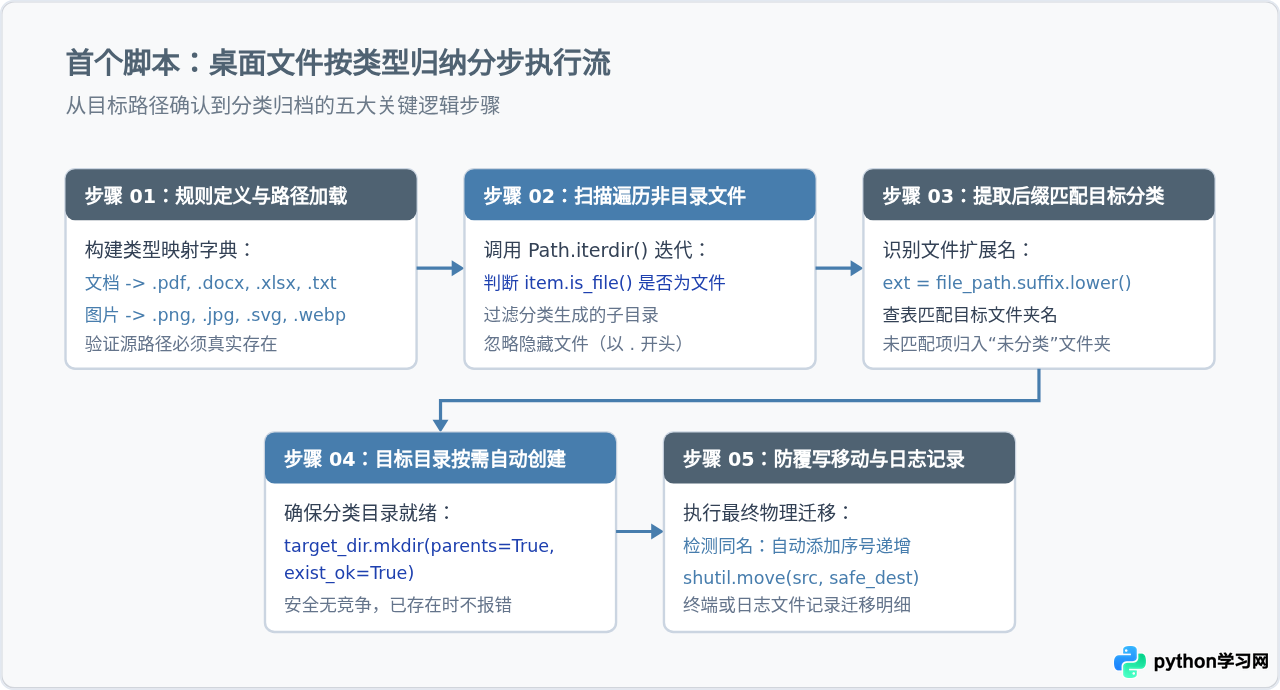
编写脚本前,先理清每个执行环节的严密逻辑:
- 定位目标目录:使用
pathlib.Path锁定目标路径,检查路径是否存在。 - 遍历并过滤:只处理根目录下的常规文件,跳过已存在的子文件夹,避免死循环嵌套。
- 匹配后缀映射:提取文件后缀(转小写),查找预先定义的分类规则(如“文档”、“图片”、“压缩包”)。若不在规则中,归入“其他”。
- 目录按需创建:移动前检查对应分类目录是否存在,不存在则通过
mkdir(exist_ok=True)自动创建。 - 安全移动与同名处理:若目标路径已存在同名文件,在文件名前加上时间戳或自增序号,绝不直接覆盖,保障数据安全。
2. 编写完整可运行的脚本代码
新建名为 organize_folder.py 的文件,写入以下完整代码。该代码完全使用 Python 3 标准库,无需通过 pip 安装第三方包:
import os
import shutil
from pathlib import Path
from datetime import datetime

# 1. 配置规则:文件后缀与目标分类文件夹的映射关系
EXTENSION_MAP = {
    "文档资料": [".pdf", ".docx", ".doc", ".xlsx", ".xls", ".pptx", ".txt", ".md"],
    "图片素材": [".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg", ".bmp"],
    "压缩归档": [".zip", ".rar", ".7z", ".tar", ".gz"],
    "影音视频": [".mp4", ".mkv", ".mov", ".avi", ".mp3", ".wav"],
    "代码与脚本": [".py", ".sh", ".json", ".sql", ".html", ".css", ".js"]
}

def get_category(extension: str) -> str:
    """根据文件后缀查找匹配的分类文件夹名称"""
    ext_lower = extension.lower()
    for category, extensions in EXTENSION_MAP.items():
        if ext_lower in extensions:
            return category
    return "其他未分类"

def get_unique_destination(dest_dir: Path, filename: str) -> Path:
    """
    防覆盖处理:如果目标路径已存在同名文件,
    自动在文件名后追加数字序号,如 'report_1.pdf'
    """
    candidate = dest_dir / filename
    if not candidate.exists():
        return candidate

    stem = Path(filename).stem
    suffix = Path(filename).suffix
    counter = 1
    while True:
        new_name = f"{stem}_{counter}{suffix}"
        candidate = dest_dir / new_name
        if not candidate.exists():
            return candidate
        counter += 1

def organize_directory(target_path_str: str, dry_run: bool = False):
    """
    主执行函数:遍历目标目录并归类文件
    :param target_path_str: 需要整理的目标文件夹路径
    :param dry_run: 若为 True,仅打印操作计划而不真正移动文件
    """
    target_dir = Path(target_path_str).expanduser().resolve()

    if not target_dir.exists() or not target_dir.is_dir():
        print(f"[错误] 目标路径不存在或不是目录: {target_dir}")
        return

    print(f"=== 开始整理目录: {target_dir} ===")
    if dry_run:
        print("[提示] 当前处于 Dry-Run 试运行模式,不会实际修改任何文件\n")

    category_names = set(EXTENSION_MAP.keys()) | {"其他未分类"}
    moved_count = 0
    skipped_count = 0

    # 遍历当前目录下的所有项目
    for item in target_dir.iterdir():
        # 跳过子目录(包括之前已经建好的分类文件夹)
        if item.is_dir():
            continue

        # 跳过以点开头的隐藏文件或系统临时文件
        if item.name.startswith("."):
            skipped_count += 1
            continue

        # 匹配分类并确定目标路径
        category = get_category(item.suffix)
        category_dir = target_dir / category
        destination = get_unique_destination(category_dir, item.name)

        if dry_run:
            print(f"[预演] 计划移动: {item.name} -> {category}/{destination.name}")
            moved_count += 1
        else:
            try:
                # 确保目标子目录存在
                category_dir.mkdir(parents=True, exist_ok=True)
                # 执行安全移动
                shutil.move(str(item), str(destination))
                print(f"[已归档] {item.name} -> {category}/{destination.name}")
                moved_count += 1
            except Exception as e:
                print(f"[跳过] 移动 {item.name} 失败,原因: {e}")
                skipped_count += 1

    print("\n=== 整理完成 ===")
    print(f"处理文件数: {moved_count} 个")
    print(f"跳过项目数: {skipped_count} 个")

if __name__ == "__main__":
    # 请根据实际需要指定待整理的目录,例如 ~/Downloads 或本地测试路径
    # 首次运行建议将 dry_run 设为 True 进行安全预览
    TARGET_FOLDER = "~/Downloads"
    organize_directory(TARGET_FOLDER, dry_run=True)
3. 执行命令与验证效果
在终端中执行该脚本非常直接。建议初次运行时保持 dry_run=True,先观察将要发生变动的文件列表:
# 1. 运行试运行模式,输出预期变动
python3 organize_folder.py

# 终端输出示例:
# === 开始整理目录: /Users/username/Downloads ===
# [提示] 当前处于 Dry-Run 试运行模式,不会实际修改任何文件
#
# [预演] 计划移动: 2026年Q1财务分析.xlsx -> 文档资料/2026年Q1财务分析.xlsx
# [预演] 计划移动: 架构设计草图.png -> 图片素材/架构设计草图.png
# [预演] 计划移动: dataset_v2.tar.gz -> 压缩归档/dataset_v2.tar.gz
#
# === 整理完成 ===
# 处理文件数: 3 个
# 跳过项目数: 0 个
确认预览结果无误后,将代码末尾的 dry_run=True 修改为 dry_run=False,再次运行脚本。此时目标文件将整洁地归纳到各自的分类文件夹中。
四、自动化脚本编写的四大避坑法则
很多编写自动化脚本的开发者容易在测试环境正常、一旦部署到日常生产却遭遇误删文件、路径找不到等故障。遵循以下四项原则能避免绝大多数低级隐患。
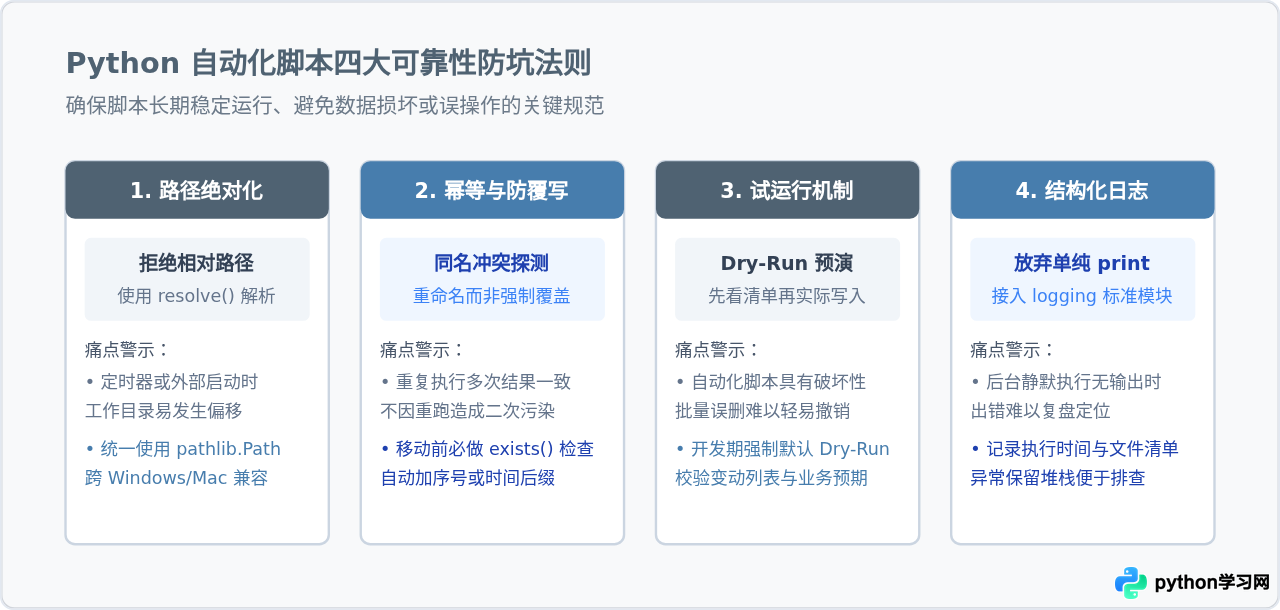
自动化脚本的核心价值不是代码有多长,而是安全可靠、稳定运行。初写脚本时,始终记住三句话: 路径使用绝对路径、移动覆盖加好检测、真正执行前先打日志预览。 掌握了基础文件与数据处理逻辑后,你可以逐步将这些能力组合到定时调度器或 Web API 中,打造更高效的日常办公自动化工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















