


Python打包后提示ModuleNotFoundError?排查缺失模块指南

在开发环境中运行流畅的 Python 项目,在使用 PyInstaller 等工具打包成独立可执行文件后,常常会在双击启动或终端运行时突然崩溃,并抛出形如 ModuleNotFoundError: No module named 'xxx' 的错误。该问题往往让很多开发者感到困惑:明明本地安装了全部依赖,为何打包后的程序依然提示找不到模块?其核心根源在于,打包工具在构建期是通过静态解析代码的抽象语法树(AST)来递归追踪依赖的,一旦程序中包含动态反射导入、插件机制或隐式底层的 C 扩展子模块,打包工具的静态扫描器就无法感知该模块的存在,导致其未被收录进最终的分发文件中。本文将系统阐述这一现象的底层机理、精准定位步骤、针对性修复策略以及独立环境验证方法,助你彻底解决打包缺失模块的棘手难题。
一、底层成因:为什么本地能跑,打包后却缺失模块?
要彻底解决问题,首先需要理解打包工具的工作原理以及 Python 解释器在不同环境下的导入差异。
1. 静态代码分析的局限性
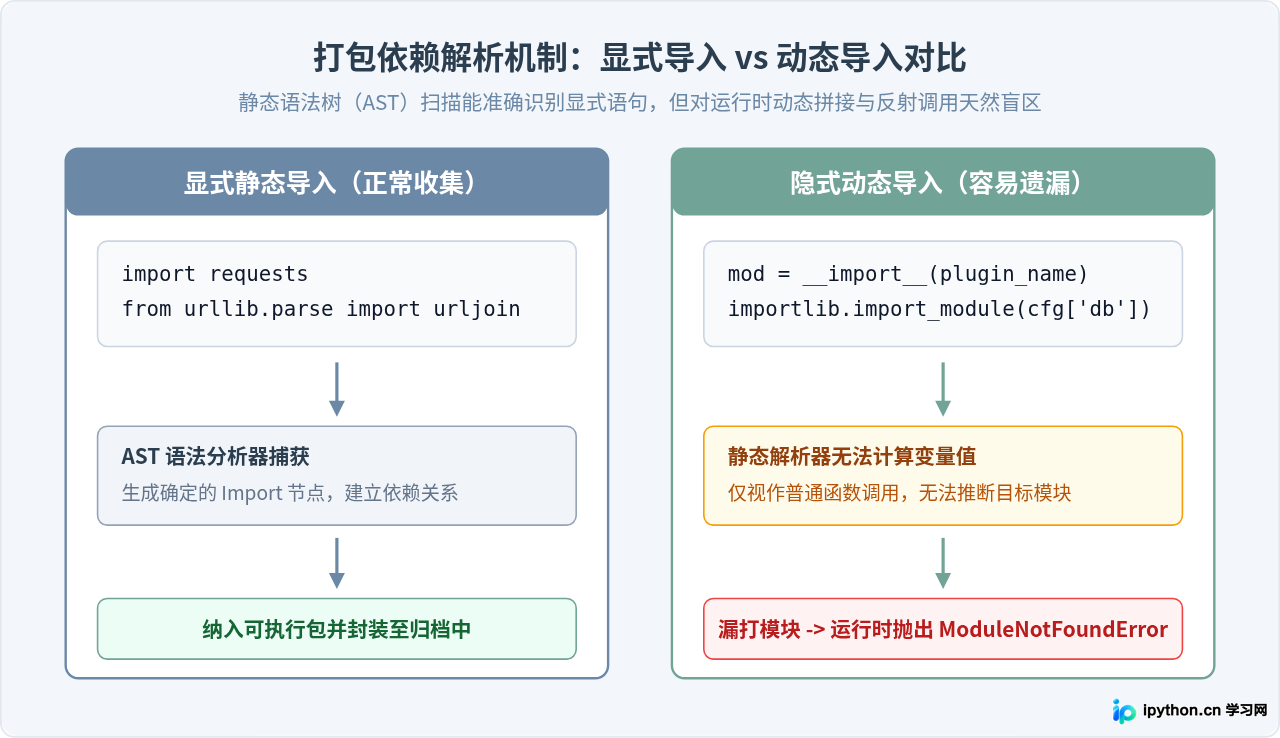
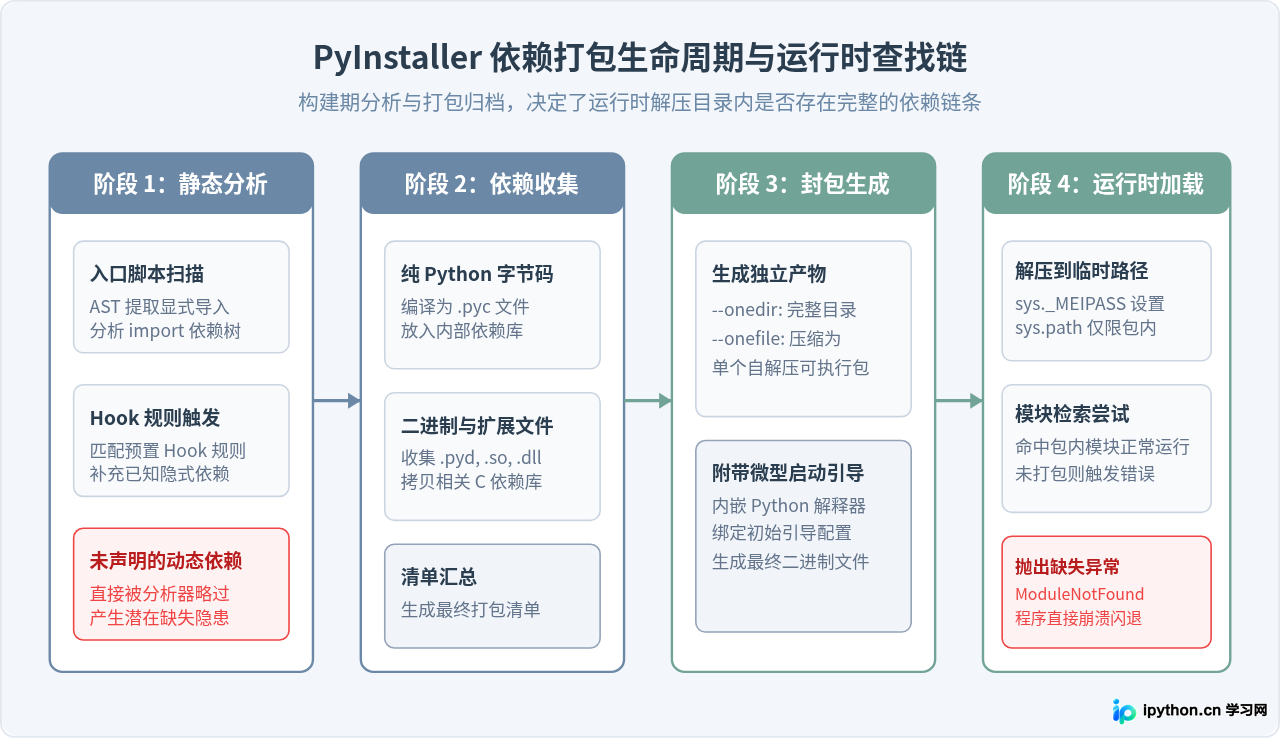
以应用最广泛的 PyInstaller 为例,当执行打包命令时,其内部的分析引擎会读取主入口脚本(如 main.py),并将其解析为抽象语法树(AST)。分析器会遍历树中的所有 import 与 from ... import ... 节点。如果模块名是固定的字面量字符串,打包工具便会定位本地环境中的对应 .py 或 .pyd/.so 文件,将其加入打包清单,并进一步递归分析这些被引用模块的依赖。
然而,现代 Python 框架大量采用了动态导入模式。例如:
- 通过
importlib.import_module(module_name)依据用户配置动态加载插件或驱动; - 通过
__import__(name)实现反射式加载; - 使用字符串拼接模块路径,如
f"engines.{db_type}_backend"。
因为打包过程并不执行这些业务逻辑代码,分析器根本无法得知变量在运行时的具体内容,因而直接跳过了这些关键模块。
2. 复合第三方库的隐式子模块与 C 扩展
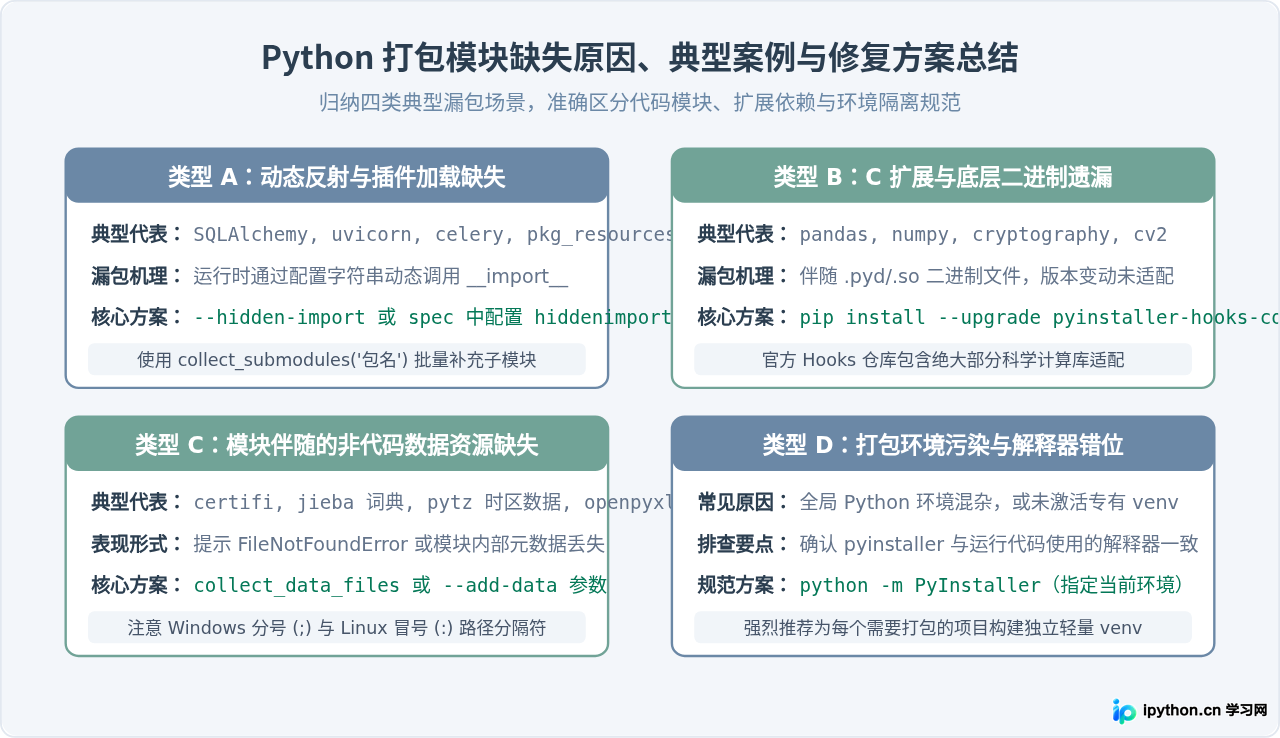
诸如 pandas、sqlalchemy、cryptography、pkg_resources 等大型第三方库,往往在内部组织了复杂的子模块结构或底层的 C/C++ 动态链接库。例如,sqlalchemy 在连接数据库时会动态载入对应的方言库(dialect),而 pandas 内部在处理时间序列时会隐式调用底层编译产物。如果官方或社区尚未为该库提供适配完备的 Hook 规则,或者当前安装的库版本引入了新的子模块路径,打包工具就极易漏掉这些隐式依赖。
3. 开发环境与打包环境的运行时检索路径差异
在开发环境中,Python 解释器的 sys.path 默认包含了项目根目录、全局或虚拟环境的 site-packages 目录。即便代码在运行时动态加载某个模块,解释器也能随时从本地磁盘中检索到。但在打包为独立程序(尤其是 --onefile 单文件模式)后,程序启动时会将打包的内容解压到一个临时目录(PyInstaller 中为 sys._MEIPASS),并将 sys.path 重定向至该临时目录。此时外部系统的 site-packages 不再参与检索,只要目标文件没有被打包进去,导入即刻失败。
二、标准排查路径:五步定位与修复缺失模块
遇到模块缺失报错时,切忌盲目随意复制各种命令参数。按照标准的排查流程,能够快速厘清缺失的具体模块及其调用层级。
第一步:保留控制台窗口,捕获报错第一现场
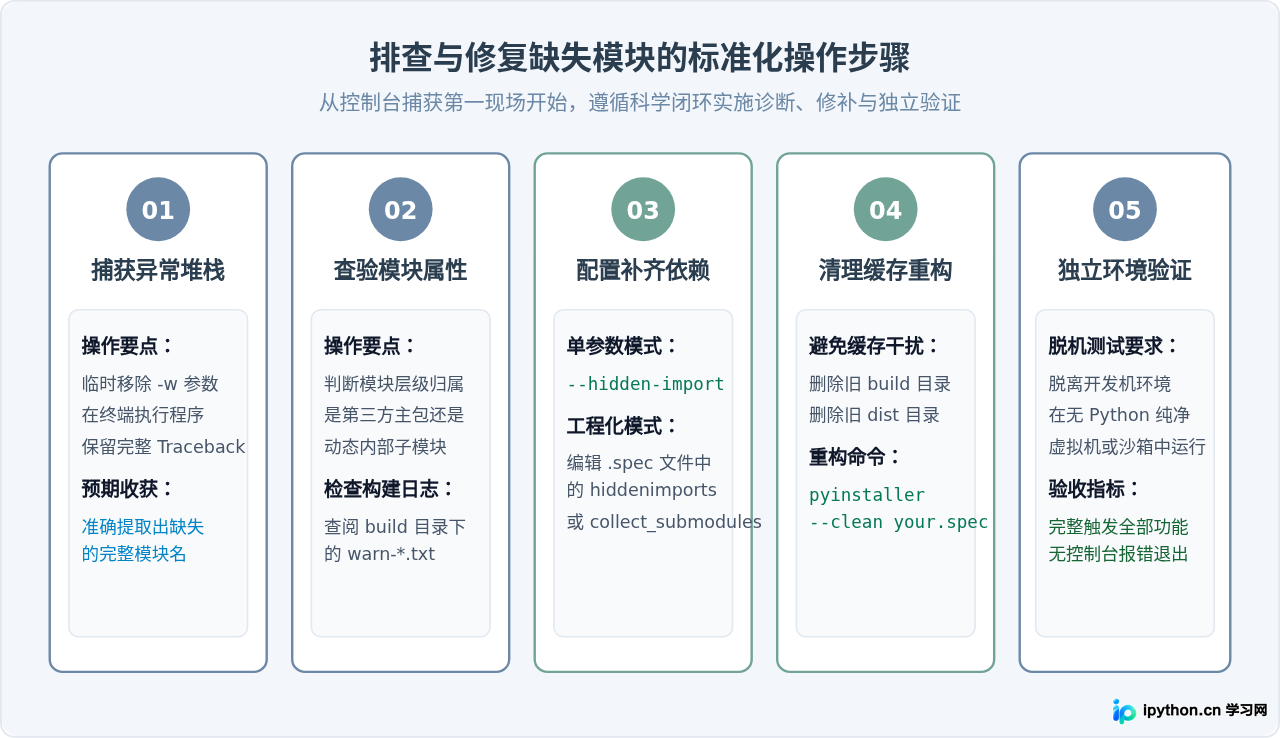
很多桌面端应用开发者在打包时习惯加上 -w 或 --noconsole 选项以隐藏黑色的控制台窗口。然而这会导致程序发生 ModuleNotFoundError 时直接闪退,无法看到任何错误日志。
排查要求:在调试阶段,必须去掉 -w 参数,或者直接在 Windows PowerShell / CMD / Linux 终端中执行生成的 dist/your_app/your_app.exe。控制台会完整打印出类似如下的异常堆栈:
Traceback (most recent call last):
  File "main.py", line 12, in <module>
    from app.database import init_db
  File "app/database.py", line 4, in <module>
    engine = create_engine("mysql+pymysql://...")
  File "sqlalchemy/engine/create.py", line 588, in create_engine
    dbapi = dialect_cls.dbapi(**dbapi_args)
  File "sqlalchemy/dialects/mysql/pymysql.py", line 63, in dbapi
    return __import__("pymysql")
ModuleNotFoundError: No module named 'pymysql'
从堆栈中可以明确得知:虽然 main.py 没有显式 import pymysql,但 sqlalchemy 在运行时动态反射导入了 pymysql,从而导致报错。
第二步:检查 build 目录下的警告清单
执行打包命令后,PyInstaller 会在项目目录下生成 build/your_app/ 文件夹。该目录下存在一个名为 warn-your_app.txt 的纯文本文件。该文件记录了打包过程中所有被扫描到但未能成功定位的文件或模块。
搜索该文件中的 missing module named 'xxx',如果报错中提示缺失的模块名在此列表中出现,即证明打包工具早已发现了该引用,但因路径或动态特性未能自动收录。
三、核心解决方案:补全隐式依赖的三种方式
根据项目的复杂程度和后续维护需求,可以通过以下三种方式通知打包工具补全缺失的模块。
方式一:命令行传参 --hidden-import(适合单一简单依赖)
如果项目结构较为简单,缺失的模块数量较少(如只有 1 到 2 个),可以在重新打包时直接通过 --hidden-import(或简写 --collect-submodules)明确告知打包工具强制收录该模块:
# 指定单个缺失模块
pyinstaller --clean -F --hidden-import=pymysql main.py

# 指定多个缺失模块
pyinstaller --clean -F \
  --hidden-import=pymysql \
  --hidden-import=cryptography.hazmat.backends.openssl \
main.py提醒:每次修改打包参数后,务必带上 --clean 参数,清理上一次构建留下的缓存文件,防止旧的依赖分析缓存导致新参数失效。
方式二:修改 .spec 配置文件(工程化项目推荐)
首次运行 pyinstaller main.py 后,目录中会生成同名的 main.spec 文件。spec 文件实际上是一个 Python 脚本,包含了打包的全部控制参数。对于依赖复杂或包含多个子包的项目,直接维护 .spec 文件更加可靠且便于团队协作版本管理。
打开 main.spec,找到 Analysis 对象的初始化参数,在 hiddenimports 列表中填入缺失的模块名:
# -*- mode: python ; coding: utf-8 -*-
from PyInstaller.utils.hooks import collect_submodules, collect_data_files

# 自动收集某复合库的所有子模块(例如 openpyxl 或 pandas)
collected_hidden = collect_submodules('openpyxl')

a = Analysis(
    ['main.py'],
    pathex=[],
    binaries=[],
    datas=collect_data_files('openpyxl'),  # 如果伴随静态资源缺失一并收集
    hiddenimports=[
        'pymysql',
        'sqlalchemy.dialects.mysql.pymysql',
        'uvicorn.logging',
    ] + collected_hidden,
    hookspath=[],
    hooksconfig={},
    runtime_hooks=[],
    excludes=['tkinter', 'unittest'],  # 排除无关体积大的库
    noarchive=False,
)
pyz = PYZ(a.pure)

exe = EXE(
    pyz,
    a.scripts,
    a.binaries,
    a.datas,
    [],
    name='my_application',
    debug=False,
    bootloader_ignore_signals=False,
    strip=False,
    upx=True,
    console=True,  # 调试期保持控制台开启
)
编辑保存后,直接以 .spec 文件为参数重新执行打包:
pyinstaller --clean main.spec方式三:编写自定义 Hook 脚本(适合深度定制第三方库)
如果某个自定义模块或私有 SDK 在多个项目中均被引用,且每次都需要声明大量 hiddenimports,可以为其编写专用的 PyInstaller Hook。
- 在项目根目录下创建
hooks目录; - 创建形如
hook-my_module.py的文件(名称必须对应目标库的顶层包名); - 在文件中使用官方辅助函数声明隐藏导入与数据文件:
# 文件位置:hooks/hook-my_plugin.py
from PyInstaller.utils.hooks import collect_submodules, collect_data_files

hiddenimports = collect_submodules('my_plugin')
datas = collect_data_files('my_plugin')
打包时通过 --additional-hooks-dir=hooks 参数指定自定义 Hook 目录,PyInstaller 在遇到 import my_plugin 时便会自动加载该 Hook 执行全量收集。
四、避坑指南与最佳实践
在长期打包实践中,遵循以下规范能够预防绝大多数模块缺失与体积膨胀问题:
1. 务必在干净的独立虚拟环境(virtualenv / venv)中打包
很多开发者直接在全局 Python 环境下调用 pyinstaller。由于全局环境通常安装了大量杂乱的工具库,PyInstaller 可能会误把与本程序无关但被间接引用的庞大模块一并分析,既成倍增加了构建时间与产物体积,又容易因为依赖版本冲突产生离奇的缺失报错。
标准实践:为项目新建干净的虚拟环境,仅安装 requirements.txt 中声明的必要依赖和 pyinstaller,并通过 python -m PyInstaller 确保调用的是当前虚拟环境内的打包器:
# 创建并激活专用虚拟环境
python -m venv .venv
source .venv/bin/activate  # Windows 下执行: .venv\Scripts\activate

# 仅安装项目运行时必需依赖及打包工具
pip install -r requirements.txt
pip install pyinstaller pyinstaller-hooks-contrib

# 使用当前环境下的 Python 模块方式运行打包
python -m PyInstaller --clean -F main.py
2. 保持 pyinstaller-hooks-contrib 处于最新版本
PyInstaller 官方将主流第三方库的适配规则独立维护在 pyinstaller-hooks-contrib 仓库中。当新版本的科学计算库或 Web 框架发布时,如果打包工具的 Hooks 过旧,就会无法识别新包的结构。在遇到知名开源库报 ModuleNotFoundError 时,优先执行升级命令往往能立竿见影:
pip install --upgrade pyinstaller pyinstaller-hooks-contrib3. 严格执行脱机验收验证
在开发机上运行打包成功的可执行程序,由于系统路径或当前用户目录下可能残留有本地 Python 的痕迹,有时会产生“假装成功”的假象。完成打包后,应将产物复制到一台从未安装过 Python 运行环境的纯净虚拟机、Windows Sandbox 沙箱或全新的容器中测试运行,完整遍历核心业务链路,确认完全没有弹窗报错或日志异常后,方可进行最终版本发布。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















