


Python新手必装的10个常用第三方库

Python 语言之所以应用广泛,核心优势之一在于其成熟而庞大的第三方生态。刚完成基础语法学习的新手,往往需要借助成熟的第三方库来解决网络请求、数据整理、表格处理以及界面交互等实际问题。本文挑选了 10 个在不同开发场景下高频出现、接口设计规范且社区活跃的第三方库,逐一说明它们的核心作用、标准安装方式与基础使用范例。
一、第三方库标准安装与使用流程
在开始安装任何第三方库之前,建议先理清标准的操作路径。通常建议在独立的虚拟环境中通过 pip 安装依赖,以防止多个项目之间的依赖版本发生冲突。
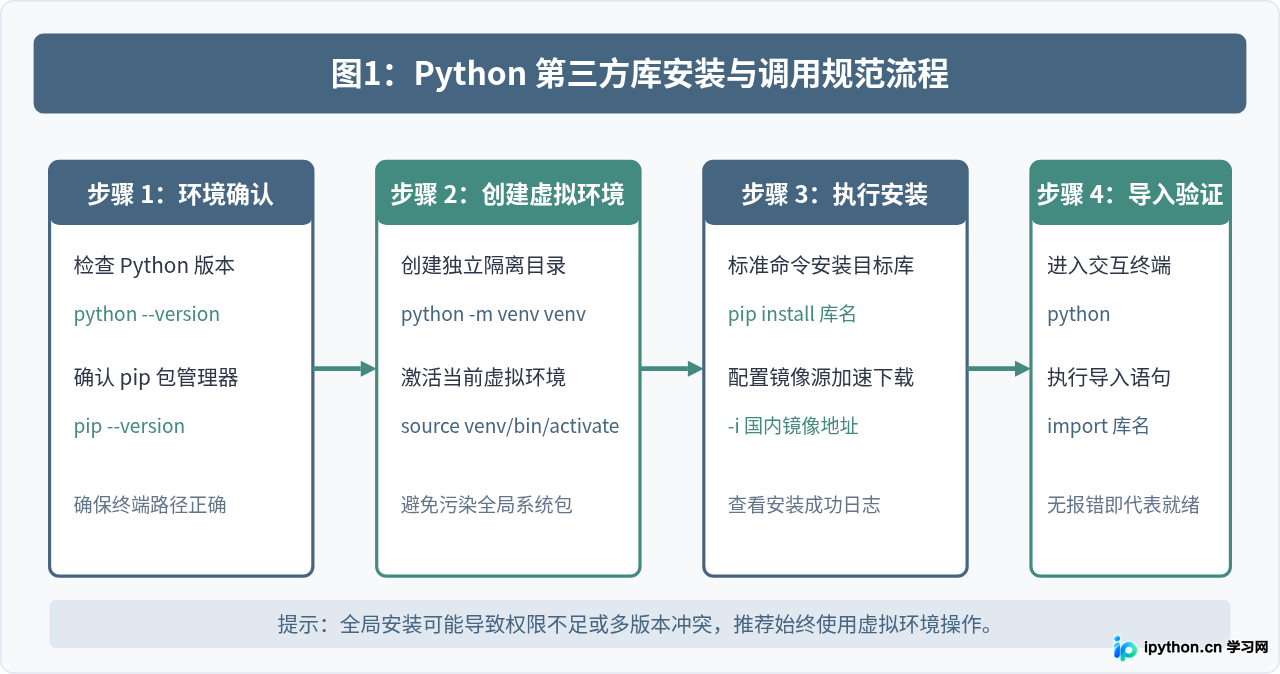
python -m venv myenv 创建虚拟环境后,Windows 用户执行 myenv\Scripts\activate,macOS / Linux 用户执行 source myenv/bin/activate 即可进入隔离环境。
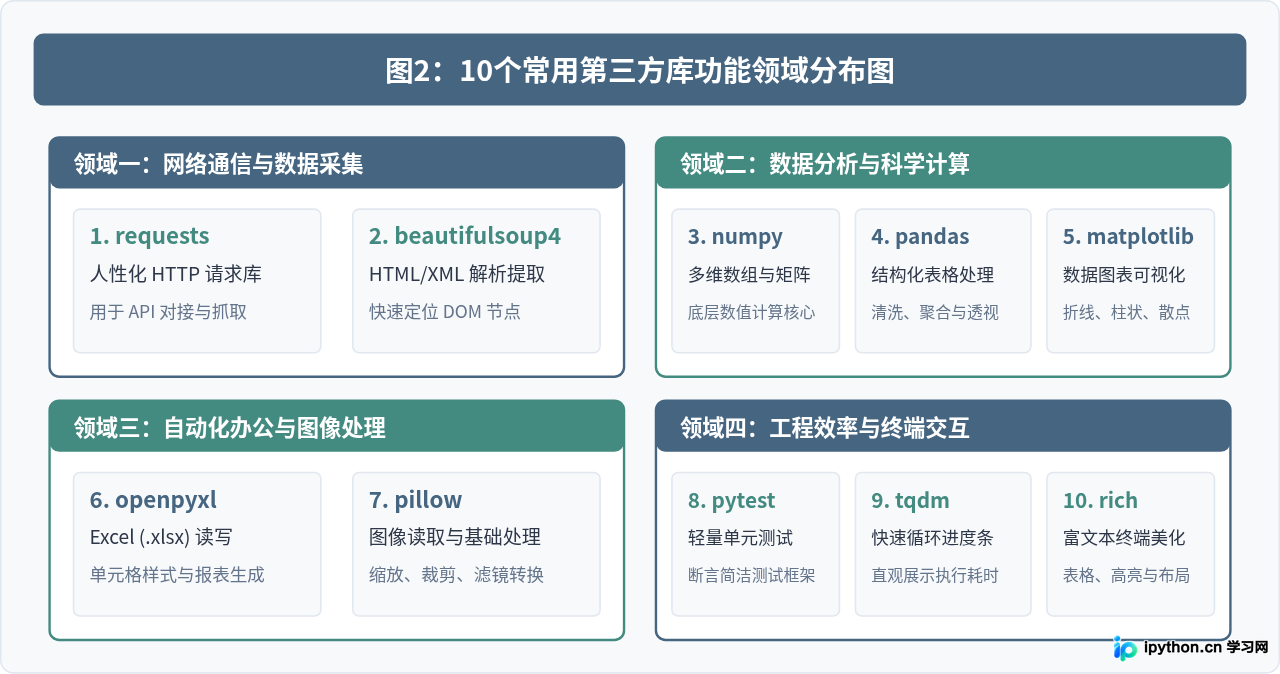
二、10大常用第三方库知识图谱
初学者面对成千上万的第三方包时,可以按照应用场景划分为四大方向:网络与数据采集、数据分析与计算、办公自动化与图像、以及工程质量与交互输出。
三、核心库功能与实战代码
1. requests:网络请求与 API 交互
Python 原生内置了 urllib 模块,但其语法相对繁琐。requests 封装了底层的复杂连接逻辑,提供了直观的 HTTP 方法调用。
# 安装命令
pip install requests
示例代码:发起 GET 请求并解析 JSON 响应内容。
import requests

url = "https://api.github.com"
response = requests.get(url, timeout=5)

# 验证状态码与提取返回数据
if response.status_code == 200:
    data = response.json()
    print("当前接口信息:", data.get("current_user_url"))
else:
print("请求异常,状态码:", response.status_code)注意点:调用接口时务必加上 timeout 参数,避免因网络无响应导致程序无限期挂起。
2. beautifulsoup4:网页结构解析与内容抽取
在编写简单的爬虫或提取离线 HTML 文件内容时,beautifulsoup4(通常缩写为 bs4)能够快速根据 CSS 选择器或标签属性定位目标文本。
# 安装命令
pip install beautifulsoup4
示例代码:解析一段 HTML 源码并提取超链接文本与链接地址。
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
    <h1>文章标题</h1>
    <a href="https://example.com/item1">详情链接1</a>
    <a href="https://example.com/item2">详情链接2</a>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")
title = soup.find("h1").get_text()
links = soup.find_all("a")

print("提取标题:", title)
for link in links:
print("链接文字:", link.get_text(), "目标地址:", link.get("href"))注意点:解析规模较大或格式不标准的复杂 HTML 时,推荐搭配安装 lxml 解析器以提升解析速度与兼容性。
3. numpy:高性能数值计算基础
numpy 提供了底层的 ndarray 多维数组对象以及高效的矩阵运算函数,是整个 Python 科学计算生态的基石。
# 安装命令
pip install numpy
示例代码:生成连续数组并进行向量化批量计算。
import numpy as np

# 创建一维数值数组
data = np.array([10, 20, 30, 40, 50])

# 向量化加乘运算(无需循环)
result = (data * 2) + 5
print("原数组:", data)
print("计算结果:", result)
print("数组平均值:", np.mean(result))注意点:NumPy 数组内元素的数据类型必须保持统一,与 Python 原生列表支持混合类型不同。
4. pandas:数据清洗与表格分析
pandas 提供了 Series 和 DataFrame 两种核心数据结构,非常适合处理带标签的二维表格数据,常用于数据过滤、缺失值填充和格式汇总。
# 安装命令
pip install pandas
示例代码:构建 DataFrame 并按条件过滤统计。
import pandas as pd

raw_data = {
    "姓名": ["张三", "李四", "王五", "赵六"],
    "部门": ["技术部", "市场部", "技术部", "财务部"],
    "成绩": [88, 92, 79, 95]
}

df = pd.DataFrame(raw_data)
# 筛选成绩大于80且属于技术部的记录
filtered = df[(df["成绩"] > 80) & (df["部门"] == "技术部")]
print(filtered)注意点:在对 DataFrame 进行多条件组合筛选时,每个条件必须用小括号括起来,并使用位运算符 & 或 |。
5. matplotlib:绘制统计分析图表
matplotlib 是最经典的可视化库,支持折线图、柱状图、散点图、直方图等多种图形输出,可用于数据探索与结果汇报。
# 安装命令
pip install matplotlib
示例代码:生成柱状图并保存为本地图片。
import matplotlib.pyplot as plt

categories = ["A组", "B组", "C组", "D组"]
values = [23, 45, 56, 78]

plt.figure(figsize=(6, 4))
plt.bar(categories, values, color="#456581")
plt.title("各组测试样本统计")
plt.xlabel("测试组别")
plt.ylabel("样本数量")
plt.tight_layout()
plt.savefig("chart_demo.png")
plt.close()注意点:如果在保存图片时出现中文字符显示为乱码或方框的问题,需要提前设置 plt.rcParams["font.sans-serif"] 为系统支持的中文字体。
6. openpyxl:读写 Excel 文件
日常办公中存在大量的 Excel 表格交互需求。openpyxl 专门用于读取和写入 .xlsx 格式文件,无需依赖本地 Office 软件环境。
# 安装命令
pip install openpyxl
示例代码:新建工作簿、写入数据并保存。
import openpyxl

wb = openpyxl.Workbook()
sheet = wb.active
sheet.title = "员工打卡明细"

# 追加表头与记录
sheet.append(["工号", "姓名", "出勤天数"])
sheet.append(["1001", "小明", 22])
sheet.append(["1002", "小红", 21])

wb.save("report.xlsx")
wb.close()注意点:该库只支持 .xlsx 格式,老旧的 .xls 格式需要使用 xlrd 或转换为新版格式处理。
7. pillow:图像读取与裁剪缩放
Pillow 是 Python Imaging Library (PIL) 的现代分支,支持绝大多数常见图像格式的读写、缩放、裁剪、旋转以及添加水印。
# 安装命令
pip install pillow
示例代码:读取本地图片并生成指定尺寸的缩略图。
from PIL import Image

# 打开图片并查看基本信息
with Image.open("sample.jpg") as img:
    print("图像格式:", img.format, "原始尺寸:", img.size)

    # 按比例缩放为最大 300x300
    img.thumbnail((300, 300))
img.save("thumbnail.jpg")注意点:安装时包名为 pillow,而在 Python 代码中导入时模块名称为大写的 PIL。
8. pytest:简单可靠的单元测试框架
编写稳健的代码离不开单元测试。pytest 避免了原生 unittest 繁琐的类继承结构,直接使用普通函数和 assert 关键字即可完成测试。
# 安装命令
pip install pytest
示例代码:编写待测函数与测试用例(保存为 test_calc.py)。
def add(a, b):
    return a + b

def test_add_positive():
    assert add(2, 3) == 5

def test_add_zero():
    assert add(0, 0) == 0
在终端中直接运行命令 pytest test_calc.py 即可自动发现并运行所有以 test_ 开头的测试用例。
9. tqdm:循环执行进度直观展示
在执行耗时较长的批量任务、网络下载或大数据循环时,缺乏反馈会让开发者无法判断程序是否卡死。tqdm 只需包裹可迭代对象即可输出动态进度条。
# 安装命令
pip install tqdm
示例代码:为耗时循环添加进度条。
import time
from tqdm import tqdm

items = list(range(100))

# 包装现有迭代对象
for item in tqdm(items, desc="任务处理中"):
    time.sleep(0.02)  # 模拟单项任务处理耗时
终端示例输出:
任务处理中: 100%|██████████| 100/100 [00:02<00:00, 48.72it/s]10. rich:终端富文本与结构化排版
rich 可以在命令行中输出带有高亮颜色、格式化边框、表格以及语法树的富文本内容,极大提升脚本调试和交互界面的美观度。
# 安装命令
pip install rich
示例代码:在终端打印带样式的表格与彩色文本。
from rich.console import Console
from rich.table import Table

console = Console()
console.print("[bold green]运行成功:[/bold green] 系统正在导出报表...")

table = Table(title="服务运行状态")
table.add_column("服务名称", style="cyan")
table.add_column("监听端口", style="magenta")
table.add_column("状态", justify="right", style="green")

table.add_row("Web Gateway", "8080", "RUNNING")
table.add_row("Task Worker", "9001", "RUNNING")

console.print(table)
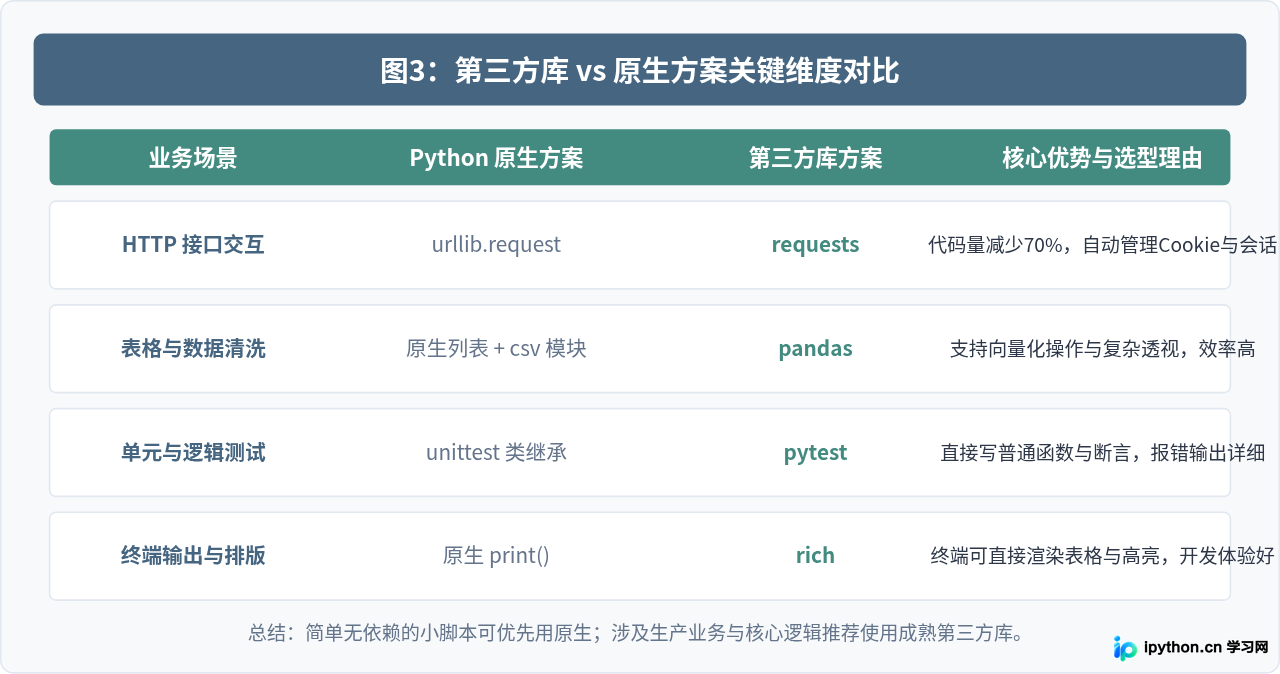
四、第三方库 vs 原生方案关键维度对比
许多初学者会疑惑:原生标准库已经具备部分类似功能,为什么还要专门引入第三方库?下表对比了典型场景下的差异与选型依据。
五、使用第三方库的避坑与规范建议
安装和使用第三方库时,初学者容易遇到网络慢、找不到模块或者版本冲突等问题。遵循以下四项原则能有效减少开发阻碍:
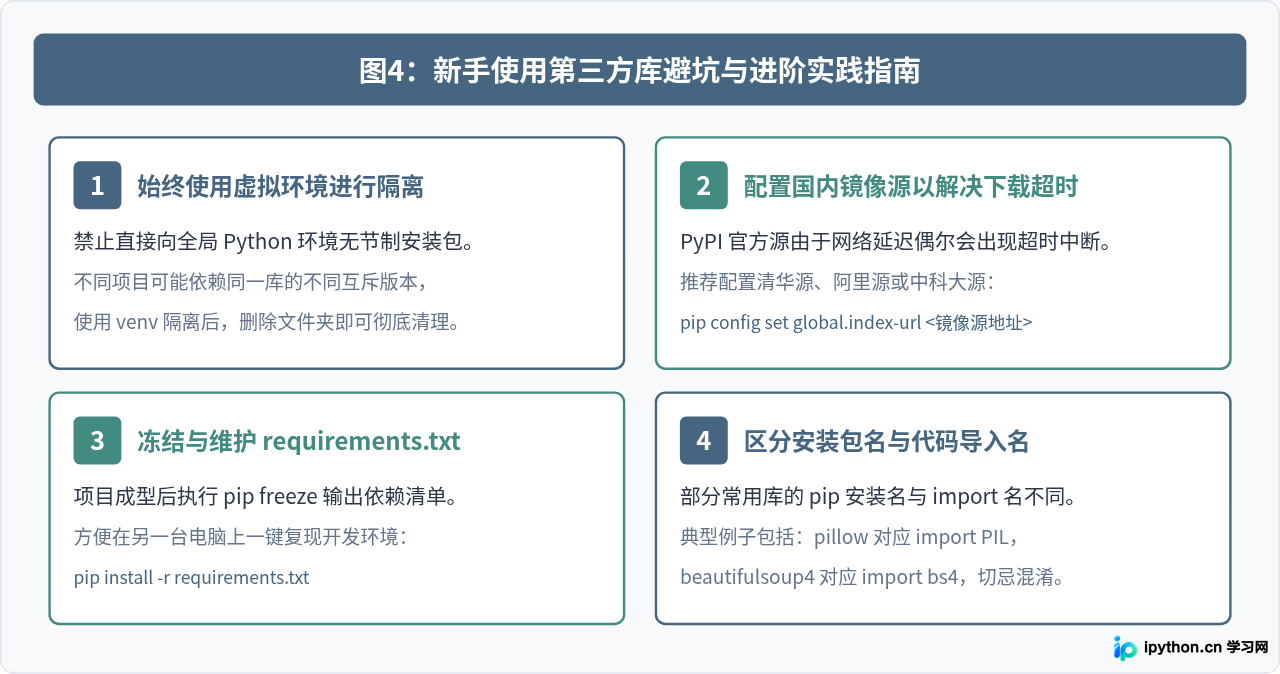
- 安装名字与导入名字不一致:这是新手最容易遇到的困惑。例如通过
pip install pillow安装后,代码中必须写作from PIL import Image;通过pip install beautifulsoup4安装后,代码中写的是from bs4 import BeautifulSoup。 - 善用依赖清单:团队协作或部署到新机器时,执行
pip freeze > requirements.txt记录所有已安装版本,他人只需执行pip install -r requirements.txt即可快速复现相同环境。 - 警惕包名钓鱼与拼写错误:在终端输入安装命令前,确认库名称拼写正确,避免因笔误安装恶意模仿的仿冒库。
掌握这 10 个库的定位与基础用法后,可以根据具体项目需要进一步阅读对应的官方文档,深入了解高级配置和优化技巧。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















