


Python新手必学的10个常用库清单与应用场景

掌握Python语法的基本语句后,新手真正迈入实用阶段的关键,在于学会借助成熟的库解决现实问题。Python拥有极其庞大的生态,但初学者如果盲目尝试各种小众工具,很容易陷入选择困难与依赖管理的泥潭。本文梳理了10个经过长期验证、高频出现于生产与日常任务中的常用库,覆盖文件处理、网络交互、数据分析、办公自动化与工程服务五大核心领域,帮助你建立清晰的工具箱图谱。
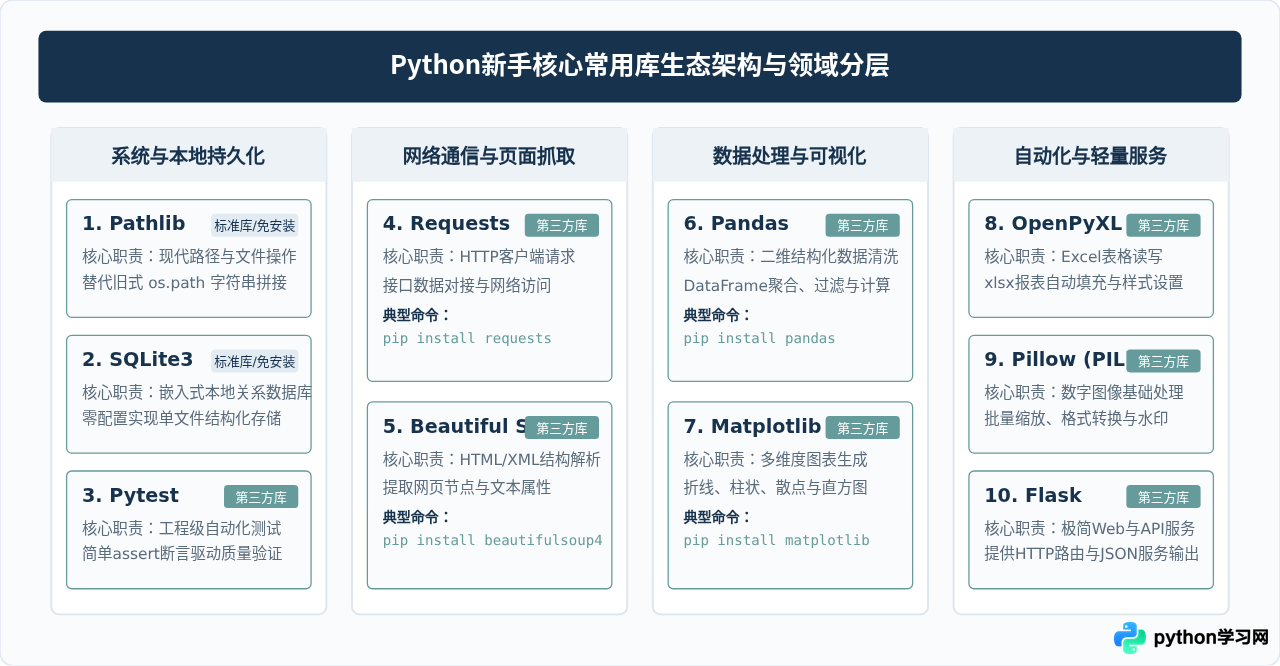
一、系统路径与文件存取:建立扎实的I/O基础
任何非玩具级别的Python脚本,第一步几乎都是和本地操作系统打交道:查找某个文件夹下的日志文件、创建输出目录,或者读写单机数据库。在这个领域,Python标准库本身就提供了工业级的解决方案,无需额外安装即可直接使用。
1. Pathlib:面向对象的现代路径管理器
在旧教程中,读者常看到 os.path.join() 或字符串切片拼接路径。这种方式在Windows与Linux跨平台时极易发生斜杠方向错误。Python 3.4引入的 pathlib 将路径抽象为一等对象,支持直接使用 / 运算符拼接路径,代码语义极为自然。
- 适用场景:文件按日期分目录归档、批量扫描指定后缀的文件(如
.csv或.png)、跨平台读写文本内容。 - 安装方式:Python标准库,无需安装。
from pathlib import Path

# 获取当前工作目录,并创建子目录
data_dir = Path.cwd() / "dataset"
data_dir.mkdir(exist_ok=True)

# 写入与快速读取
sample_file = data_dir / "records.txt"
sample_file.write_text("ID,Status\n101,Active", encoding="utf-8")

# 批量遍历所有txt文件并输出路径
for txt_path in data_dir.glob("*.txt"):
    print(f"找到文件: {txt_path.name}, 大小: {txt_path.stat().st_size} 字节")
os.path 函数与 Path 对象。如果在某些老旧第三方接口中必须传入字符串路径,显式调用 str(path_obj) 转换即可。
2. SQLite3:轻量免维护的嵌入式数据库
许多新手一提到存储数据,就急于配置 MySQL 或 PostgreSQL,结果在安装客户端、配置端口与权限上耗费大量时间。Python内置的 sqlite3 模块将整套关系型数据库引擎浓缩在一个普通文件中,具备完整的SQL语法支持与事务特性。
- 适用场景:爬虫断点续传状态记录、桌面软件本地配置保存、小规模业务指标明细汇总。
- 安装方式:Python标准库,无需安装。
import sqlite3

# 连接到本地单文件数据库(不存在则自动创建)
conn = sqlite3.connect("project_cache.db")
cursor = conn.cursor()

# 创建表并插入记录
cursor.execute("""
CREATE TABLE IF NOT EXISTS task_log (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    task_name TEXT NOT NULL,
    status TEXT NOT NULL
)
""")
cursor.execute("INSERT INTO task_log (task_name, status) VALUES (?, ?)", ("数据下载", "SUCCESS"))
conn.commit()

# 查询并验证
cursor.execute("SELECT id, task_name, status FROM task_log WHERE status = ?", ("SUCCESS",))
rows = cursor.fetchall()
for row in rows:
    print(f"任务编号: {row[0]}, 名称: {row[1]}, 状态: {row[2]}")

conn.close()
conn.commit(),否则修改仅保留在内存事务中,关闭连接后数据不会写入磁盘。
二、网络获取与页面解析:打通外部数据通道
掌握了本地存储后,许多业务需求需要向外连接外部世界:调用第三方RESTful API,或者抓取公开网页上的行情与资讯。Requests 与 BeautifulSoup4 是该链路上的黄金搭档。
3. Requests:优雅直观的HTTP客户端
Python虽然内置了 urllib,但其繁复的API常常让新手望而生畏。Requests 封装了底层的连接池与状态码处理,提供了一行代码发起GET/POST请求的能力。
- 适用场景:调用各类OpenAPI获取JSON数据、下载网络图片或附件、模拟表单提交。
- 安装命令:
pip install requests
import requests

url = "https://httpbin.org/get"
params = {"category": "python", "level": "beginner"}

try:
    # 设置合理超时时间,避免网络波动导致程序永久卡死
    response = requests.get(url, params=params, timeout=5)
    response.raise_for_status()  # 若返回4xx或5xx状态码直接抛出异常
    data = response.json()
    print("请求成功,远端返回参数:", data.get("args"))
except requests.exceptions.RequestException as err:
    print(f"网络交互失败: {err}")
4. Beautiful Soup 4:容错率极高的HTML解析器
拿到静态HTML文本后,直接用正则表达式提取标签容易因排版换行或属性顺序变动而崩溃。BeautifulSoup4 能够构建清晰的DOM语法树,通过标签名、CSS类名快速定位目标元素。
- 适用场景:抓取电商页面价格列表、提取新闻标题与正文段落、清洗无效HTML排版。
- 安装命令:
pip install beautifulsoup4
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
  <h1>热点新闻列表</h1>
  <ul class="news-list">
    <li><a href="/news/1">Python 3.12 性能显著提升</a></li>
    <li><a href="/news/2">数据分析入门必备技能矩阵</a></li>
  </ul>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")
news_items = soup.find_all("li")

for item in news_items:
    link = item.find("a")
    if link:
        print(f"标题: {link.get_text()} | 链接: {link.get('href')}")
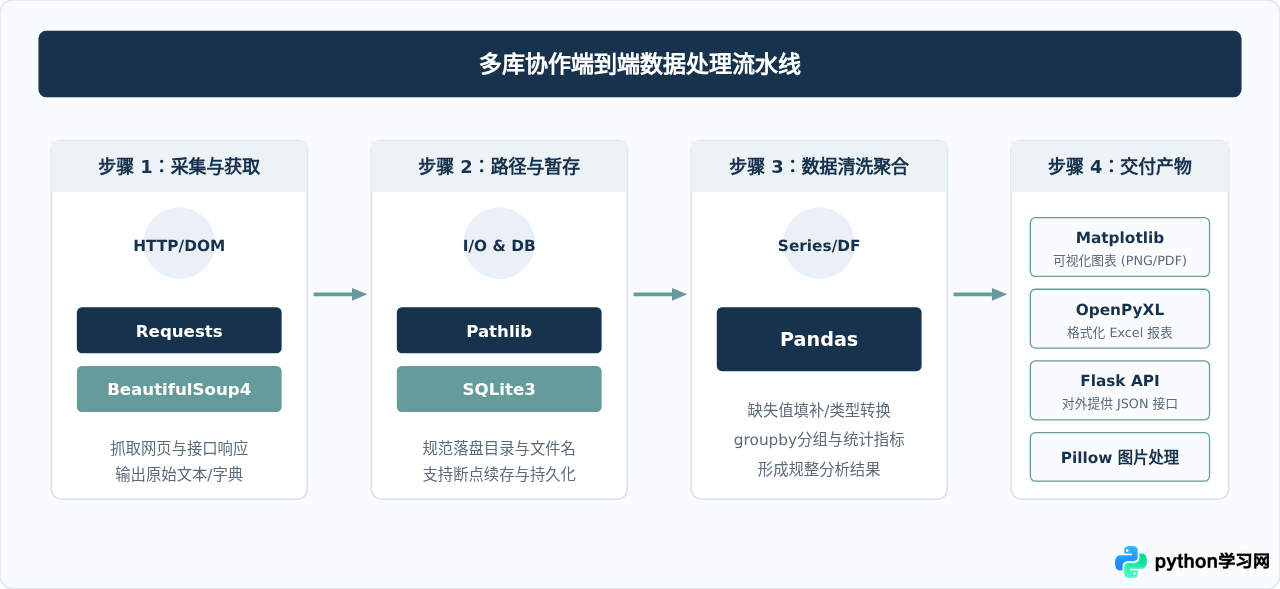
三、数据分析与图表生成:挖掘并呈现数据价值
在海量数据面前,纯循环和原生列表操作在性能与表达力上往往力不从心。Pandas 提供了类似电子表格的二维数据结构,而 Matplotlib 则是Python可视化领域的基础地基。
5. Pandas:结构化数据处理中枢
Pandas 的核心是 DataFrame。它支持高效的数据筛选、缺失值剔除、分组统计与多源表格横向合并,几乎是数据分析与机器学习工程的通用标准。
- 适用场景:清洗带有乱码和空值的CSV数据、按业务维度(部门、月份)汇总统计、多表联结操作。
- 安装命令:
pip install pandas
import pandas as pd

# 创建示例数据集
data = {
    "City": ["北京", "上海", "深圳", "北京", "上海"],
    "Sales": [1200, 1500, 980, 850, 1320],
    "Visits": [310, 420, 250, 190, 360]
}
df = pd.DataFrame(data)

# 过滤低销量,按城市聚合求和
filtered_df = df[df["Sales"] > 900]
summary = filtered_df.groupby("City")["Sales"].sum().reset_index()

print("城市销售额汇总:\n", summary)
for index, row in df.iterrows(): 逐行遍历进行数学计算,这会失去矢量化加速优势。尽可能使用 df['ColA'] + df['ColB'] 这样的列运算。
6. Matplotlib:高度可定制的可视化引擎
很多高级可视化工具(如Seaborn)底层都依赖 Matplotlib。掌握其基本的 Figure 与 Axes 对象模型,可以帮助你随时画出符合论文与业务汇报标准的高清图表。
- 适用场景:销售趋势折线图、类别对比柱状图、指标分布散点图导出。
- 安装命令:
pip install matplotlib
import matplotlib.pyplot as plt

months = ["Jan", "Feb", "Mar", "Apr", "May"]
revenue = [45, 52, 58, 63, 71]

# 显式使用面向对象风格绘图
fig, ax = plt.subplots(figsize=(6, 3.5))
ax.plot(months, revenue, marker="o", color="#17324D", linewidth=2, label="Monthly Revenue (k)")
ax.set_title("Revenue Growth Trend")
ax.set_xlabel("Month")
ax.set_ylabel("Revenue ($)")
ax.grid(True, linestyle="--", alpha=0.5)
ax.legend()

# 保存图表并释放内存
fig.savefig("trend.png", dpi=150, bbox_inches="tight")
plt.close(fig)
print("图表已成功导出为 trend.png")
四、办公自动化与日常处理:提升桌面生产力
Python常被用于“自动化替代繁琐人工”。在日常办公中,最常见的载体就是Excel表格与图像文件。OpenPyXL 与 Pillow 能够大幅消除机械劳动的耗时。
7. OpenPyXL:无缝读写现代Excel表格
虽然Pandas可以导出Excel,但如果你需要向现有的 .xlsx 模板中追加数据、保持原有公式与单元格背景样式,OpenPyXL 是最直接可靠的选择。
- 适用场景:将数据库导出的结果格式化填充入财务模板、根据业务规则自动生成多Sheet工单。
- 安装命令:
pip install openpyxl
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill

wb = Workbook()
ws = wb.active
ws.title = "销售月报"

# 写入表头并设置样式
ws.append(["产品编号", "单价", "销售量", "总金额"])
header_font = Font(bold=True, color="FFFFFF")
header_fill = PatternFill(start_color="17324D", end_color="17324D", fill_type="solid")

for col_num in range(1, 5):
    cell = ws.cell(row=1, column=col_num)
    cell.font = header_font
    cell.fill = header_fill

# 写入数据与Excel原生公式
ws.append(["A001", 99.5, 20, "=B2*C2"])
wb.save("sales_report.xlsx")
print("已成功生成带有计算公式的Excel文件:sales_report.xlsx")
8. Pillow (PIL):图像批量加工利器
在网站建设、商品上架或资料整理中,经常遇到成百上千张分辨率参差不齐、体积巨大的图片。Pillow 提供了裁剪、缩放、压缩与滤镜的基础API。
- 适用场景:给批量图片统一打上防盗水印、生成指定宽高的缩略图、JPG/PNG/WebP格式互转。
- 安装命令:
pip install pillow(注意在代码中导入名为PIL)
from PIL import Image

# 打开本地图片
with Image.open("sample_input.jpg") as img:
    # 保持宽高比生成最大200x200缩略图
    img.thumbnail((200, 200))
    # 转换为RGB并另存为轻量WebP格式
    rgb_img = img.convert("RGB")
    rgb_img.save("thumbnail.webp", "WEBP", quality=85)
    print("图片缩略图已成功生成")
五、服务化部署与质量保证:写出可靠的工程代码
当本地脚本逻辑验证完成后,通常有两种诉求:一是把功能包装成可以通过HTTP调用的服务,二是确保代码在迭代重构时不会引入意外Bug。Flask 与 Pytest 分别是这两个场景下的标杆。
9. Flask:轻便敏捷的Web微框架
相比于庞大且自带后台的Django,Flask 极为克制,仅包含路由与WSGI环境,非常适合初学者理解“请求—路由匹配—响应”的Web基础生命周期。
- 适用场景:为Python模型提供JSON预测接口、编写局域网内部管理小工具、作为微信小程序或前端Vue的后端接口。
- 安装命令:
pip install flask
from flask import Flask, jsonify, request

app = Flask(__name__)

@app.route("/api/calculate", methods=["POST"])
def calculate():
    payload = request.get_json() or {}
    val1 = payload.get("x", 0)
    val2 = payload.get("y", 0)
    return jsonify({
        "status": "success",
        "result": val1 + val2
    })

if __name__ == "__main__":
    # 本地调试运行,默认端口5000
    app.run(host="127.0.0.1", port=5000, debug=True)
10. Pytest:现代Python的单元测试事实标准
许多初学者测试代码全靠频繁写 print(),一旦逻辑复杂,排错极为混乱。Pytest 彻底摒弃了繁琐的类封装模板,只需要编写带有 assert 的测试函数,即可自动发现并运行所有测试用例。
- 适用场景:核心算法输入边界检查、数据清洗逻辑正确性回归、持续集成自动化校验。
- 安装命令:
pip install pytest
# test_calculation.py 文件内容
def add(a: int, b: int) -> int:
    return a + b

def test_add_positive():
    assert add(2, 3) == 5

def test_add_negative():
    assert add(-1, 1) == 0

# 运行测试命令:在终端执行 pytest test_calculation.py
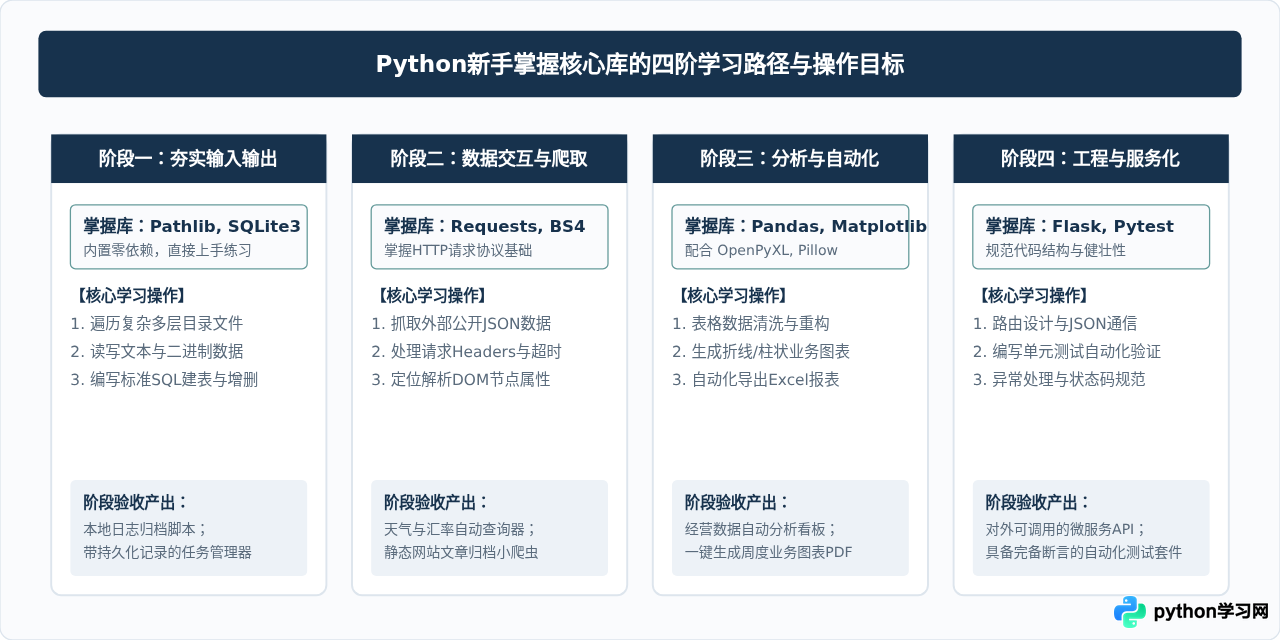
六、10个核心常用库综合选型对照
为了便于随时查阅,下表与对照矩阵从安装方式、学习曲线、核心优势及主要限制四个维度,对这10个库进行了全面梳理:
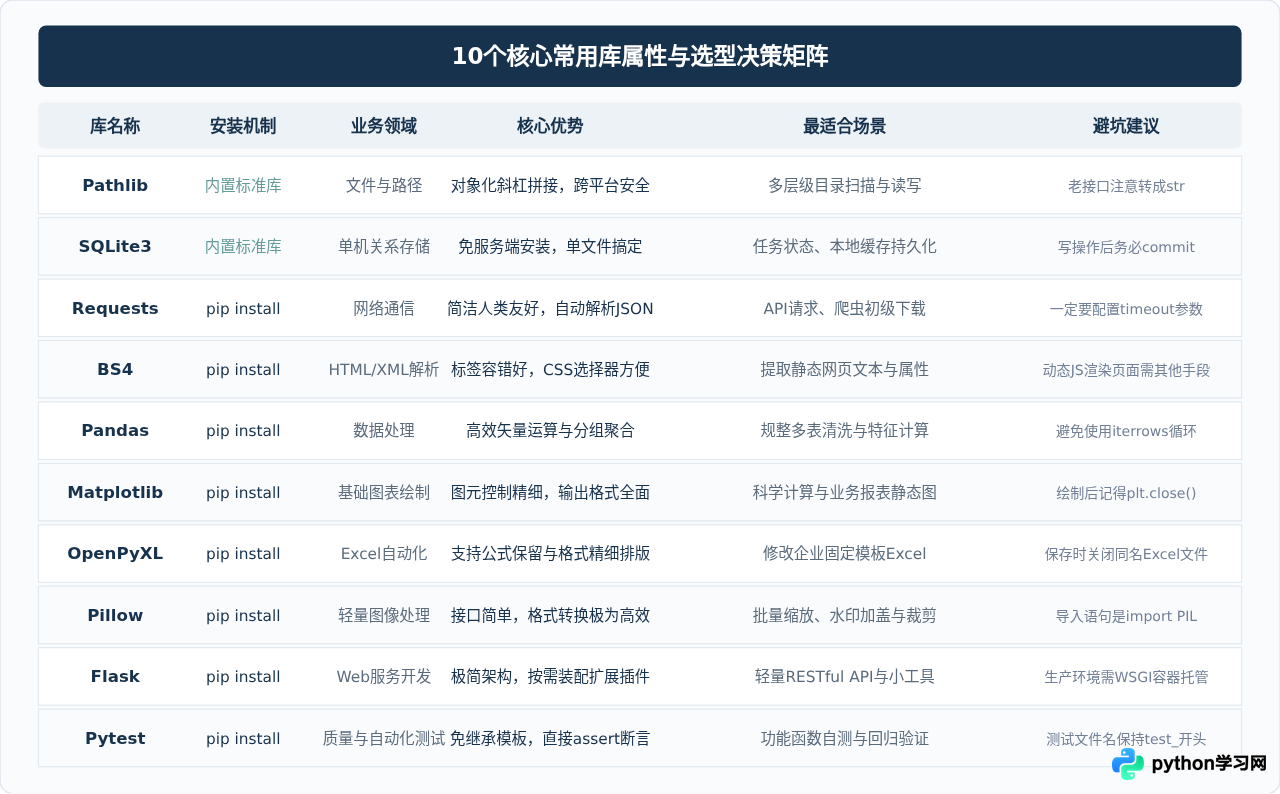
七、新手的环境管理与最佳实践
掌握了这10个库之后,很多新手容易直接在系统全局 Python 环境下运行 pip install ...,随着时间推移,不同库之间的依赖版本冲突会导致整个环境瘫痪。以下是每个新手都应当养成的工程习惯:
- 务必使用虚拟环境:在项目目录下运行
python -m venv .venv,激活后再安装第三方库。这能确保项目之间的库版本完全隔离,随时可删除重建。 - 记录依赖清单:在交付或归档项目时,运行
pip freeze > requirements.txt记录当前环境下确切的库版本,方便在其他计算机上通过pip install -r requirements.txt一键还原。 - 优先查阅官方文档的 Quickstart:这10个库之所以流行,是因为它们都维护了极其规范的新手起步指南。遇到不确定的参数,直接查看其英文或中文官方文档,往往比在网络搜索二手片段更为准确。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















