


Python中换行符\n的表示与print函数自动换行控制

在Python中,换行符统一使用转义序列 \n 进行表示,其本质对应ASCII码表中的换行字符LF(Line Feed,十六进制为 0x0A)。而在使用内置的 print() 函数输出文本时,解释器默认会在内容结尾自动附加一个换行符,这是因为该函数的行尾结束参数 end 默认取值为 '\n'。如果希望在多次打印之间保持同行显示、自定义连接符或精确排版控制,只需向 print() 函数显式传入 end 参数即可。本文将从转义表示的底层机制、end 参数的控制逻辑、常见输出场景以及终端缓冲刷新等维度展开系统讲解。
一、换行符\n的表示与转义解析机制
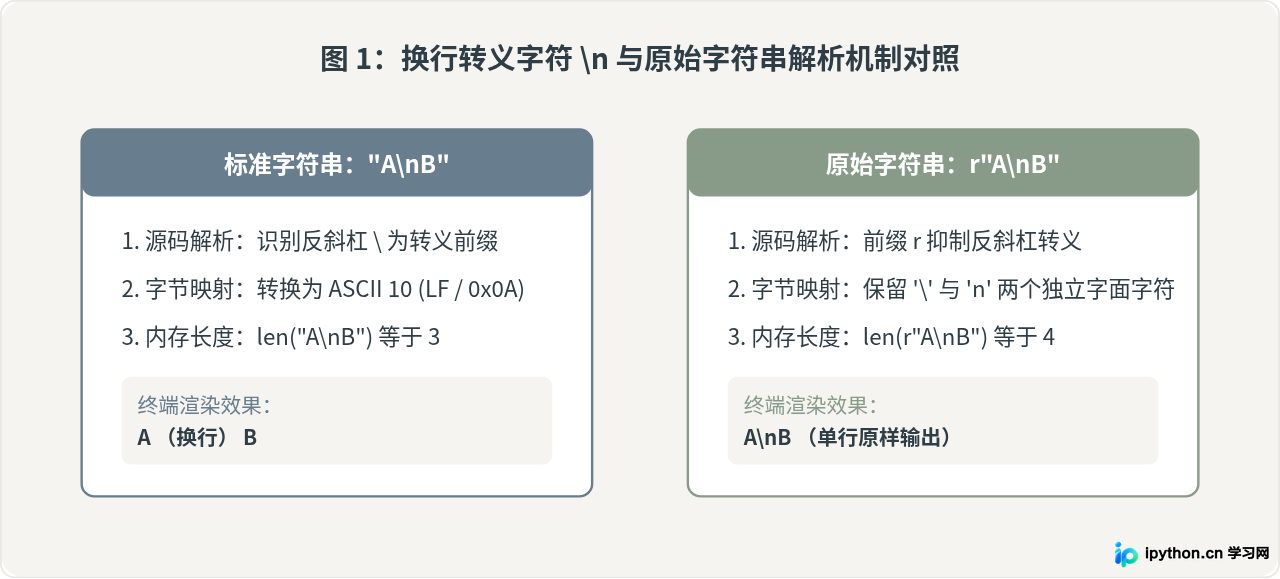
在Python字符串字面量中,反斜杠 \ 被定义为转义引导符。当反斜杠后紧跟字母 n 时,Python词法分析器不会将其视作两个普通独立字符,而是合并解释为一个代表换行功能的单一特殊字符 \n。
# 包含换行转义字符的字符串
text = "第一行内容\n第二行内容"
print(text)
示例输出如下:
第一行内容
第二行内容
除了普通的转义表示之外,Python还提供了原始字符串(Raw String)机制。通过在字符串前添加前缀 r 或 R,可以抑制反斜杠的转义解析。在原始字符串中,\n 不会被转换成换行控制符,而是作为反斜杠与字母n两个字面字符被完整保留。这一机制在书写正则表达式或Windows文件路径时尤为常用。
二、print函数的默认换行行为与end参数
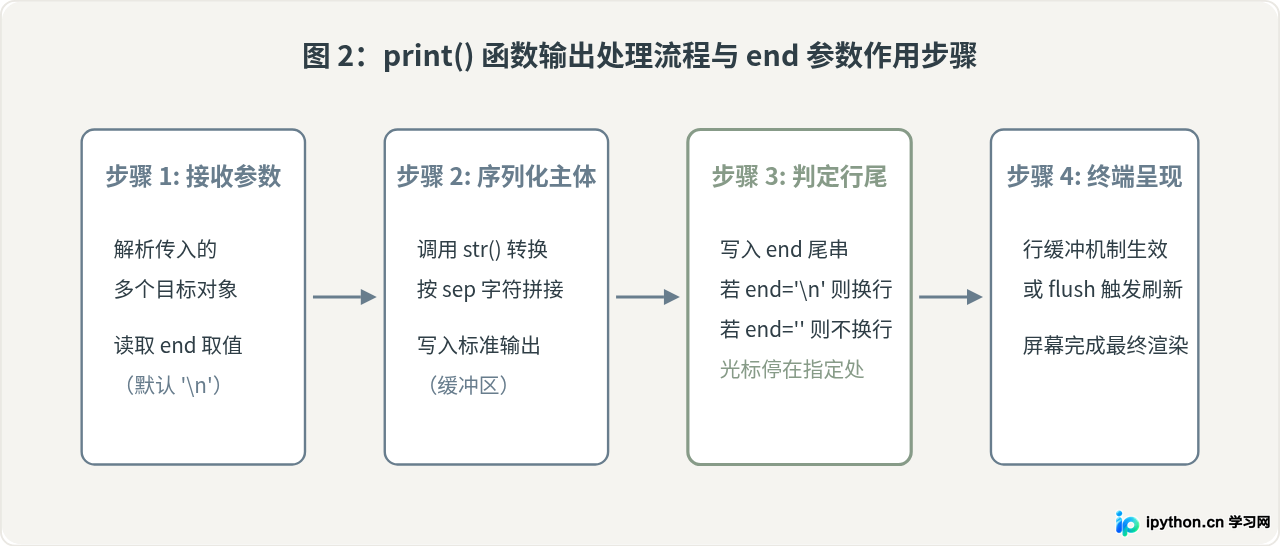
初学者常常误以为自动换行是字符串本身的属性,但实际上这是 print() 函数的标准行为。我们先观察该函数的完整参数签名:
print(*objects, sep=' ', end='\n', file=None, flush=False)各个参数的分工非常明确:
*objects:表示需要输出的一个或多个对象,多个对象之间会用sep指定的字符分隔(默认为空格)。end:表示所有对象输出完毕后,最终追加在末尾的字符串。其默认值正是'\n'。
由此可见,每次执行 print(),系统在向标准输出流写入所有内容后,都会隐式调用一次 end 指定的字符。因为默认值是 '\n',光标随之移动到下一行的行首,从而表现出“自动换行”的现象。
三、精准控制print换行行为的实操方法
根据具体的排版需求,可以通过给 end 赋予不同字符串来实现灵活的输出效果。
1. 取消自动换行(无缝拼接)
将 end 参数显式设置为空字符串 '',后续的 print() 将直接紧接在上一次输出的末尾打印:
print("正在加载数据", end='')
print("...", end='')
print("完成!")
示例输出:
正在加载数据...完成!2. 使用自定义分隔符代替换行
在循环输出序列元素时,如果希望全部在一行展示并以空格或逗号间隔,可以将 end 设为对应的分隔符:
# 用空格水平排布数字
for i in range(1, 6):
    print(i, end=' ')
print()  # 打印一个空行,恢复光标至下一行首
示例输出:
1 2 3 4 5 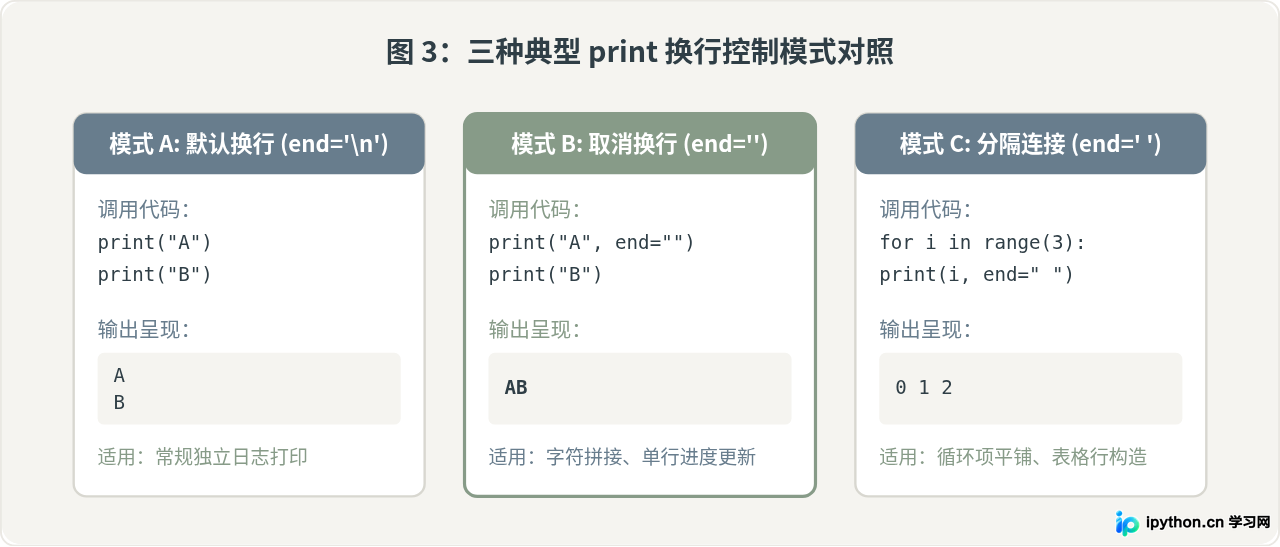
四、缓冲机制配合与常见注意事项
在实际控制换行时,有两项非常关键的底层细节需要特别注意:
1. 终端行缓冲与 flush 参数
标准输出流(sys.stdout)在大多数终端环境中采用行缓冲策略。这意味着程序在遇到换行符 \n 时才会立刻将缓冲区中的文本刷新并绘制到屏幕上。如果将 end 设置为 '' 并且在耗时任务循环中输出,可能会出现内容卡在缓冲区迟迟不显示、直到程序结束才一次性弹出的情况。
解决此问题的方法是在设置 end='' 的同时传入 flush=True,强制立即刷空输出流:
import time

# 实时刷新进度点
for _ in range(5):
    print(".", end="", flush=True)
    time.sleep(0.5)
print(" 完毕")
2. 跨平台换行符规范与清理
不同操作系统的换行规范在历史上存在差异:Unix/Linux/macOS使用 \n(LF),而Windows传统上使用 \r\n(CRLF)。Python在处理文本文件读写时,内部默认采用通用换行模式(universal newlines),会自动将不同平台的换行符统一抽象转化为 \n。
在读取文件单行并使用 print() 再次输出时,由于读取到的每行末尾已经自带了 \n,如果直接调用默认的 print(),会导致行与行之间多出一个空行。此时应先调用 rstrip('\n') 去除原行尾,或者明确将 print() 的 end 设为 '':
# 规范处理文件行输出,避免双重换行
with open("data.txt", "r", encoding="utf-8") as f:
    for line in f:
        # 方法一:去除原生末尾换行符
        print(line.rstrip('\n'))
        # 方法二:保留原生换行符,print不再额外追加
        # print(line, end='')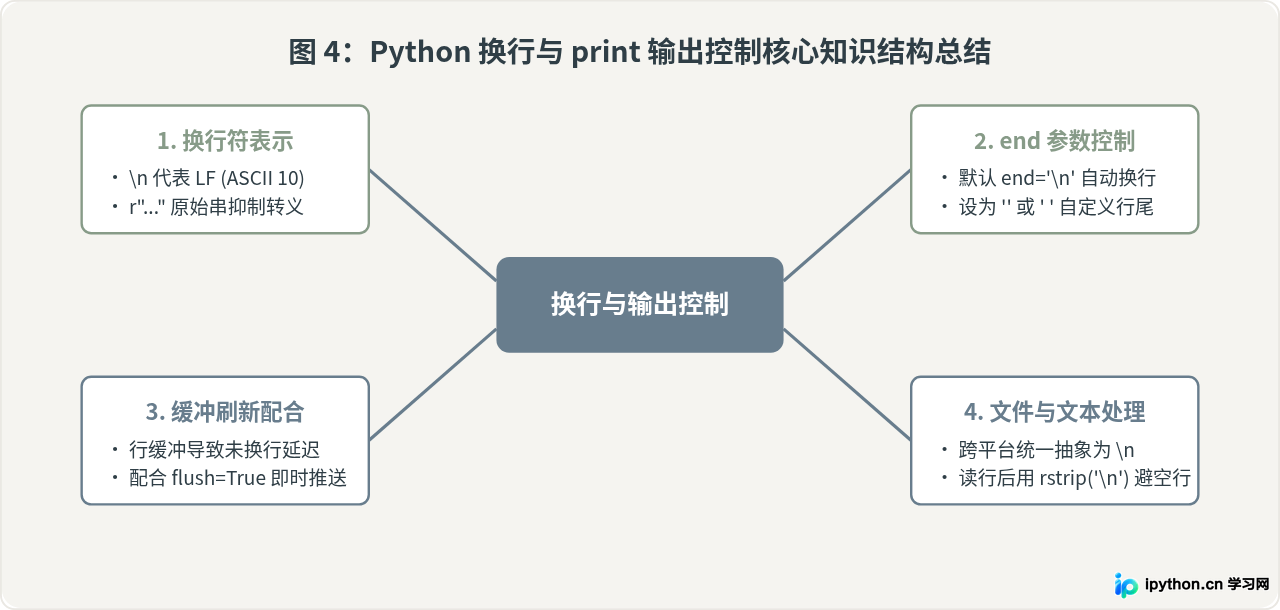
五、核心结论与快速选用建议
总结全文,掌握Python中的换行控制只需牢记以下要点:
- 表示层面:换行符在普通字符串中表示为
\n;若要在字面上保留反斜杠与字符n,应使用原始字符串r"..."。 - 函数行为:
print()的换行行为完全由其关键字参数end决定。取消自动换行传入end='',水平平铺传入end=' '。 - 协同参数:在取消换行进行单行进度显示等场景中,务必配合
flush=True避免终端行缓冲导致的显示滞后;读取文本行时注意剥离原生\n以防产生非预期双重空行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















