


怎么利用编程狮Python题库高效刷题与整理错题

一、认识编程狮Python题库的结构特征与使用定位
很多初学者在打开题库时容易产生一个误区:把它当成类似LeetCode的复杂算法竞技场,或者当作一本单纯用来“从第1题按顺序做到第500题”的静态试卷。这种定位往往会导致在前期消耗大量时间却收获甚微。
编程狮题库的核心优势在于题目设计偏向基础概念检验、核心内置函数运用、常见语法结构辨析以及小巧的代码填空与逻辑纠错。它的特点是答题周期短、即时判定快、知识点切片清晰。因此,它的合理定位应是:验证语法理解的测试仪与查漏补缺的扫描网,而不是高难度工程架构训练器。
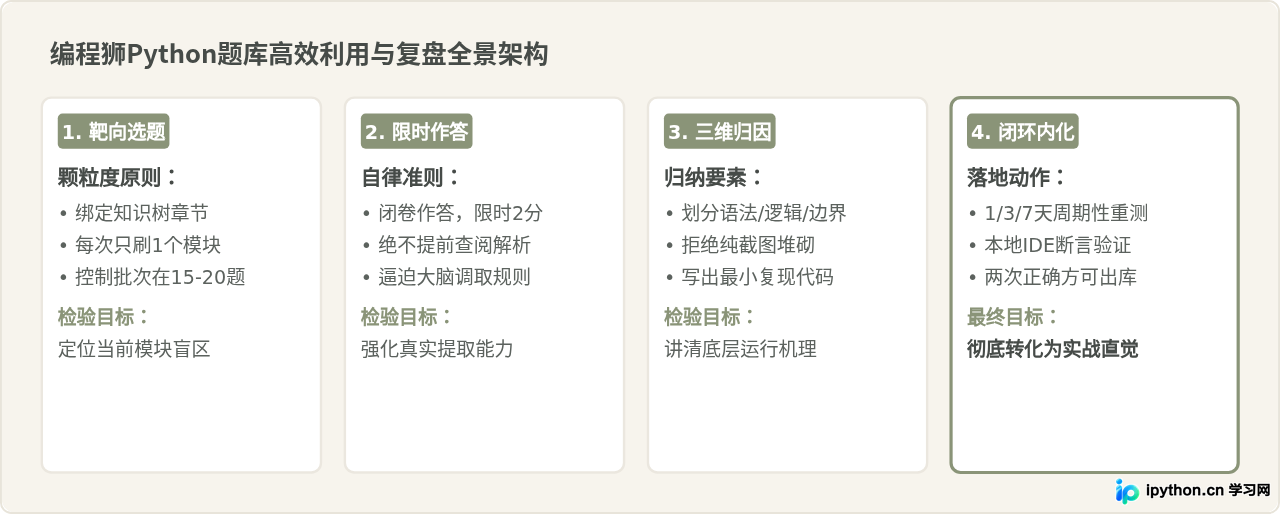
明确这一定位后,刷题策略就应当从“盲目追求做题数量”转向“单位时间内的概念覆盖率与错误识别率”。在开始做题前,建议先按Python的基础知识树(变量与类型、流程控制、容器操作、函数与参数、异常处理、模块运用)划定章节,每次只针对单一模块集中答题,以形成连贯的认知强化。
二、高效刷题的五步闭环流程
为了保证做题过程转化为长期的代码编写直觉,应当遵循明确的执行节奏。以下是针对编程狮题库特点设计的五步高效刷题流程:
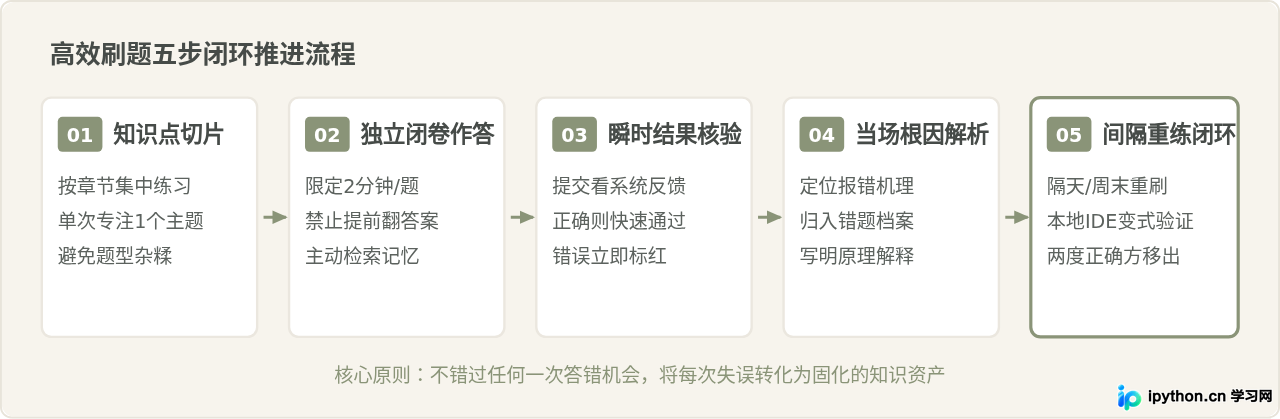
- 知识点切片定向:进入题库后,不要使用“随机模式”,而是根据当前的阶段性学习进度选择对应小节。例如今日专注练习“字典与集合的遍历及其内置方法”,集中完成15至20道题。
- 限定时间的独立闭卷作答:微型题目一般不涉及繁杂架构,应为每道题设定1到2分钟的思考时间。作答过程中严禁提前查看答案或评论区提示,强制大脑完成语法规则的检索提取。
- 瞬时结果核验:点击提交后,根据系统判定立即分类。对于完全掌握且顺利AC(Accepted)的题目直接通过,不在此类熟练区耗费额外时间;对于答错或猜测正确的题目,立即标记。
- 当场根因解析:出现错误后,不要仅停留在“哦,原来这题选B”或“原来这里要加冒号”,必须立即停下来查验报错背后的解释,并随手完成第一道记录。
- 间隔重练闭环:建立复盘机制,在24小时后及周末对错题进行第二轮闭卷重做。连续两次在间隔期做对的题目,才能视为真正掌握并归档。
三、拒绝抄答案:错题整理的三维根因分类法
错题整理中最常见的低效行为是机械式的“搬运”。把原题截图粘贴在笔记本里,下面附带正确答案代码,这种做法虽然给学习者带来“我很用功”的心理安慰,但再次面对变式题时依然容易出错。
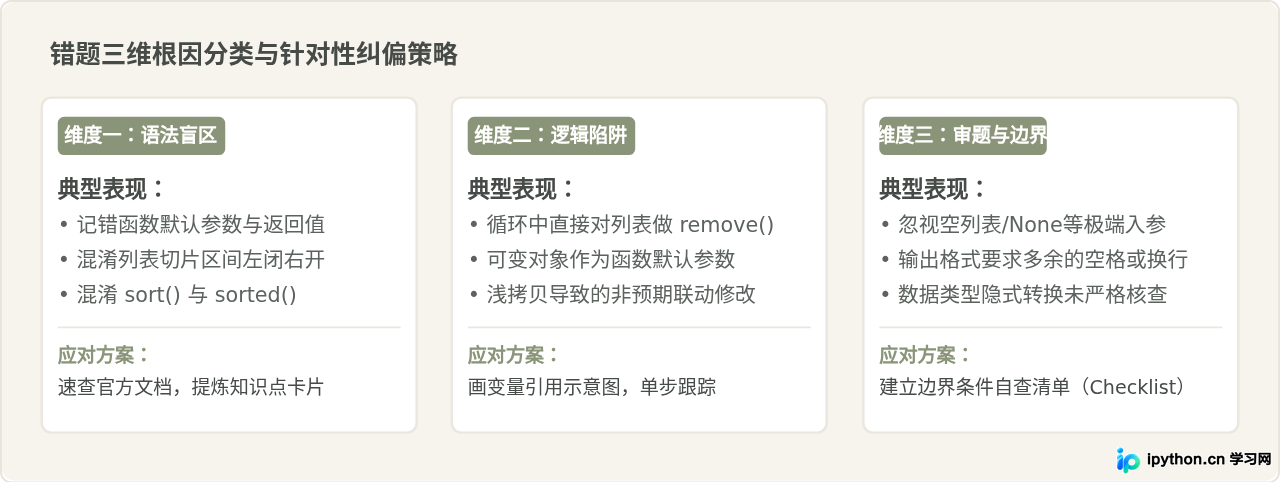
整理错题的关键在于归因分类。每道做错的Python题目,其根源通常可以拆解为三个明确维度:
实用的结构化错题记录模板
整理错题不需要长篇大论,建议在本地使用Markdown文档或专用的错题脚本文件进行记录。每道错题必须包含以下四个要素:
- 题目简述与原考点:例如“列表就地排序与返回新列表的区别”。
- 错误代码及报错反馈:记录当时自己的第一反应写法以及系统抛出的错误或差异。
- 根因分析:用一两句话讲清为什么错(例如:
list.sort()是就地操作,返回值为None,将其赋值给新变量导致后续调用报AttributeError)。 - 极简最小纠偏示例(Minimal Reproducible Example):给出能够直接在本地Python解释器中验证的最短有效代码。
# [考点] 列表排序方法区分
# [错误写法]
nums = [3, 1, 4, 1, 5]
sorted_nums = nums.sort()  # 错误:sorted_nums 值为 None

# [根因分析]
# list.sort() 是列表的原生方法,直接修改原列表并返回 None;
# 若需要保留原列表并返回新列表,应使用内置函数 sorted()。

# [正确写法对比]
nums = [3, 1, 4, 1, 5]
# 方式 A:原地修改
nums.sort()
print(nums)  # 输出: [1, 1, 3, 4, 5]

# 方式 B:生成新列表
origin = [3, 1, 4, 1, 5]
new_nums = sorted(origin)
print(new_nums)  # 输出: [1, 1, 3, 4, 5]
print(origin)    # 原列表保持不变: [3, 1, 4, 1, 5]
四、认知辨析:易混淆说法的合理性与修正边界
在学习社区中,常常流传着“刷题只要量大自然就会写代码”与“题库都是死记硬背,做题毫无意义”这两种截然相反的说法。这两种观点在特定条件下都有合理性,但也各自存在认知偏差。
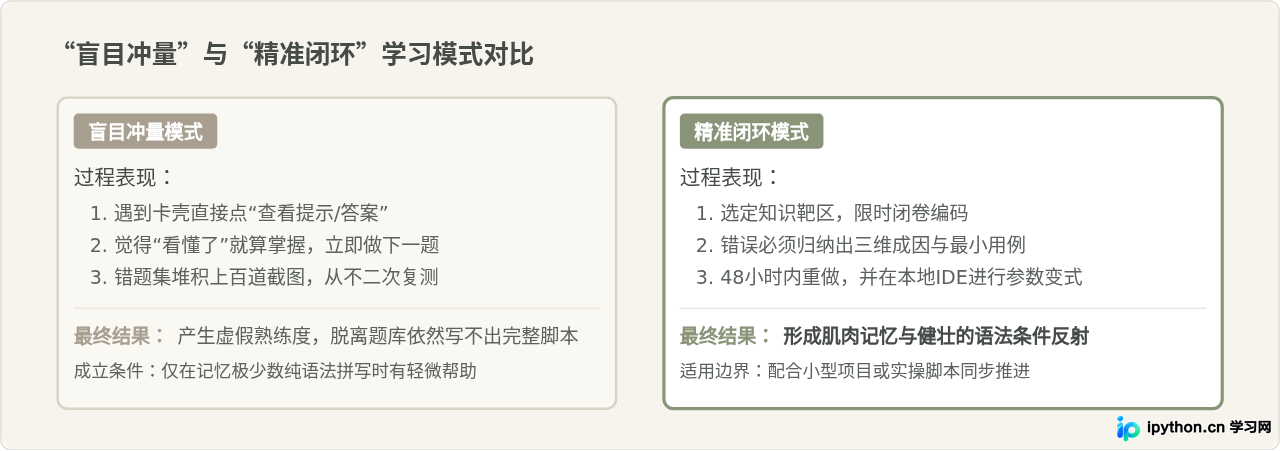
辨析一:“刷题冲量越大越好”的合理性与边界:
“冲量”在初学者刚接触语法的头一两周确实有效。比如记住 len()、range()、切片规则以及字典的 .items() 遍历方式,做30到50道微练习能够迅速消除对符号和关键字的陌生感。然而,它的成立边界仅仅局限于语法机械记忆阶段。一旦跨过这个阶段,刷题如果不带思考与归因,做100道同质化的选择题,并不能帮助你理解为什么在多线程下全局变量需要加锁,也不能帮你理清生成器与迭代器的惰性求值差异。冲量必须受限于“知识覆盖面”,而非在低水平重复中消耗精力。
辨析二:“做题毫无意义,不如直接上手写项目”的合理性与边界:
项目驱动学习确实是软件开发的终极路径,但直接做项目的前提是开发者对语言的基础语法有最低限度的流畅度。如果在开发爬虫或Web接口时,频频因为“字典取不存在的键报 KeyError”、“可变默认参数累积数据”、“浮点数精度误差判断出错”而停下来排错两小时,开发信心就会被严重打击。因此,利用编程狮这种轻量题库进行高频点穴式刷题,其价值在于扫除语法路障,让后续做真实项目时能专注于业务逻辑,而不是在最底层的语法细节上反复踩坑。
五、建立长效复盘:从题库到本地IDE的实操转化
题库的答题界面通常是受限的在线编辑器或选择框。为了让题库中积累的经验真正转化为工程实操能力,建议建立以下两项落地习惯:
- 本地IDE复现关键错题:不要把所有逻辑都留在网页端。对于典型的逻辑陷阱题目,在本地VS Code或PyCharm中新建一个名为
mistakes_review.py的文件,把错题改写为断言测试(assert),用实际运行与调试器单步走一遍,观察调用栈和变量内存地址的变化。 - 践行艾宾浩斯复盘周期:错题本的价值取决于被重新翻开的频率。建议采用“1天 - 3天 - 7天”的节奏:当天整理好的错题,次日清晨快速重答;第3天尝试脱离提示在本地复现;第7天进行批量盲测。如果再次答错,则说明上一次的归因没有击中要害,需要重新查阅官方文档。
六、常见答题陷阱与避坑提醒
在利用编程狮Python题库刷题的过程中,还有几个高频出现的细节容易干扰学习成效,需要特别留意:
- 辨清Python版本差异:题库中绝大多数题目基于现代Python 3,但偶尔会遇到涉及除法运算(例如
/与//)或打印函数print()的历史特性题目。遇到题目与现代语法不符时,应以Python 3.8+的官方规范为准,不必强行去记忆已经淘汰的旧语法。 - 警惕“假性理解”:如果在看解析时产生“我本来就知道”的念头,请务必在空白编辑器里把代码完整敲一遍。多数人在写到第3行时就会卡在冒号、缩进或方法名大小写上,敲代码的指尖阻力才是真实的水平标尺。
- 适时离开题库进入实战:当基础章节的正确率稳定在85%以上、常见内置容器方法能脱口而出时,题库的历史使命就已经基本完成。此时应当果断转向小型爬虫、自动化脚本或数据处理任务,让刷题积累的语法资产在真实代码中发挥价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















