


Python绘图库全景盘点:Matplotlib、Seaborn与Plotly核心特点

在 Python 数据科学与可视化生态中,Matplotlib、Seaborn 与 Plotly 分别代表了底层基础图元引擎、统计建模高阶封装以及现代 Web 交互式图表三大演进方向。选择绘图工具的核心在于匹配交付场景:需要出版级静态排版与像素级微调时依赖 Matplotlib,进行多维探索性数据分析时使用 Seaborn 提升编写效率,而面向浏览器展示、动态汇报与大屏交付时则应当选择 Plotly。本文将深入剖析三者的架构分层、对象模型、核心实战代码与工程选型依据,帮助读者建立系统的数据可视化技术选型认知。
一、三大绘图库核心定位与架构分层
Python 数据可视化并非单一工具的竞争,而是一个高度分层、各司其职的协作网络。理解各个库在调用链中的所处位置,是避免重复造轮子和解决底层冲突的前提:
- Matplotlib(底层图元基石):诞生最早、生态最广泛的静态绘图底座。它实现了类似 MATLAB 的面向对象图元树,上层库(包括 Seaborn、Pandas 内置绘图)均依赖其
Figure与Axes对象进行栅格化或矢量化渲染。 - Seaborn(统计语义增强高阶库):直接构建在 Matplotlib 之上,专为统计探索和多变量分析设计。它与 Pandas 深度整合,自动处理分组、统计置信区间与调色板,大幅降低了绘制热力图、分面图和回归曲线的代码量。
- Plotly(Web 交互式现代化引擎):架构完全独立于 Matplotlib。Python 端 Plotly 充当数据规格定义层,输出标准 JSON 图表规范,并在客户端调用 Plotly.js(基于 D3.js 和 WebGL)实现原生缩放、悬停、筛选与动态响应。
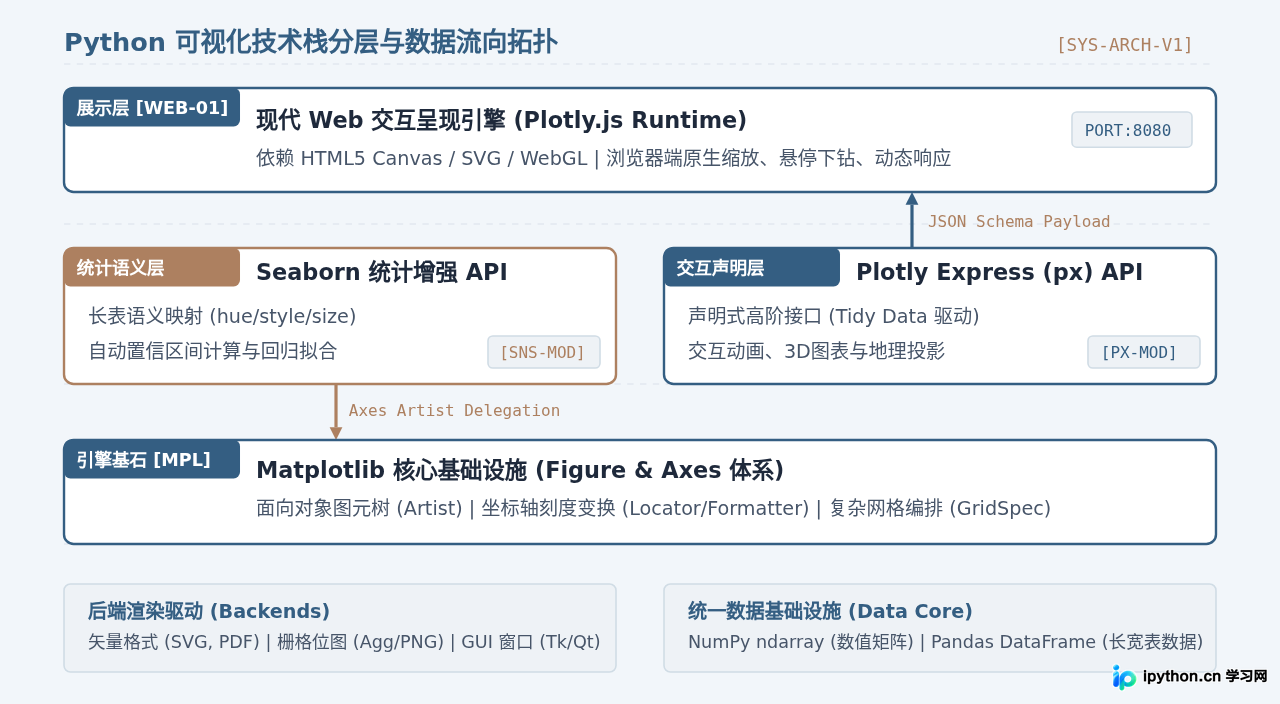
图1:Python主流绘图库技术栈分层与数据流向架构
二、Matplotlib:精密控制的底层基石与面向对象模型
Matplotlib 最根本的优势在于对画布图元的绝对控制。许多初学者容易混淆其两种不同的使用接口:
- pyplot 状态机接口:类似于
plt.plot(),内部维护当前激活的画布和坐标系,适合在 Jupyter Notebook 中执行简单的单步探索,但在复杂多子图排版时极易引发状态污染。 - 面向对象(OO)接口:显式创建
fig, ax = plt.subplots()。fig(Figure 对象)代表整个图形容器,ax(Axes 对象)代表具体的子图坐标系。所有曲线、网格、文字和图例均作为子对象依附于特定Axes,在工程化项目中具有高度的可复现性与稳定性。
import matplotlib.pyplot as plt
import numpy as np

# 1. 显式初始化画布与坐标系
fig, ax1 = plt.subplots(figsize=(8, 4.5), dpi=120)

x = np.linspace(0, 10, 100)
y1 = np.sin(x)
y2 = np.cos(x) * 10

# 2. 主轴绘制正弦波
line1 = ax1.plot(x, y1, color="#345E82", linewidth=2.0, label="信号振幅 (V)")
ax1.set_xlabel("时间序列 (s)", fontsize=11)
ax1.set_ylabel("振幅 (V)", color="#345E82", fontsize=11)
ax1.tick_params(axis="y", labelcolor="#345E82")
ax1.grid(True, linestyle="--", alpha=0.5)

# 3. 共享X轴创建双Y轴次坐标系
ax2 = ax1.twinx()
line2 = ax2.plot(x, y2, color="#AD8060", linewidth=1.8, linestyle="--", label="导数变化率")
ax2.set_ylabel("变化率 (V/s)", color="#AD8060", fontsize=11)
ax2.tick_params(axis="y", labelcolor="#AD8060")

# 4. 合并图例并优化边距
lines = line1 + line2
labels = [l.get_label() for l in lines]
ax1.legend(lines, labels, loc="upper right", framealpha=0.9)
ax1.set_title("Matplotlib 面向对象双轴精密图表示例", fontsize=13, pad=12)

fig.tight_layout()
# plt.savefig("dual_axis.svg", format="svg") # 矢量导出三、Seaborn:面向统计探索的高阶声明式表达
Seaborn 的设计哲学是让统计分析人员能够“直接对数据提问”。它强制推崇长表数据结构(Long-form / Tidy Data),即每一行代表一个观测样本,每一列代表一个变量属性。
Seaborn 拥有两大维度的 API 体系:
- Axes 级函数(如
scatterplot、barplot、histplot):接受ax参数,能与现有的 Matplotlib 子图网格无缝集成。 - Figure 级函数(如
relplot、catplot、displot):由底层FacetGrid驱动,负责自动创建画布并按row或col维度拆分子图,非常适合分析多因子分类变量。
import seaborn as sns
import pandas as pd
import numpy as np

# 构造结构化长表数据 (Tidy Data)
np.random.seed(42)
df = pd.DataFrame({
    "迭代轮次": np.repeat(np.arange(1, 21), 4),
    "损失值": np.random.exponential(scale=1.0, size=80) * np.exp(-np.repeat(np.arange(1, 21), 4) / 8),
    "优化算法": np.tile(["SGD", "Adam", "RMSprop", "AdaGrad"], 20),
    "执行集群": np.tile(["Cluster-A", "Cluster-B"], 40)
})

# 设置工程主题样式
sns.set_theme(style="whitegrid", font="sans-serif")

# Figure 级关系图:自动计算均值曲线与95%置信区间阴影
g = sns.relplot(
    data=df,
    x="迭代轮次", y="损失值",
    hue="优化算法", style="优化算法",
    col="执行集群",
    kind="line",
    palette=["#345E82", "#AD8060", "#2B4C6F", "#6B7280"],
    height=4, aspect=1.2
)

g.set_axis_labels("训练迭代轮次 (Epoch)", "交叉熵损失")
g.set_titles(col_template="实验环境:{col_name}")
四、Plotly:现代 Web 交互与动态可视化的利器
当报表交付对象需要探索细节时,静态图片无法满足下钻需求。Plotly 原生支持现代 Web 交互机制:
- Plotly Express(
px):统一的极简高阶入口,用一行代码即可映射色彩、尺寸、悬停提示及动态时间轴切片。 - Graph Objects(
go):底层低阶图元模块,提供如go.Figure(data=[...], layout=...)的精密拼装能力,适合构建非标准复合图。 - 零依赖交付:执行
fig.write_html("report.html")即可生成一个包含数据与完整交互逻辑的单一自包含网页文件,无需搭建后端服务。
import plotly.express as px
import pandas as pd

# 加载多维业务度量示例
df = pd.DataFrame({
    "服务器节点": ["Node-01", "Node-02", "Node-03", "Node-04", "Node-05"],
    "CPU利用率": [78.4, 45.2, 89.1, 32.0, 64.5],
    "内存使用量_GB": [64, 32, 128, 16, 48],
    "机房区域": ["华北-A", "华东-B", "华北-A", "华南-C", "华东-B"],
    "请求QPS": [12500, 4800, 18900, 2200, 9300]
})

# 一行代码声明式构建富交互散点图
fig = px.scatter(
    df,
    x="CPU利用率", y="内存使用量_GB",
    size="请求QPS", color="机房区域",
    hover_name="服务器节点",
    color_discrete_sequence=["#345E82", "#AD8060", "#2B4C6F"],
    title="集群负载核心度量分布图 (支持缩放与图例筛选)"
)

# 链式定制交互外观
fig.update_layout(
    font_family="PingFang SC, Microsoft YaHei, sans-serif",
    plot_bgcolor="#F2F6FA",
    legend=dict(orientation="h", yanchor="bottom", y=1.02, xanchor="right", x=1)
)
# fig.show() # 打开浏览器交互渲染
五、从数据准备到图表呈现的标准实操流程
在工程落地中,高质量图表的产出不是随意调用绘图函数,而需要遵循严格的标准作业工序:
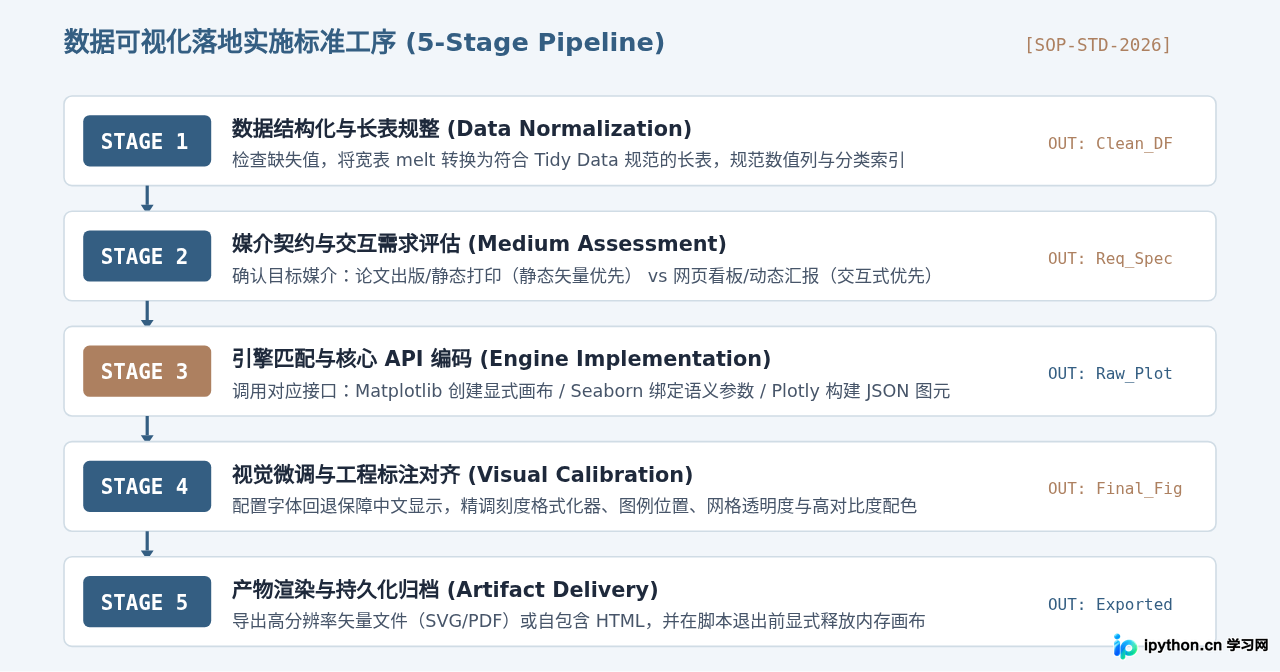
图2:数据可视化工程落地端到端实施流程
六、三大库核心对象模型与编程范式横向对比
为了直观呈现各工具的本质差异,我们将三者的对象树、核心概念与执行模式进行横向解构:
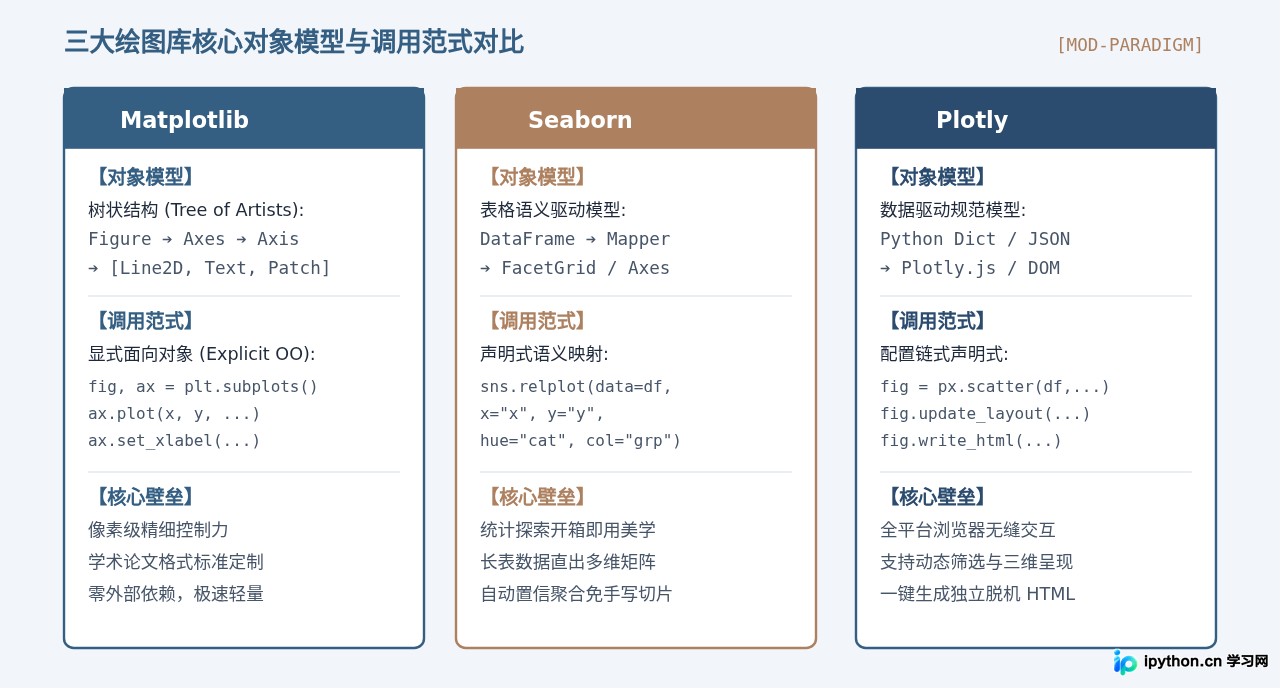
图3:三大绘图库对象模型与编程接口调用范式横向对比
| 对比维度 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 主导范式 | 显式面向对象 (Object-Oriented) | 声明式语义映射 (Semantic) | 配置驱动与 JSON 规范 |
| 数据输入要求 | Numpy 数组、List、宽/长格式表 | 严格长格式表 (Tidy Dataframe) | Pandas Dataframe 或字典序列 |
| 底层渲染技术 | C/Agg、PostScript、SVG 矢量 | Matplotlib 渲染管线 | Plotly.js (HTML5 / WebGL) |
| 交互支持能力 | 仅限本地 GUI 简单按键事件 | 静态无交互(依赖后端) | 原生丰富交互(悬停/框选/缩放) |
| 学习曲线 | 较陡峭(需掌握坐标树概念) | 平缓(开箱即用,高阶依赖MPL) | 平缓(px接口简洁,深层go较复杂) |
七、场景化选型矩阵与避坑决策指南
面对具体业务需求时,可依照以下判定树进行快速决策:
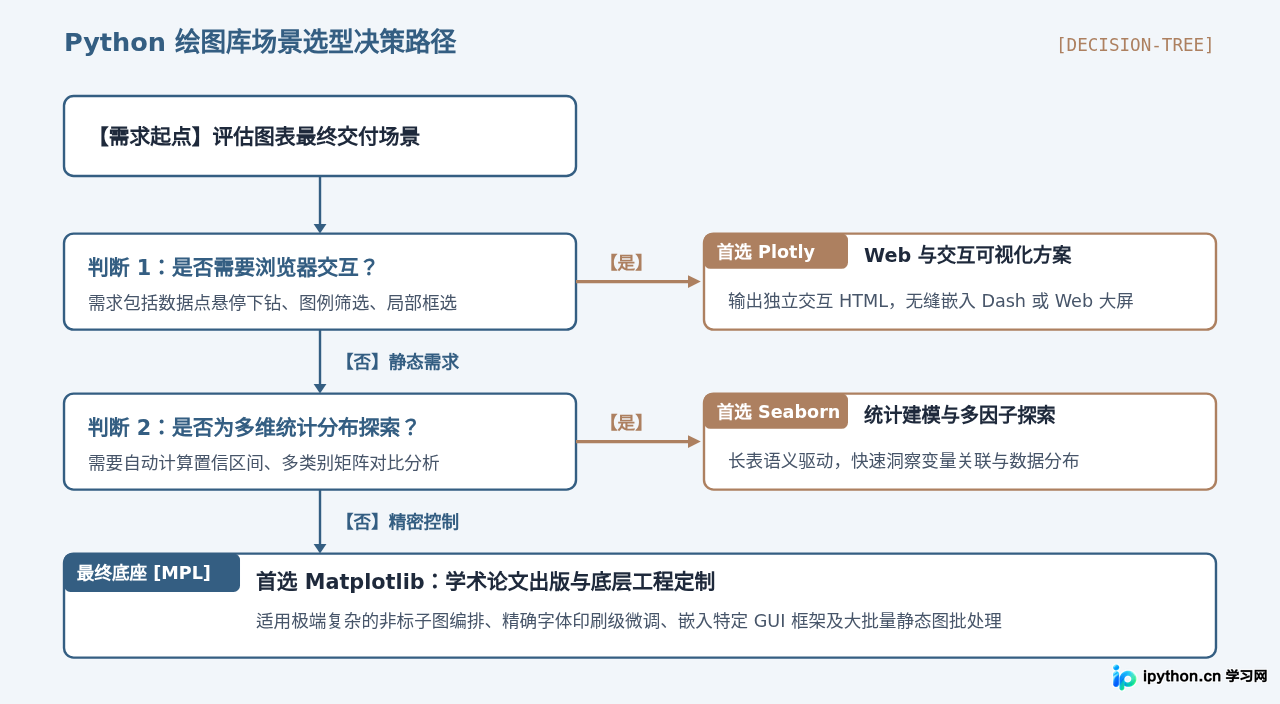
图4:Python绘图库场景选型决策路径与能力维度盘点
实战开发中的三个避坑要点
- 中文乱码与字体缺失:Matplotlib 默认不自带中文字体,若未配置字体列表,中文标签将显示为方块豆腐块。在脚本开头需显式指定系统已有字体族:
import matplotlib.pyplot as plt plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif'] plt.rcParams['axes.unicode_minus'] = False # 解决负号显示异常 - 内存泄漏与画布未释放:在循环批量生成图表或服务端处理请求时,使用
plt.figure()不会自动销毁对象。必须在导出后显式调用plt.close(fig)或在上下文管理器中执行,防止内存线性飙升。 - 大数据量交互卡顿:Plotly 默认采用 SVG 绘制常规散点图,当数据点数量达到数万级别时,浏览器 DOM 节点剧增会导致严重卡顿。对于超大数据集,必须切换为 WebGL 驱动图元(例如使用
go.Scattergl替代go.Scatter)以实现 GPU 加速。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















