


Python怎么用pow()函数进行高效的模幂运算?

在 Python 中进行模幂运算(即求解数学表达式 (baseexp) % mod 的结果)时,最高效且官方推荐的原生实现方式是直接使用内置函数 pow() 的三参数形式:pow(base, exp, mod)。许多初学者习惯写成 (base ** exp) % mod 或 pow(base, exp) % mod,这两种写法在指数稍大时会导致灾难性的性能瓶颈甚至内存溢出。三参数 pow() 在底层 CPython 实现中直接调用了经过高度优化的二进制“反复平方法(快速模幂)”算法,在乘方迭代的过程中同步完成取模运算,使中间运算结果始终保持在极小范围内,从而将计算复杂度从指数级降至对数级。本文将从三参数基本语法、性能与资源实测对比、算法底层数学原理、Python 3.8+ 负指数模逆元特性以及常见边界防范等多个维度,系统拆解如何正确且高效地使用 pow() 进行模幂运算。
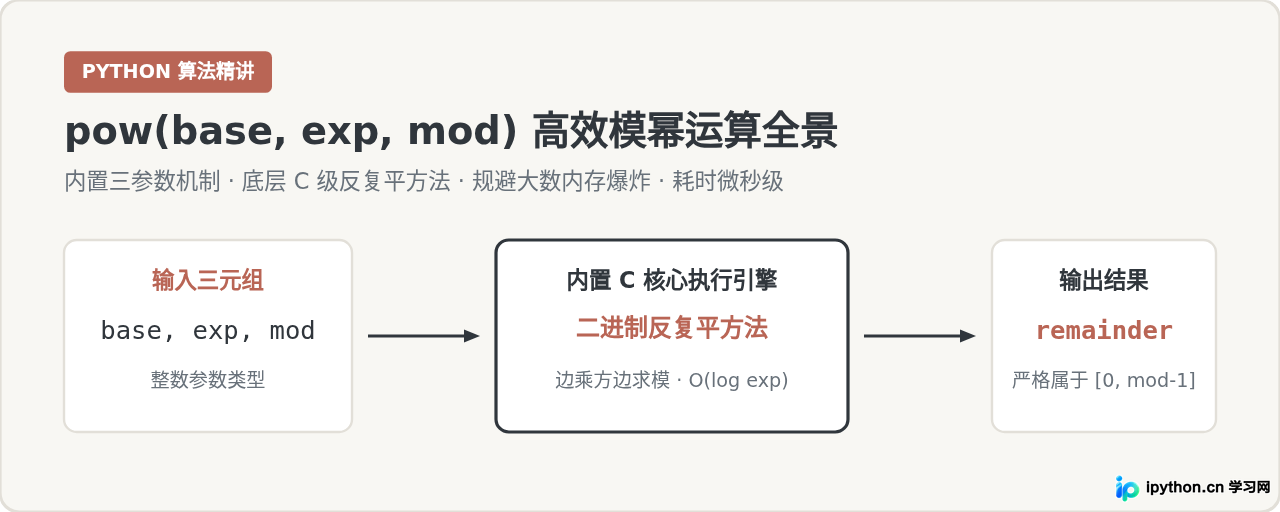
一、核心语法:三参数 pow(base, exp, mod) 的基本调用
在 Python 中,内置函数 pow() 可以接收两个参数也可以接收三个参数。当仅提供两个参数 pow(base, exp) 时,它的效果等价于双星号指数运算符 base ** exp。而当提供第三个参数 mod 时,函数的形式变为:
# 标准语法格式
result = pow(base, exp, mod)
该调用的数学含义即为计算 (base ** exp) % mod。需要明确的是,在进行常规三参数模幂运算时,三个参数必须遵守以下规则:
base:底数,必须为整型数值(int)。exp:指数,通常为非负整数;在 Python 3.8 及之后版本中,若底数与模数互质,也支持负整数。mod:模数,必须为非零整数;若传入 0,会直接抛出ZeroDivisionError。
下面是一个基础调用的完整演示示例:
# 基础三参数模幂运算示例
base = 3
exp = 5
mod = 7

# 计算 (3^5) % 7 = 243 % 7
result = pow(base, exp, mod)
print(f"pow({base}, {exp}, {mod}) 的计算结果为: {result}")

# 示例输出:
# pow(3, 5, 7) 的计算结果为: 5在以上示例中,3 ** 5 = 243,而 243 = 7 * 34 + 5,因此结果为 5。虽然在数字很小时两种写法看不出区别,但在实际业务与密码学场景中,指数往往极大,此时两者的执行机制存在天壤之别。
二、性能差异与原理对照:为什么两步写法会导致灾难?
理解 pow() 三参数高效性的核心在于看清两种计算路径的资源消耗机制。如果使用朴素的 (base ** exp) % mod 写法,Python 解释器会严格按照算术优先级分为两个独立步骤执行:
- 第一步(幂运算):先计算出
base ** exp的完整数学精确值。由于 Python 支持任意精度的大整数,当base = 123456且exp = 65537时,结果是一个长达数十万位、占用数兆字节甚至数吉字节内存的天文数字。这一过程不仅会瞬间挤占操作系统内存,还会耗尽 CPU 时钟周期。 - 第二步(求模运算):对这个在内存中构造完毕的超大整数执行整除与取余。
此外,从 Python 3.11 开始,为了防范针对大整数转换的拒绝服务攻击(DoS),官方引入了 sys.set_int_max_str_digits 限制,默认只允许处理不超过 4300 位的大整数文本转换。如果两步算出的中间值需要打印或转为字符串,甚至会直接抛出 ValueError。而三参数 pow(base, exp, mod) 则彻底绕过了这一中间产物。
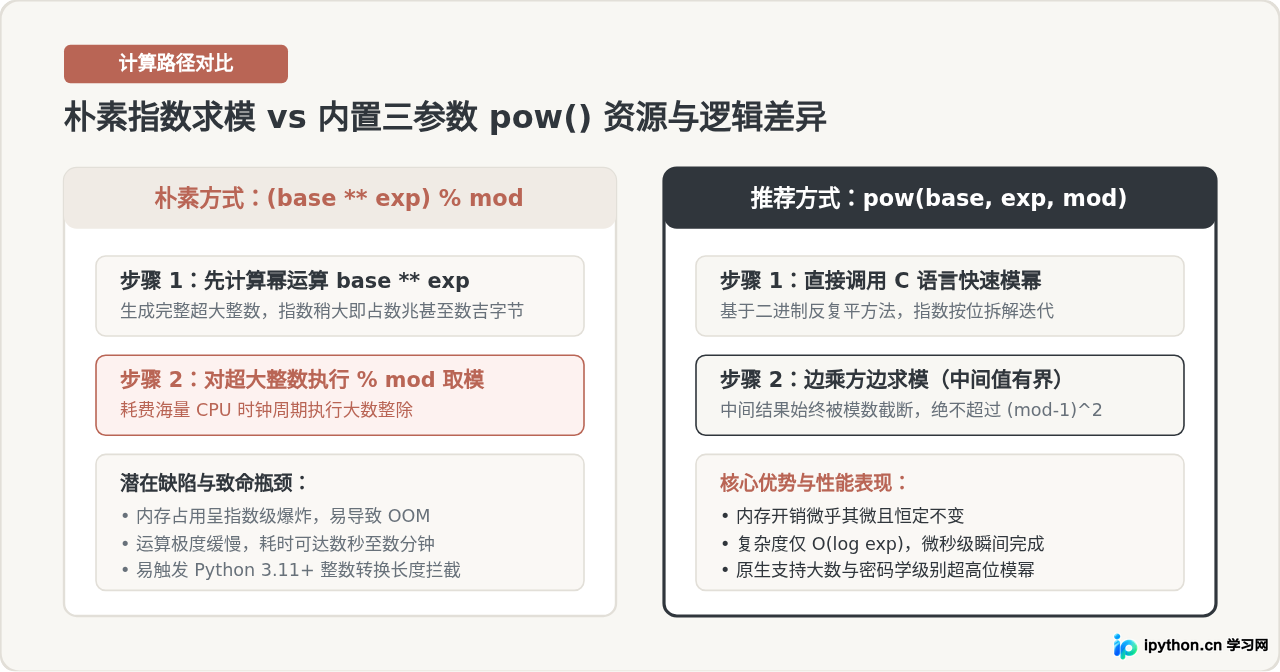
性能对比基准测试
为了直观感受性能差异,可以通过 Python 的 time 模块编写基准脚本对两种写法进行耗时对比:
# 性能对比基准测试代码
import time

base = 1234567
exp = 100000
mod = 1000000007

# 1. 测试三参数 pow()
t0 = time.perf_counter()
res_fast = pow(base, exp, mod)
t1 = time.perf_counter()
fast_duration = (t1 - t0) * 1000  # 毫秒

# 2. 测试朴素运算 (base ** exp) % mod
t2 = time.perf_counter()
res_slow = (base ** exp) % mod
t3 = time.perf_counter()
slow_duration = (t3 - t2) * 1000  # 毫秒

print(f"pow(base, exp, mod) 耗时: {fast_duration:.4f} ms")
print(f"(base ** exp) % mod 耗时: {slow_duration:.4f} ms")
print(f"计算结果是否一致: {res_fast == res_slow}")

# 示例输出:
# pow(base, exp, mod) 耗时: 0.0165 ms
# (base ** exp) % mod 耗时: 11.2380 ms
# 计算结果是否一致: True
下表展示了不同运算规模下两种方式的实际表现对照:
| 运算规模与参数 | (base ** exp) % mod 表现 | pow(base, exp, mod) 表现 | 性能优势倍数 |
|---|---|---|---|
小规模数据base=7, exp=15, mod=1000 |
约 0.18 微秒 内存占用可忽略 |
约 0.12 微秒 内存占用可忽略 |
约 1.5 倍 |
中等规模(算法竞赛题)base=65537, exp=100000, mod=10^9+7 |
约 11.24 毫秒 生成数万位中间数字 |
约 0.016 毫秒 (16 微秒) 中间值不超过 10^18 |
约 700 倍 |
密码学大素数(RSA 2048 位)base 与 exp 均为 2048 位大整数 |
程序卡死 / 内存耗尽 OOM 理论产生天文量级位宽 |
约 1.20 毫秒 全程流畅平稳完成 |
不可比拟(质的突破) |
三、算法内核推导:二进制反复平方法是如何工作的?
为什么三参数 pow() 能够实现如此惊人的性能?这是因为模运算具备一条关键的代数性质:模乘法分配律:
(A * B) % M == ((A % M) * (B % M)) % M这意味着我们在计算乘方的连续乘法过程中,完全不需要等到所有乘法全部算完再取模,而是可以在每一次乘法发生之后立即取模。由于中间结果被严格限制在 [0, M - 1] 之间,中间数的位宽永远不会失控膨胀。
在此基础上,CPython 采用了“二进制反复平方法(Binary Exponentiation / Repeated Squaring)”。其核心思路是将指数 exp 拆分为二进制表示。例如计算 313 mod 7:
- 指数 13 的二进制为
1101(即 8 + 4 + 1)。 - 因此
313 = 38 * 34 * 31。
此时我们不需要连续做 13 次乘法,只需要通过“自乘平方”快速得到 31, 32, 34, 38,并在对应的二进制位为 1 时累乘进最终结果,且每一步都进行取模:
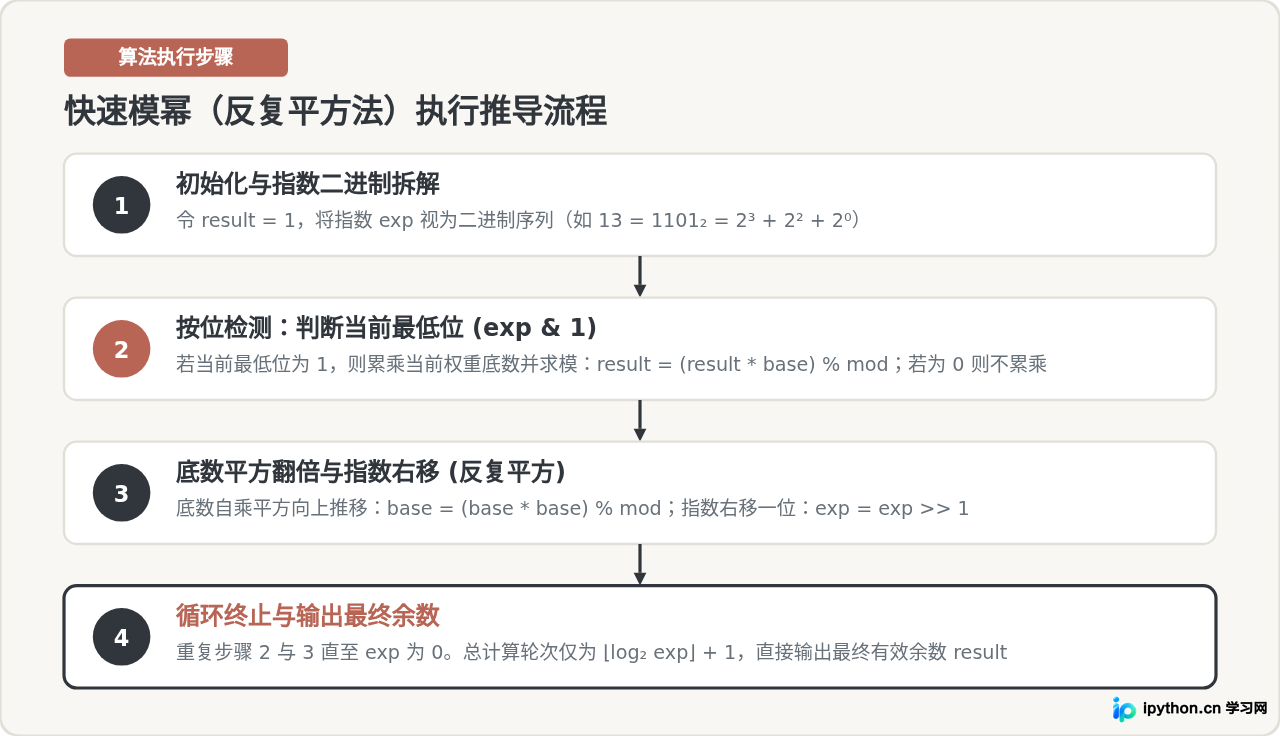
为了加深理解,我们可以使用纯 Python 代码模拟该算法的手动实现逻辑,它与 CPython 底层执行逻辑高度吻合:
# 纯 Python 模拟快速模幂算法执行过程
def manual_mod_pow(base: int, exp: int, mod: int) -> int:
    if mod == 1:
        return 0
    result = 1
    base = base % mod
    while exp > 0:
        # 如果当前二进制最低位为 1,累乘入结果并求模
        if exp & 1:
            result = (result * base) % mod
        # 底数平方向上跃升并求模
        base = (base * base) % mod
        # 指数右移一位
        exp >>= 1
    return result

# 验证模拟函数与内置 pow() 的结果
print(manual_mod_pow(3, 13, 7))  # 输出: 3
print(pow(3, 13, 7))             # 输出: 3
通过这种按位扫描与底数平方机制,一个指数高达 100 万的幂运算,仅需进行约 20 次循环即可得出结果,这就是其高效性的根本数学支撑。
四、进阶能力:负指数与模逆元计算(Python 3.8+)
在密码学算法(如 RSA 密钥解密、椭圆曲线数字签名算法 ECDSA)中,常常需要求解所谓的模逆元。即对于给定的整数 base 和模数 mod,寻找一个整数 x,满足:
(base * x) % mod == 1在数学上,这个 x 被记作 base-1 mod mod。在早期的 Python 版本中,三参数 pow() 不允许指数为负数;但从 Python 3.8 开始,官方赋予了 pow() 原生求解模逆元的能力。只要满足 base 与 mod 互质(即 gcd(base, mod) == 1),直接传入负指数即可自动计算逆元:
# Python 3.8+ 原生模逆元计算示例
base = 3
exp = -1
mod = 7

# 计算 3 关于模 7 的模逆元
inv = pow(base, exp, mod)
print(f"3 模 7 的模逆元为: {inv}")
print(f"验证逆元性质: (3 * {inv}) % 7 = {(3 * inv) % 7}")

# 示例输出:
# 3 模 7 的模逆元为: 5
# 验证逆元性质: (3 * 5) % 7 = 1
更令人惊喜的是,如果指数是其他负数(如 exp = -k),pow(base, -k, mod) 会自动先计算出模逆元 inv,再计算 invk mod mod,一步完成复合运算。
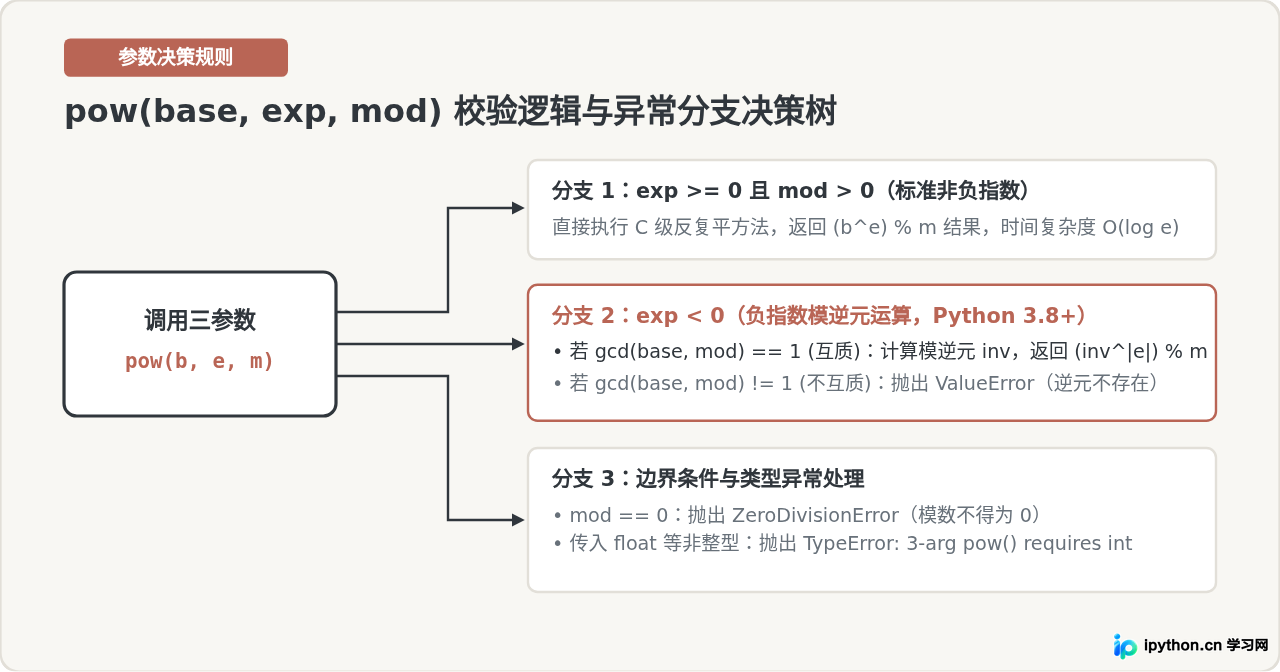
注意:当 base 与 mod 不互质时,在数学上乘法逆元根本不存在。此时 Python 会抛出明确的 ValueError 异常:
# 负指数逆元不存在的异常捕获演示
try:
    # 4 与 6 的最大公约数是 2,不互质,不存在模逆元
    pow(4, -1, 6)
except ValueError as e:
    print(f"捕获预期异常: {e}")

# 示例输出:
# 捕获预期异常: base is not invertible for the given modulus
五、避坑指南:三参数调用的边界限制与常见误区
在日常开发与工程落地中,开发者容易踩入以下几个典型误区:
1. 误写为 pow(base, exp) % mod
有的开发者虽然想起了内置函数 pow(),但错误地写成了 pow(base, exp) % mod。这种写法与 (base ** exp) % mod 在底层是完全一样的,同样会触发两参数幂运算并生成超大整数。必须确保将模数作为第三个参数直接传给 pow 函数。
2. 传递浮点数参数触发 TypeError
双参数 pow(2.5, 3) 允许浮点数,但是三参数 pow(base, exp, mod) 严格要求所有三个参数都必须是整型数值。如果其中任意一个为浮点数,Python 将立即中断并抛出 TypeError:
try:
    pow(2.0, 5, 7)
except TypeError as e:
    print(f"参数类型错误: {e}")

# 示例输出:
# 参数类型错误: pow() 3rd argument not allowed unless all arguments are integers
3. 模数为负数的特殊规则
虽然数学竞赛和密码学中模数通常是正整数,但在 Python 中模数可以是负整数。Python 的取模运算始终遵循“向下整除(Floor Division)”的原则,即结果的符号与模数的符号保持一致。例如 pow(3, 5, -7) 的输出结果为 -2(因为 5 - 7 = -2)。为确保代码逻辑具备跨语言可移植性,建议在工程中统一将模数保持为正整数。
六、技术选型与最佳实践全景总结
综合以上分析,Python 的 pow(base, exp, mod) 是一个高度成熟、开箱即用且经过深层工业级优化的算法工具。在涉及幂余数、同余定理、散列运算以及加密解密的所有业务中,均应将其作为唯一标准范式。
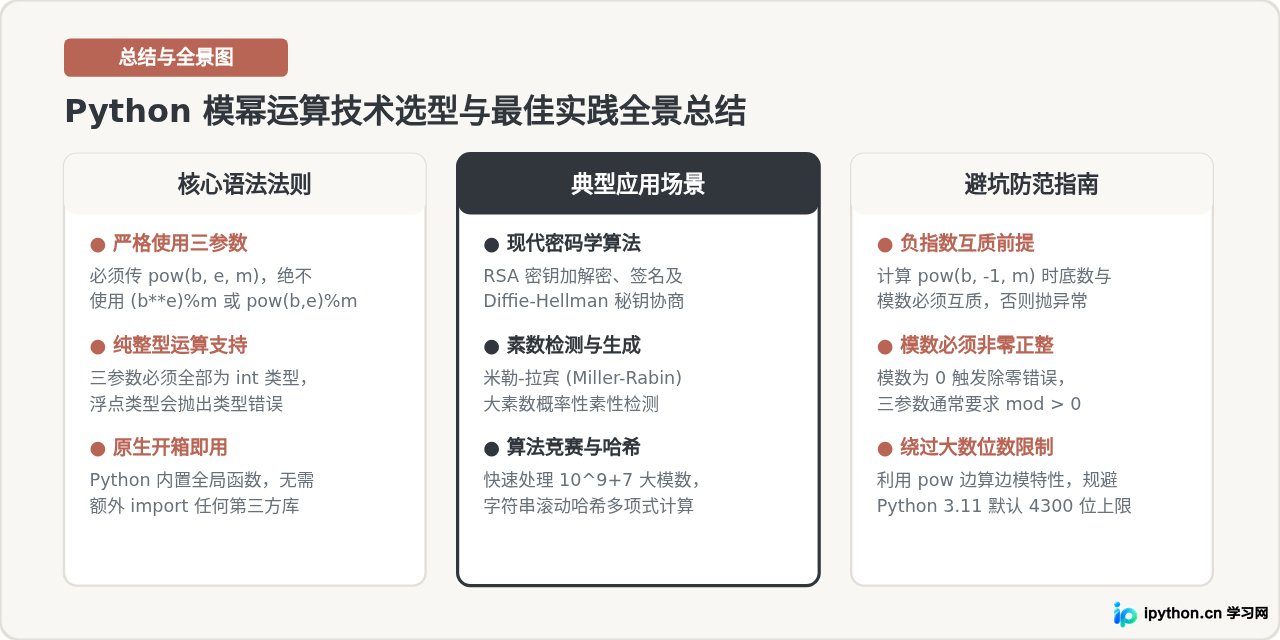
总结来说,只要记住“求模必须三参数,指数为负先判互质”这两条基本纪律,就能在 Python 项目中充分发挥硬件与语言内核的最大性能,编写出既简洁又安全高效的数值计算代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















