


Python 3.x基础语法速成:变量、循环与函数的免费图文教程

学习 Python 3.x 编程的核心关键,在于迅速掌握支撑程序运行的三大基础支柱:用于存储和表达数据的变量、用于控制代码重复执行的循环,以及用于封装和复用逻辑的函数。很多初学者在入门时容易陷入对细枝末节语法的死记硬背,反而忽略了代码在运行时的状态流转与作用域规则。本文专为希望快速建立实战编程能力的读者设计,跳过冗长的背景铺垫,直接聚焦变量、循环与函数的核心机制与语法要点,结合清晰的内存模型图解与完整代码示例,提供一套系统且实用的基础语法速成路径。
一、变量与数据对象:理解动态引用与内存机制
在 Python 3.x 中,变量的概念与很多传统编译型语言不同。Python 采用动态类型机制,变量名本身并没有固定的数据类型,它更像是一个贴在具体数据对象上的“名字标签”。当我们编写赋值语句时,Python 解释器会在内存堆区创建对应的数据对象,然后将变量名作为一个引用指针指向该对象。
理解变量的底层机制,需要重点区分不可变类型(Immutable)与可变类型(Mutable):
- 不可变数据类型:包括整数(int)、浮点数(float)、字符串(str)、元组(tuple)和布尔值(bool)。一旦创建,其在内存中的值不可改变。对不可变变量重新赋值(例如
x = x + 1),本质上是创建了一个新的整数对象,并将变量x重新指向新地址,原对象若无其他引用则等待垃圾回收。 - 可变数据类型:包括列表(list)、字典(dict)和集合(set)。这类对象支持原地修改(In-place Mutation)。例如向列表追加元素时,列表容器自身的内存地址保持不变,仅内部存储的元素引用发生增减。
在代码规范方面,Python 变量名推荐采用蛇形命名法(snake_case),即全部小写字母并通过下划线分隔;变量名必须以字母或下划线开头,不能包含连字符或空格,且严禁使用 Python 保留关键字(如 class、def、return 等)。
# 基础变量赋值与类型查看
user_name = "Alice"       # 字符串类型 str
user_age = 25             # 整数类型 int
account_balance = 1050.50 # 浮点数类型 float
is_active = True          # 布尔类型 bool

# 共享引用与内存标识对比
original_list = [1, 2, 3]
alias_list = original_list # alias_list 与 original_list 指向同一内存地址
alias_list.append(4)

print("原列表内容:", original_list) # 输出 [1, 2, 3, 4]
print("内存地址是否相同:", id(original_list) == id(alias_list)) # 输出 True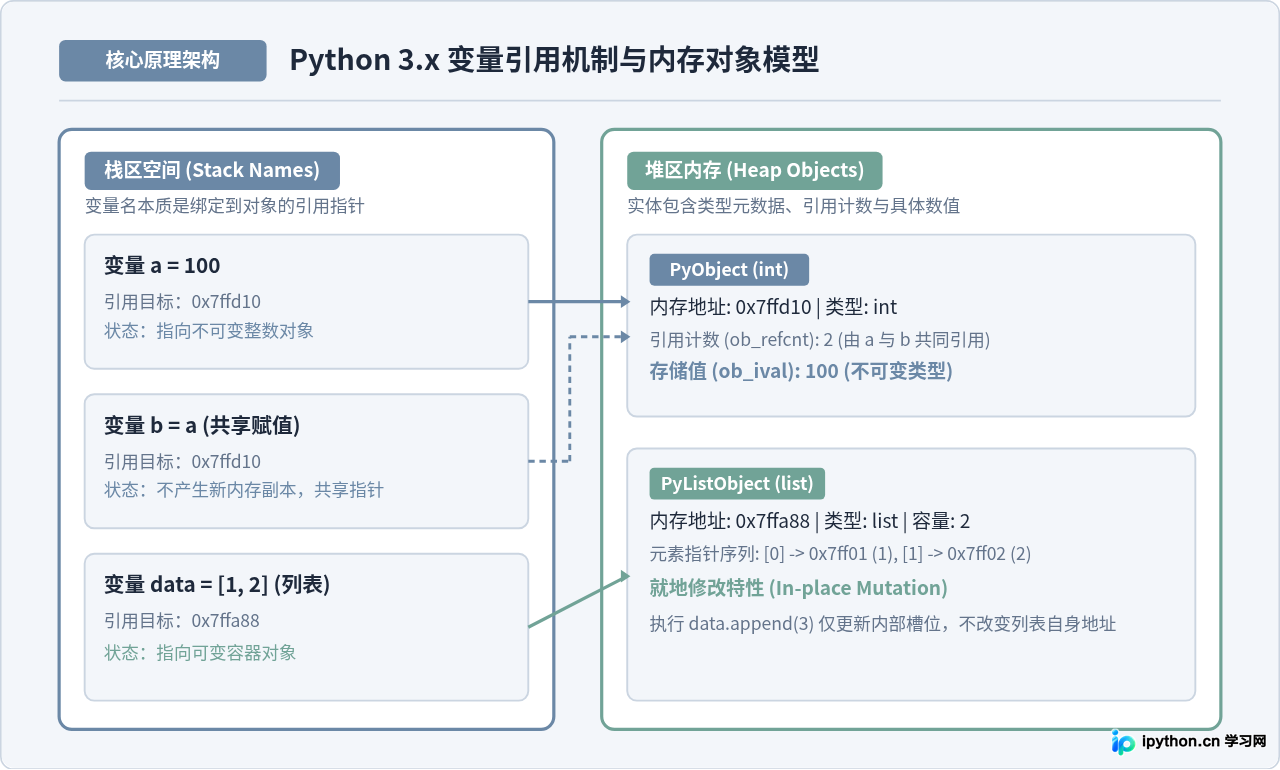
二、流程控制之循环结构:for 遍历与 while 条件迭代
循环是让计算机高效处理重复任务的核心语法。Python 3.x 提供了两种基本的循环形式:基于可迭代序列的 for 循环,以及基于布尔状态判定的 while 循环。
1. for 循环与 range 序列生成器
Python 中的 for 循环本质上是一个迭代器驱动结构。它可以直接遍历任何可迭代对象(如列表、字符串、元组或字典的键),无需手动维护下标索引。当需要执行固定次数的循环时,通常配合内置的 range() 函数:
# range(start, stop, step) 生成左闭右开区间序列
for i in range(1, 10, 2):
    print("当前奇数:", i) # 依次输出 1, 3, 5, 7, 9
2. while 循环与防止死循环要点
while 循环在指定的布尔表达式为 True 时持续执行。使用 while 循环时,必须确保循环体内存在能够改变判断条件的步进语句;如果条件始终为真且缺乏中断机制,将导致程序陷入死循环占用大量系统资源。
3. break、continue 与循环 else 语句
Python 提供了两个关键字用于在循环执行过程中改变控制流程:
continue:立即终止当前这一轮迭代,跳过循环体中剩余的代码,直接进入下一轮条件判定或迭代。break:立即彻底终止整层循环,程序直接跳转到循环体外部的第一行代码继续执行。else分支:Python 的循环结构支持配套的else子句。只有当循环正常耗尽或自然结束(即没有触发break中断)时,else块中的代码才会执行。常用于数据搜索匹配场景。
# 搜索目标数字并结合 else 判定
target = 7
numbers = [1, 3, 5, 7, 9]

for n in numbers:
    if n == target:
        print(f"找到目标数字: {n}")
        break
else:
    print("未在列表中找到目标数字")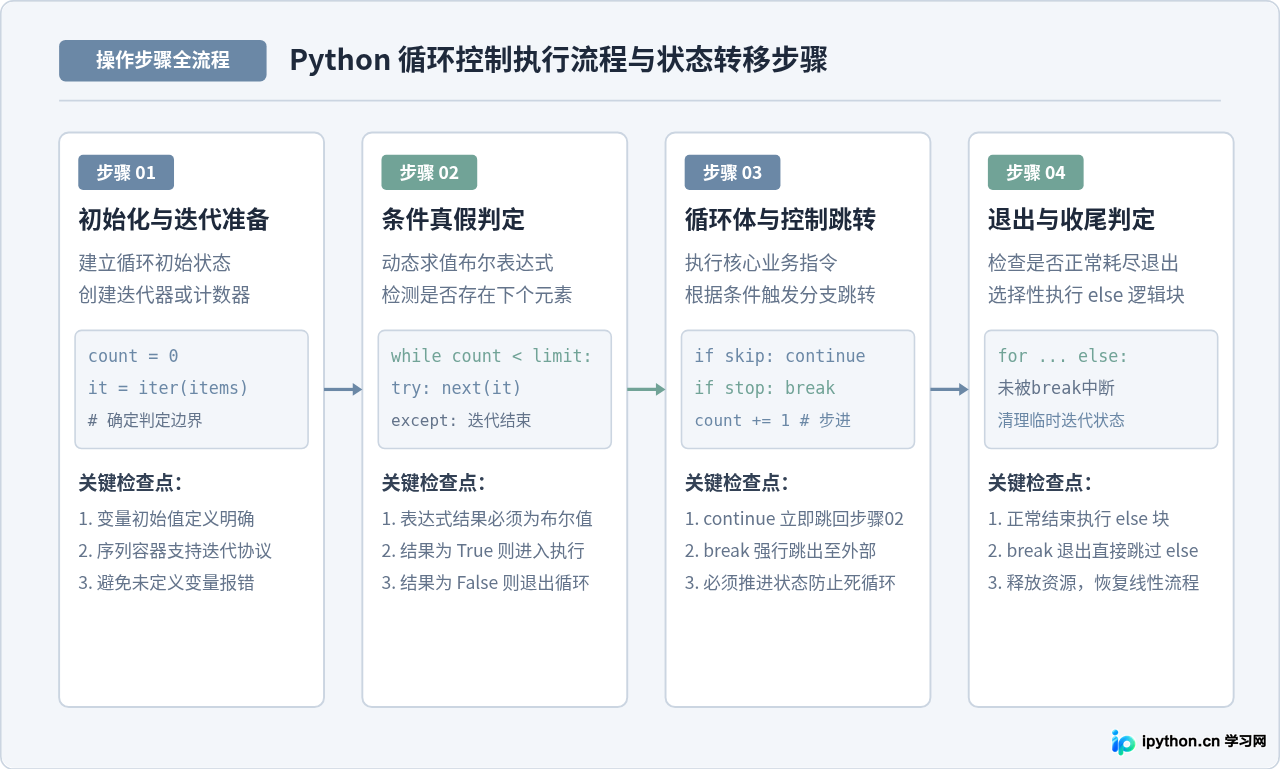
三、函数的定义与封装:组织可复用逻辑的利器
函数是组织可复用代码、降低程序复杂度并实现模块化设计的核心工具。在 Python 3.x 中,使用 def 关键字定义函数。
1. 函数签名与参数体系
Python 函数的参数支持多种灵活的定义模式:
- 位置参数(Positional Arguments):按顺序传入,调用时的实参与定义的形参一一对应。
- 默认参数(Default Arguments):在定义形参时赋予默认值,调用时可省略。注意:默认参数必须放在所有无默认值位置参数的后面。
- 可变位置参数(*args):将调用时多余的位置参数打包为一个元组(tuple)。
- 关键字参数(**kwargs):将调用时传入的具名参数打包为一个字典(dict)。
2. 返回值规范
函数通过 return 语句将运算结果返回给调用方。如果函数执行完毕未遇到 return,或者写了不带任何表达式的 return,Python 会隐式返回 None。如果需要返回多个数据,可以用逗号分隔,Python 会自动将其封装为元组返回。
3. LEGB 变量作用域规则
在函数内部访问变量时,Python 严格遵循 LEGB 顺序由内向外依次查找:
- L (Local):函数或 lambda 表达式内部的局部作用域。
- E (Enclosing):外层嵌套函数的闭包命名空间。
- G (Global):当前模块文件的顶层全局命名空间。
- B (Built-in):Python 内置命名空间(包含如
len、range等内置函数)。
如果在函数内部需要对全局变量进行修改,必须显式使用 global 关键字声明;若需修改外层嵌套函数的局部变量,则使用 nonlocal 声明。通常建议通过“参数传入、返回值传出”的方式交互数据,尽量减少对外部全局变量的直接修改。
# 函数定义、多类型参数与返回值示例
def create_user_profile(username, age, default_role="Member", *tags, **extra_info):
    """构建用户档案数据字典"""
    profile = {
        "name": username,
        "age": age,
        "role": default_role,
        "tags": list(tags),
        "extra": extra_info
    }
    return profile

# 调用示例
user = create_user_profile(
    "Bob", 28, "Admin",
    "python", "developer",
    city="Shanghai", department="Engineering"
)
print("用户信息:", user)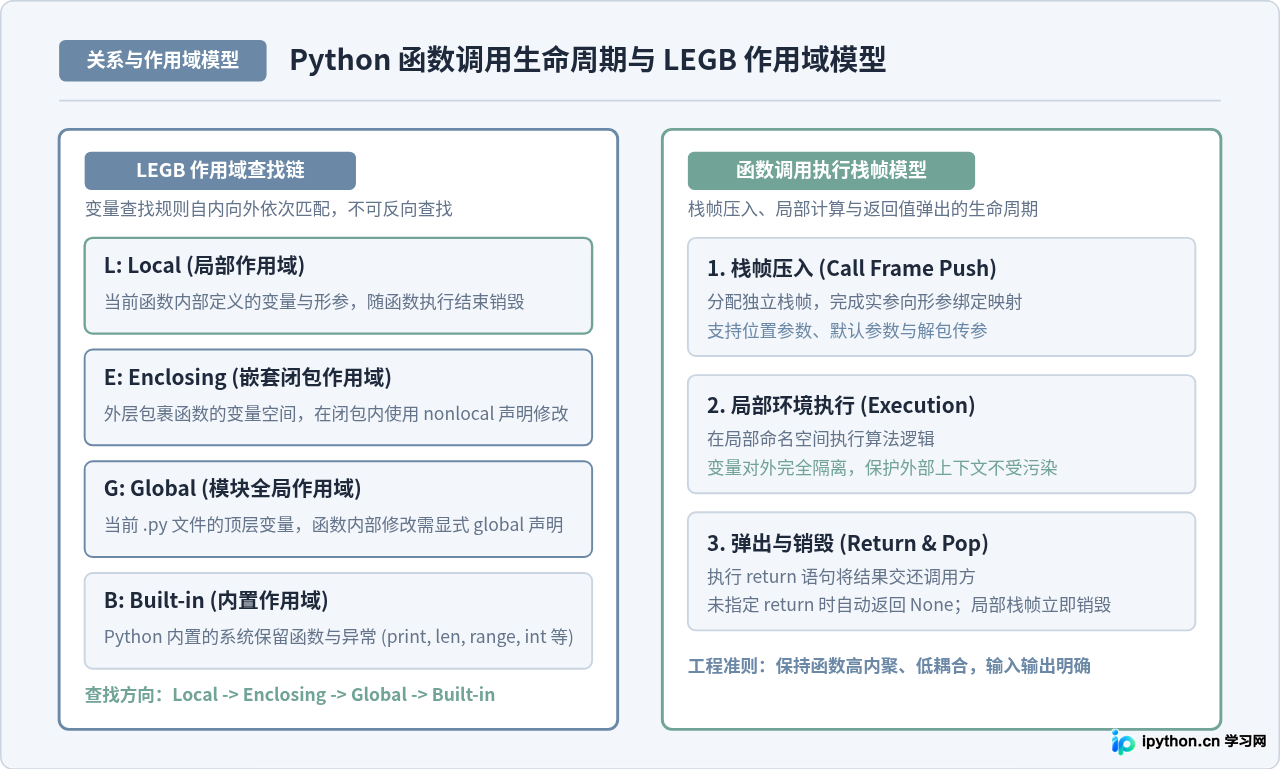
四、综合实战演练:串联变量、循环与函数构建实用脚本
掌握了变量、循环与函数后,我们将这三部分综合起来,编写一个处理业务数据的实用脚本:统计分析一组学生的成绩信息,计算平均分、评定合格状态并格式化输出报表。
# 综合实战:学生成绩综合评定与报表生成脚本

# 1. 变量定义:初始化原始数据容器
student_data = [
    {"name": "张伟", "scores": [88, 92, 85]},
    {"name": "李娜", "scores": [76, 81, 79]},
    {"name": "王强", "scores": [58, 64, 52]},
    {"name": "赵敏", "scores": [95, 98, 91]}
]

# 2. 函数定义:计算单人统计指标并返回规范结果
def calculate_grade(name, score_list):
    """计算单个学生的平均成绩并给出达标等级"""
    if not score_list:
        return {"name": name, "average": 0.0, "level": "无成绩", "passed": False}

    avg_score = sum(score_list) / len(score_list)
    level = "优秀" if avg_score >= 90 else "良好" if avg_score >= 80 else "合格" if avg_score >= 60 else "需重修"

    return {
        "name": name,
        "average": round(avg_score, 1),
        "level": level,
        "passed": avg_score >= 60
    }

# 3. 循环遍历:批量调用函数并分类统计输出
print("===== 学生学业成绩汇总表 =====")
passed_students_count = 0

for student in student_data:
    evaluation = calculate_grade(student["name"], student["scores"])

    # 状态分流判定
    if not evaluation["passed"]:
        print(f"预警提示: 学生 {evaluation['name']} 平均分为 {evaluation['average']},状态为【{evaluation['level']}】")
        continue

    passed_students_count += 1
    print(f"合格名单: 学生 {evaluation['name']} | 平均分: {evaluation['average']} | 评级: {evaluation['level']}")

print(f"统计总结: 班级总人数 {len(student_data)},达标人数 {passed_students_count}")
在这段实战代码中:
student_data运用了嵌套字典与列表的数据结构来表达业务数据;calculate_grade函数封装了统计规则,输入参数明确,返回值结构清晰;- 外层
for循环按序列逐一提取记录,配合continue语句过滤未达标对象,最终完成了数据汇总与报表输出。
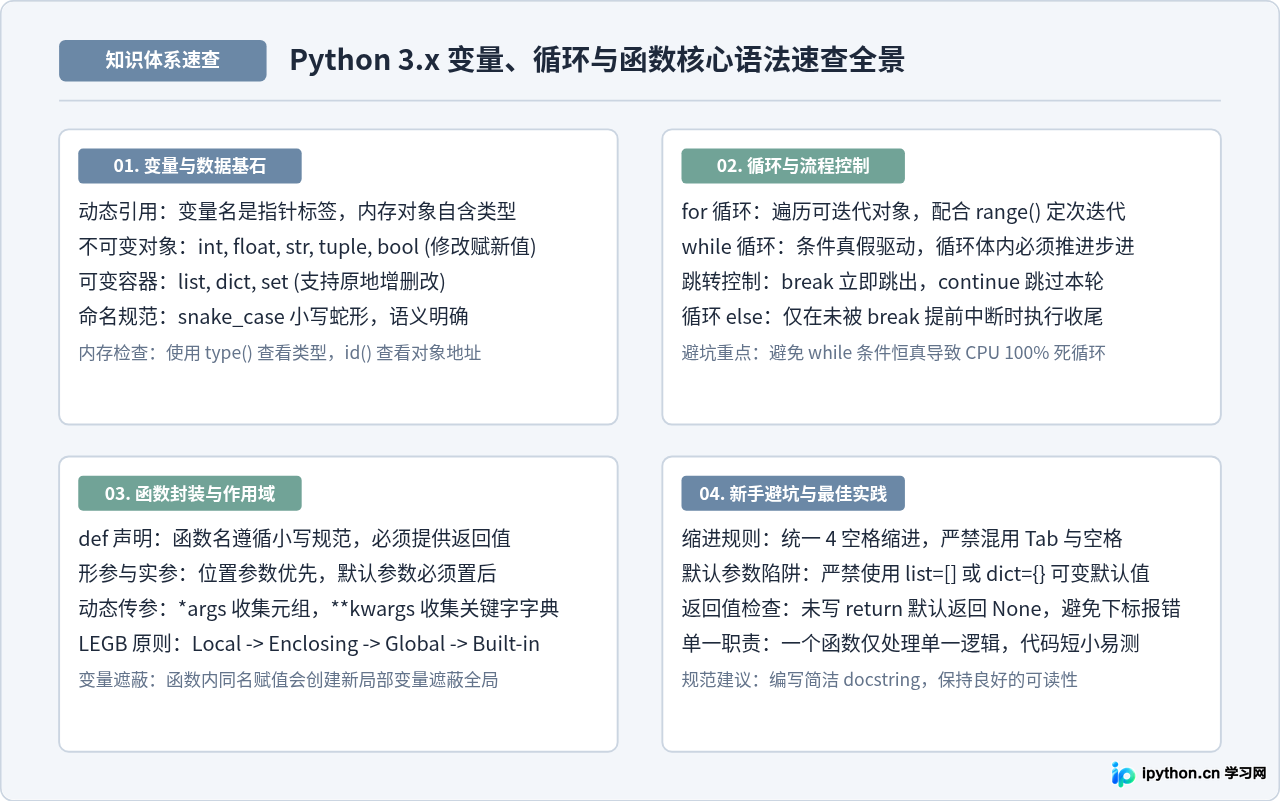
五、常见新手陷阱与核心语法速查全景
在编写 Python 代码时,有几个非常普遍但容易导致程序异常的陷阱需要格外警惕:
- 缩进错误(IndentationError):Python 依靠缩进来界定代码块层级。必须严格统一使用 4 个空格作为缩进,严禁在同一项目中混用 Tab 制表符和空格键。
- 默认参数可变对象陷阱:定义形如
def append_item(val, target_list=[])的函数时,默认列表target_list是在函数定义阶段创建的唯一对象。后续多次调用该函数,默认列表会在内存中被共享修改。正确的做法是将默认参数设为None,并在函数内部进行判断:def append_item(val, target_list=None): if target_list is None: target_list = [] target_list.append(val) return target_list - 语法冒号缺失(SyntaxError):在编写
if、for、while、def等语句头时,初学者经常遗漏行末的英文冒号:,或者误输入中文全角冒号。 - 返回值漏写导致 NoneType 异常:如果函数计算后未执行
return,调用方拿到的是None。随后若对该返回值进行下标访问或算术运算,将触发TypeError: 'NoneType' object is not subscriptable报错。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















