


Python集合不能包含列表吗?解析可哈希对象的要求

不能,Python 集合(set)无法直接包含列表(list)。当你尝试向集合添加列表,或者使用包含列表的序列初始化集合时,Python 会立即触发 TypeError: unhashable type: 'list' 异常。这并不是 Python 的设计疏漏,而是由集合底层哈希表的工作机制决定的:集合要求其容纳的全部元素必须是“可哈希对象”(Hashable),而列表作为可随时追加、删除或修改元素的内容可变容器,其哈希值无法保持固定不变。若需要在集合中保留序列信息,应当将列表转为不可变元组(tuple)或使用冻结集合(frozenset)。
一、现象验证:向集合添加列表时发生了什么?
在 Python 中,集合常用于快速去重与成员资格判断。许多开发者在处理嵌套数据时,会直觉性地尝试将列表放入集合,例如通过 set.add() 添加列表,或者在花括号字面量中直接定义包含列表的集合:
# 示例 1:尝试通过字面量创建包含列表的集合
try:
    bad_set = {[1, 2], [3, 4]}
except TypeError as err:
    print(f"创建失败: {err}")
# 示例输出: 创建失败: unhashable type: 'list'

# 示例 2:尝试使用 add() 方法追加列表
try:
    s = set()
    s.add([10, 20])
except TypeError as err:
    print(f"添加失败: {err}")
# 示例输出: 添加失败: unhashable type: 'list'
这一报错的根源在于:任何对象被存入集合时,Python 解释器内部都会首先调用该对象的 __hash__() 魔术方法来计算其散列值。列表类型 list 的类定义中显式将 __hash__ 声明为 None,因此一旦尝试对其求哈希,解释器就会直接抛出类型错误。
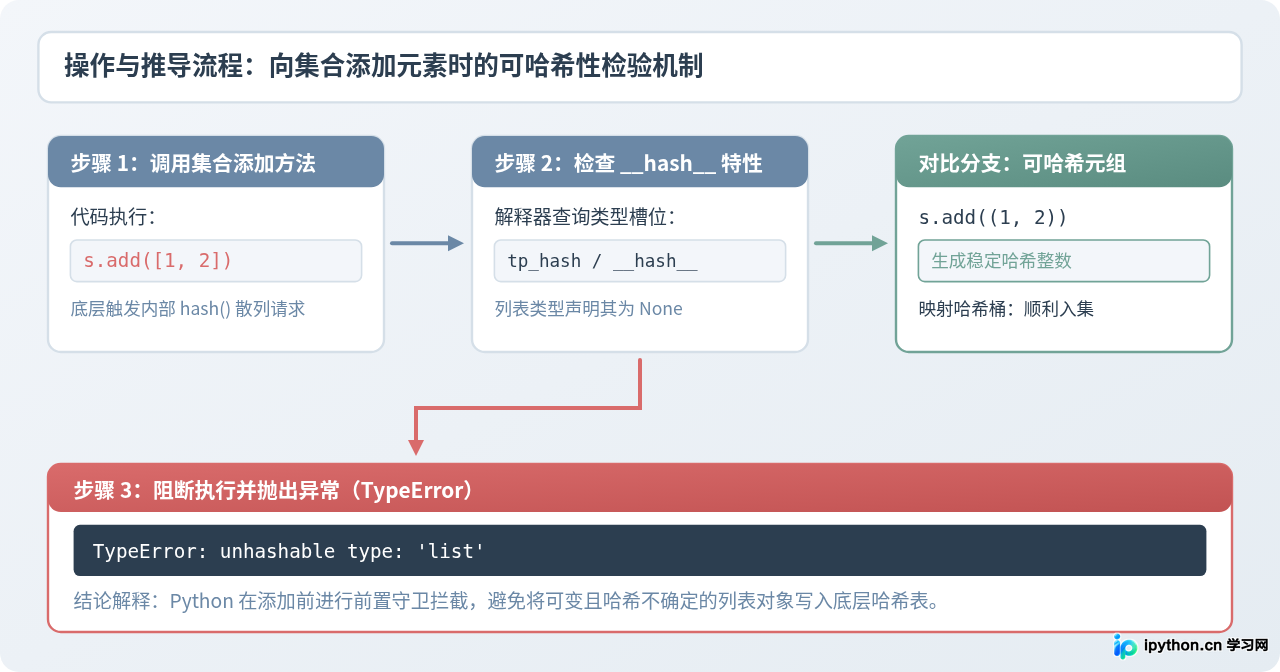
二、底层探秘:为什么集合强制要求元素可哈希?
读者自然会产生疑问:为什么集合不能像普通列表一样,逐个检查元素是否重复,而必须通过哈希值来管理?这涉及到集合的性能诉求与底层存储结构。
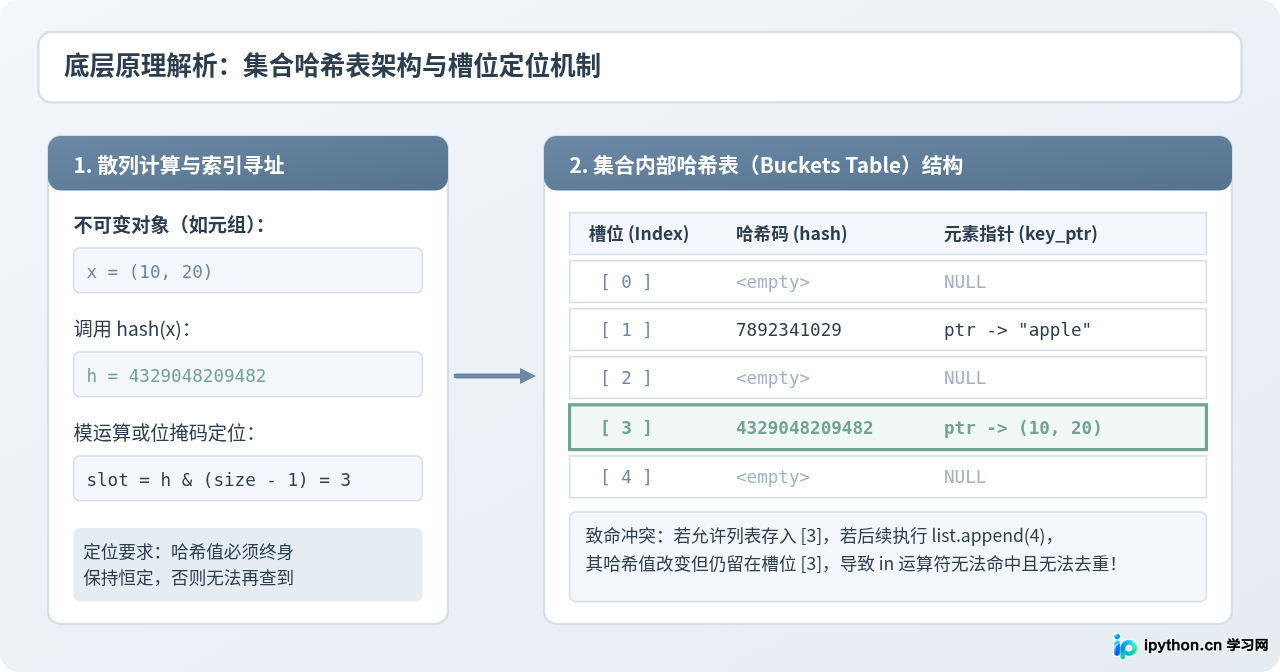
集合的核心优势在于 O(1) 平均时间复杂度的查找速度与去重能力。如果集合采用顺序扫描,判断一个元素是否存在就需要 O(n) 的时间,随着数据量增加,性能会急剧恶化。为了达到常数级访问速度,Python 集合底层基于哈希表(Hash Table)实现:
- 散列索引定位:当一个元素准备存入集合时,Python 调用
hash(item)生成一个 64 位整数,再通过位运算映射到底层哈希桶数组的特定槽位(Bucket)。 - 快速命中与碰撞处理:检索元素时,只需重新计算待查对象的哈希码并直接跳到对应槽位,仅在极少数哈希冲突时才进一步比对元素内容。
设想一下:如果允许列表进入集合,当你在集合外部修改了列表的内容(例如调用 lst.append(99)),如果列表具有哈希值且哈希值随内容变化,那么它在哈希表中的原本槽位就会失效;此时再用修改后的列表在集合中查询,计算出的新槽位将对应一个空位置,导致 lst in s 返回 False,去重逻辑彻底瓦解。
三、核心标准:什么是 Python 中的“可哈希对象”?
那么,Python 判定一个对象是否“可哈希”(Hashable)的具体标准是什么?根据 Python 官方数据模型规范,一个对象若要被称为可哈希,必须同时满足以下三个硬性契约:
- 生命周期内哈希值不变:对象在其整个存活期间,通过
__hash__()返回的整数值必须恒定不变。 - 支持相等性比较:对象必须实现
__eq__()方法,能够与其他对象进行等价比较。 - 相等对象哈希必相等:如果两个对象经过比较判定为相等(即
a == b为True),那么它们的哈希值必须完全相同(即hash(a) == hash(b))。
在 Python 内置类型中,不可变对象天然具备实现这三条契约的条件,而可变容器则从根本上破坏了契约:
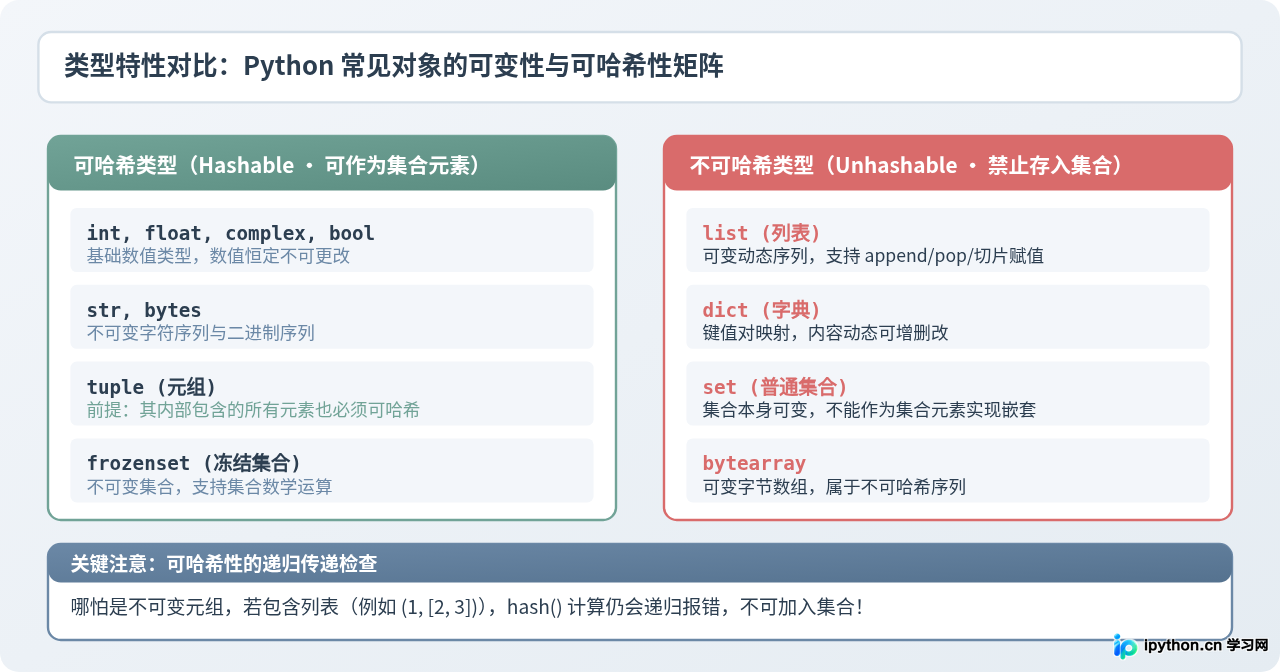
特别需要提醒的是可哈希性的递归传递检查:元组 tuple 虽然是不可变序列,但它是否可哈希取决于其容纳的所有子元素。例如:
# 纯不可变元素的元组是可哈希的
valid_tuple = (1, 2, "hello")
print(hash(valid_tuple))  # 正常输出整数哈希值

# 包含列表的元组是不可哈希的
invalid_tuple = (1, 2, [3, 4])
try:
    print(hash(invalid_tuple))
except TypeError as err:
    print(f"元组哈希失败: {err}")
# 示例输出: 元组哈希失败: unhashable type: 'list'
四、实践指南:如何向集合中正确存储序列与复合数据?
理解了不可哈希的原因后,面对实际开发中需要存储序列或复杂业务对象的场景,我们应当采用哪些标准做法?
1. 使用不可变元组替代列表
如果业务中需要将一组有序数据作为集合的独立单元进行去重或统计,最直接有效的方法是在入集前调用 tuple() 转换为元组:
# 将列表转换为元组存入集合
data_records = [[101, "北京"], [102, "上海"], [101, "北京"]]
unique_records = set()

for item in data_records:
    unique_records.add(tuple(item))

print(unique_records)
# 示例输出: {(101, '北京'), (102, '上海')}
2. 使用 frozenset 处理嵌套集合
如果需要存储的不是有序序列,而是另一组无序集合(例如图算法中的连通分量、用户标签组),可以使用 Python 提供的 frozenset(不可变冻结集合):
# 创建包含子集合的集合
group_a = frozenset([1, 2, 3])
group_b = frozenset([3, 4, 5])

meta_set = {group_a, group_b}
print(frozenset([1, 2, 3]) in meta_set)
# 示例输出: True
3. 注意 set(my_list) 与 set.add(my_list) 的区别
很多初学者会混淆以下两种操作的含义:
s = set(my_list):这是将列表作为可迭代对象传入,集合会遍历取出列表中的每一个元素逐一加入集合。只要列表里的每个元素是可哈希的,就能成功去重。s.add(my_list):这是试图把列表整体作为一个独立元素塞入集合,必然触发TypeError。
4. 自定义类的可哈希性规范
在面向对象开发中,自定义类默认继承自 object,默认使用对象的内存地址计算哈希,因此默认是可哈希的。但是,一旦你在类中重写了 __eq__() 方法,Python 就会为了安全起见,自动将该类的 __hash__ 设为 None。
如果你希望该自定义类的实例能够作为集合元素,最佳实践是使用不可变数据类 @dataclass(frozen=True),或者显式定义基于不可变属性的 __hash__():
from dataclasses import dataclass

@dataclass(frozen=True)
class Coordinate:
    x: int
    y: int

# 冻结数据类默认自动生成不可变 __hash__ 和 __eq__
points_set = {Coordinate(1, 2), Coordinate(3, 4)}
points_set.add(Coordinate(1, 2))  # 自动去重
print(len(points_set))
# 示例输出: 2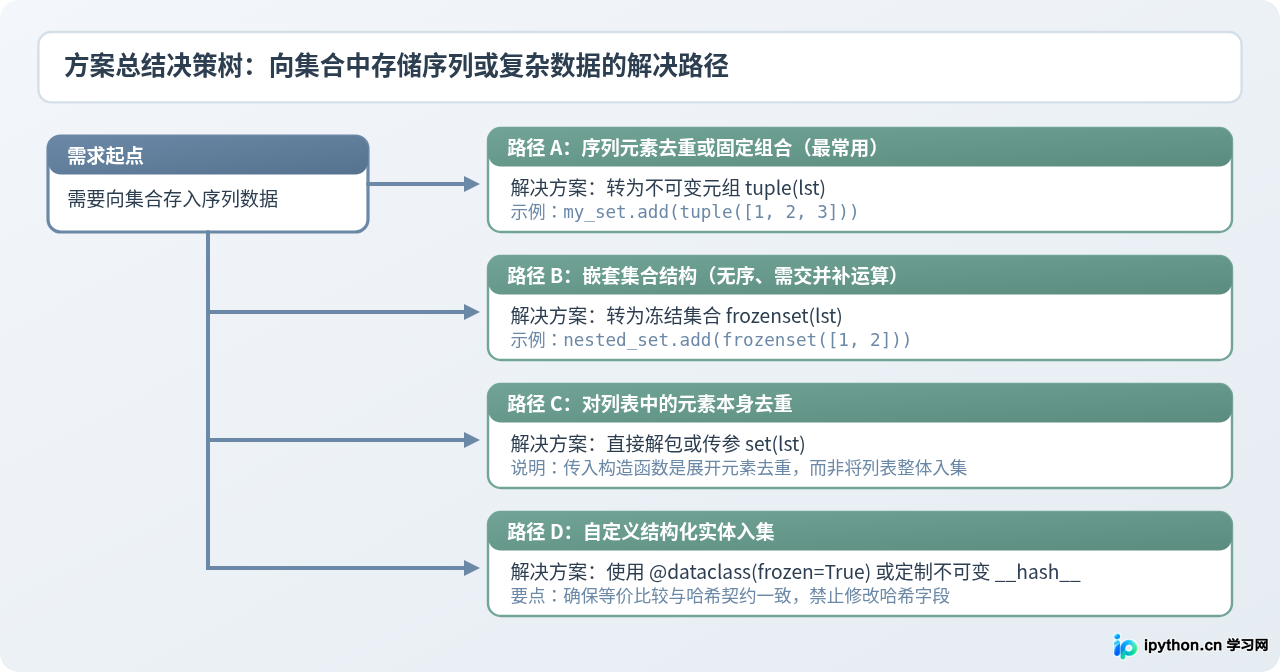
五、总结与避坑要点
回顾本文的核心结论,读者在日常 Python 编码中只需把握以下几点原则:
- 集合不能包含列表:列表是可变序列,其
__hash__为None,无法在哈希表中建立稳定的槽位映射。 - 字典键规则完全一致:字典的键(dict key)与集合的元素遵循同一套可哈希法则,因此列表同样无法充当字典的键。
- 转换优先:处理成组数据入集时,有序数据转
tuple,无序数据转frozenset。 - 警惕嵌套破坏:元组内若嵌套了列表或字典,该元组将丧失可哈希性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















