


Excel列顺序变化时Python怎么稳定获取指定列名数据

在日常数据清洗与业务自动化脚本运行中,上游导出的 Excel 表格经常发生字段顺序变动:比如系统模板升级在前面插入了新字段、不同业务部门人工调整了排序列、或者偶发性删除了辅助列。若 Python 脚本依赖固定列号或物理位置(如索引第 2 列或 iloc 偏移量),程序就会提取错误字段甚至崩溃。解决这一问题的核心逻辑非常明确:彻底放弃基于“物理列顺序”的索引方式,全面转向基于“表头列名”的动态锚定机制。无论目标列移动到哪一列,只需以列名为语义标识进行查询与映射,即可实现不受列序影响的稳定提取。
一、物理位置索引的脆弱性与列名锚定原理
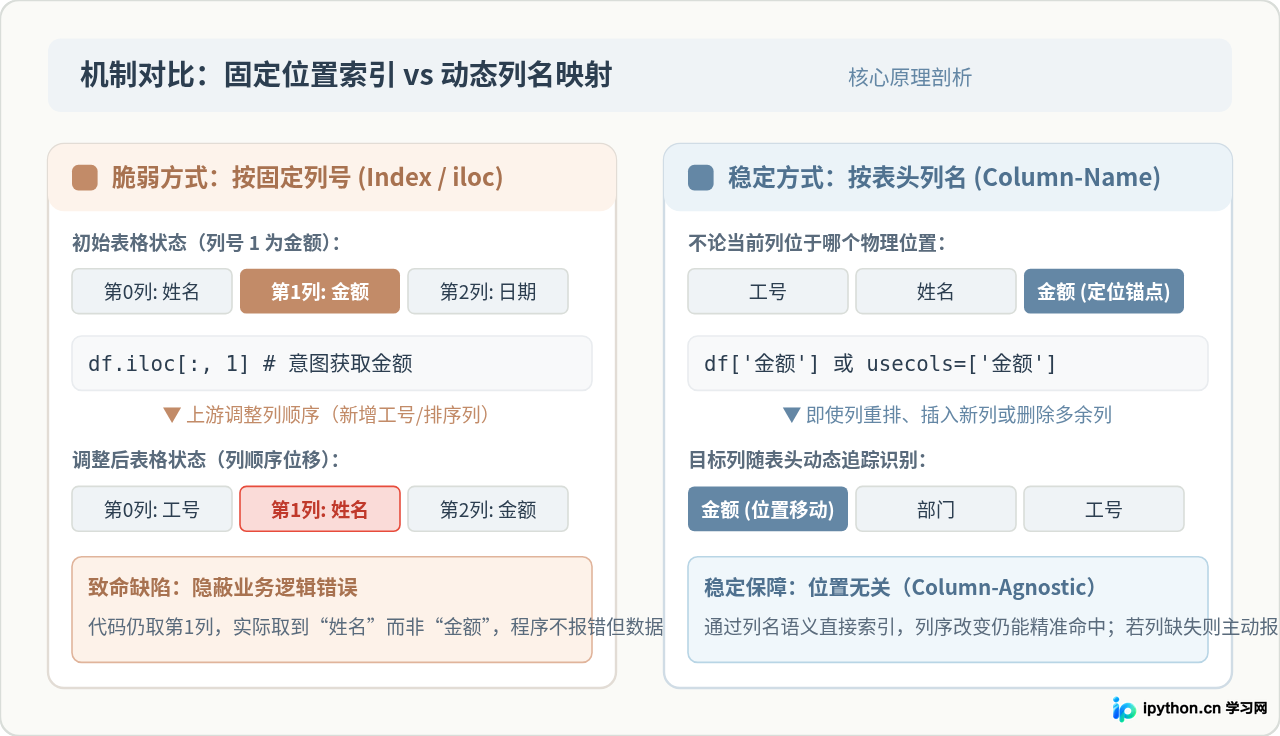
在初学数据处理时,许多人习惯按列索引切片读取数据,例如直接使用 df.iloc[:, 1] 或者在 openpyxl 中读取单元格 row[1].value。这种写法对表格结构的假设非常苛刻,一旦表格发生微调,就会产生致命隐患。
物理列号与列语义之间本就没有必然联系。当表格第一列前新增了“工号”列时,原本位于第 1 列的“金额”数据就会被顺移到第 2 列。此时继续按列号 1 读取,程序不仅不会抛出语法错误,反而会默默把“工号”当作“金额”传入后续计算流程,导致生成完全失真的财务或业务报表。相比之下,以表头列名为锚点进行数据绑定具有天然的“位置无关性”(Column-Agnostic)。只要第一行包含明确的列名,Python 就能在读取时动态扫描并建立“字段名到物理位置”的映射关系,精准命中目标。
二、使用 pandas 稳定获取指定列的实现方案
在 Python 数据分析生态中,pandas 是处理结构化表格事实上的标准库。pandas 默认将 Excel 第一行解析为 DataFrame 的列索引(Column Index),并原生支持通过列名标签进行定位。主要有两种高效稳定的写法:
1. 方式一:加载后按列名列表过滤(灵活多变)
首先通过 pd.read_excel() 将工作表读入内存,随后传入包含目标字段名称的字符串列表。这种方式适合还需要在后续流程中动态调整所需字段的场景:
import pandas as pd

def extract_columns_by_name(excel_path):
    # 默认将第一行作为表头(header=0)加载
    df = pd.read_excel(excel_path)

    # 明确定义当前业务真正需要的字段集合
    target_columns = ['订单号', '金额', '交易日期']

    # 使用列名列表进行切片,无论目标列在表格中的排列顺序如何
    result_df = df[target_columns]
    return result_df
2. 方式二:在读取阶段通过 usecols 参数过滤(性能与内存优先)
若 Excel 文件体积庞大、字段上百个,而实际业务只需要提取其中的三到四个字段,可以在调用 pd.read_excel() 时直接传递 usecols 参数:
import pandas as pd

# 仅从磁盘流式读取指定列名,跳过无关数据,极大节省内存
target_cols = ['订单号', '金额', '交易日期']
df = pd.read_excel('sales_data.xlsx', usecols=target_cols)
pandas 底层在解析文件时,会先读取首行表头,将 usecols 中的列名与实际表头做交集匹配,只把匹配成功的列加载入内存。即使表格从“订单号、金额、日期”改成了“日期、客户、金额、备注、订单号”,usecols 依然能准确锁定这三列。
三、生产级四步标准处理流程与防御性设计
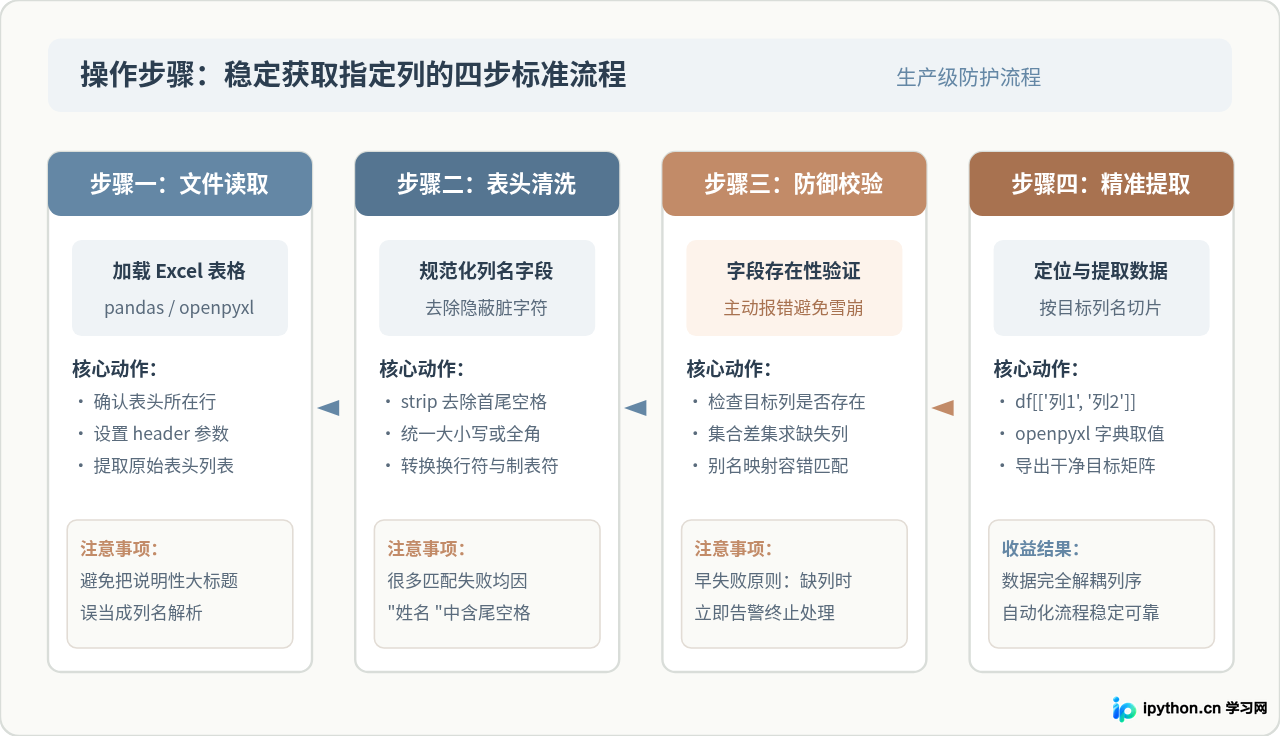
仅会写 df[['列名']] 还不足以应对生产环境中的复杂状况。在真实业务中,最常出现的陷阱并不是代码逻辑错误,而是“肉眼不可见的脏表头”:例如 Excel 中单元格输入的是 "金额 "(尾部带有空格),或者跨系统导出的表头混杂了换行符。如果不做防御,直接查找 "金额" 就会抛出 KeyError。
为了构建工业级的稳健程序,推荐遵循以下标准的四步处理流程:
下面是一份完整的生产级封装函数,完整展示了表头清洗与存在性校验:
import pandas as pd

def robust_load_columns(excel_path, required_columns):
    """
    稳健提取 Excel 指定列数据:
    1. 自动清洗表头空格
    2. 严格校验必需字段存在性
    3. 返回仅包含目标列且顺序可控的 DataFrame
    """
    df = pd.read_excel(excel_path)

    # 步骤二:清洗表头,去除首尾空白字符,统一转为字符串格式
    df.columns = [str(col).strip() for col in df.columns]

    # 步骤三:防御校验,利用 Python 集合计算缺失列
    current_cols = set(df.columns)
    needed_cols = set(required_columns)
    missing_cols = needed_cols - current_cols

    if missing_cols:
        raise KeyError(f"表格格式不合规,缺少必需列: {missing_cols},当前拥有列: {list(df.columns)}")

    # 步骤四:按要求的字段顺序提取切片
    return df[required_columns]

# 示例调用
if __name__ == "__main__":
    targets = ['订单号', '金额', '交易日期']
    # 即使 sales.xlsx 内部顺序颠倒,也能稳定返回对应数据
    clean_data = robust_load_columns("sales.xlsx", targets)
    print("提取成功,数据前3行预览:")
    print(clean_data.head(3))
防御提示:在步骤三中采用“早失败(Fail-Fast)”原则。如果表格缺失核心字段,立即抛出明确指出缺失具体列名的异常,而不是使用默认空值填充继续向下传递,这样能有效阻断脏数据污染下游数据库。
四、轻量级场景:基于 openpyxl 构建动态表头映射字典
在某些受限环境(如精简容器镜像、不允许安装大体积第三方库)或需要保留原表格样式、公式、多工作表逐行流式处理的场景下,可能不便引入 pandas。此时可以使用纯 Python 编写的 openpyxl 库。
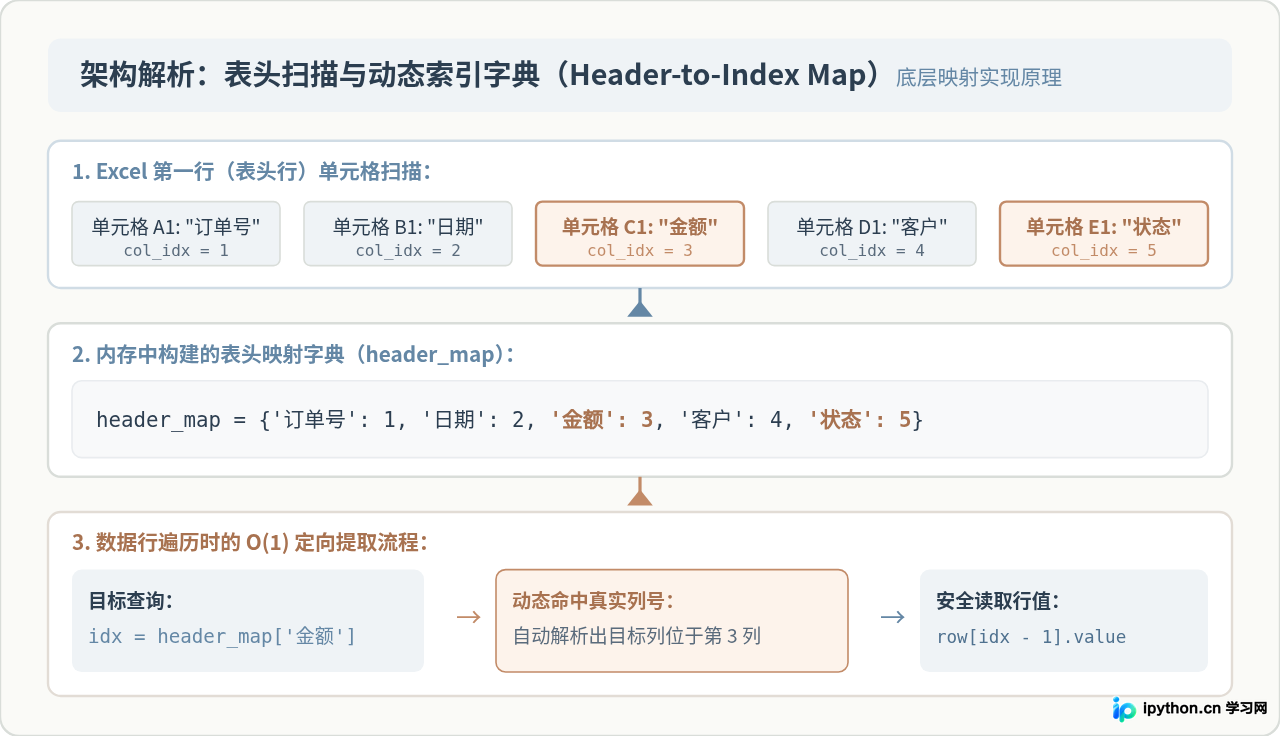
在 openpyxl 中,行的单元格是一个列表,通过索引访问(例如 row[0]、row[1])。要在列顺序变化时依然按列名取值,核心技术是“构建 Header-to-Index 动态字典”:先扫描第 1 行(表头行),建立 {列名: 列索引} 的映射字典;遍历后续数据行时,根据目标列名从字典中查出对应的物理列号。
以下是使用 openpyxl 结合动态字典提取数据的完整实现代码:
from openpyxl import load_workbook

def extract_with_openpyxl(excel_file, target_columns):
    # 只读模式加载工作簿,提高读取速度并减少内存占用
    wb = load_workbook(filename=excel_file, read_only=True)
    sheet = wb.active

    rows_iter = sheet.iter_rows(values_only=True)
    try:
        header_row = next(rows_iter)
    except StopIteration:
        return []

    # 构建表头映射字典:{清洗后的列名: 0基物理列号}
    header_map = {}
    for col_idx, cell_value in enumerate(header_row):
        if cell_value is not None:
            clean_name = str(cell_value).strip()
            header_map[clean_name] = col_idx

    # 防御检查:确认目标列均存在
    for col in target_columns:
        if col not in header_map:
            raise KeyError(f"表格缺少指定列名: '{col}',当前拥有列: {list(header_map.keys())}")

    # 提取目标列的物理索引列表
    target_indices = [header_map[col] for col in target_columns]

    extracted_records = []
    for row in rows_iter:
        # 跳过整行均为空的无效行
        if not any(row):
            continue
        record = {col: row[idx] for col, idx in zip(target_columns, target_indices)}
        extracted_records.append(record)

    wb.close()
    return extracted_records
五、复杂多变场景的容错与适配策略
在跨系统、跨部门的真实协作中,除了列顺序变动,往往还会伴随以下几种复杂的非标准情形:
1. 标题行不位于第一行(包含合并大标题)
很多手工报表的第一行是居中的“2026年度销售统计总表”,第二行才是真正的字段名。如果默认按第一行加载,表头会被识别为 Unnamed: 0。此时需要显式指定表头行:
# pandas 中指定以第 2 行(索引为 1)作为实际表头
df = pd.read_excel('sales_report.xlsx', header=1)
2. 列名存在别名或微调(如“客户名称”与“客户姓名”)
上游不同系统导出的字段称谓经常存在细微差异。为避免维护多套代码,可以使用“别名映射表(Alias Mapping)”统一清洗:
# 别名映射字典
COLUMN_ALIASES = {
    '客户姓名': '客户名称',
    '客户': '客户名称',
    '成交金额': '金额',
    '总价': '金额'
}

# 读取后统一规范化更名
df.rename(columns=COLUMN_ALIASES, inplace=True)
3. 表格中存在同名列
若 Excel 中偶然存在两个相同的列名(如两个“备注”),pandas 会自动给重名列添加后缀(如 备注.1)。在提取前应检查 df.columns.duplicated(),明确按业务定位保留第一个或最后一个,避免取值歧义。
六、方案选型矩阵与容错防护总结
针对 Excel 列顺序变化的痛点,pandas 与 openpyxl 提供了不同层次的解决方案。下表对比了这两种主流方案的核心特性与适用场景:
| 对比维度 | pandas 方案 | openpyxl 字典映射方案 |
|---|---|---|
| 语法复杂度 | 极简,一行代码即可切片 | 中等,需自行扫描表头并构建字典 |
| 外部依赖 | 依赖 pandas 及底层引擎(openpyxl/calamine) | 仅依赖 openpyxl,环境更轻量 |
| 大数据量性能 | 非常高(C/C++底层加速) | 一般,适合中小型表格或流式只读 |
| 格式与样式保留 | 仅提取纯数据,丢失单元格样式与公式 | 原生支持单元格格式、公式与多属性操作 |
| 列序变化自适应 | 原生支持,结合 usecols 效率极高 | 通过字典 O(1) 映射实现位置无关性 |
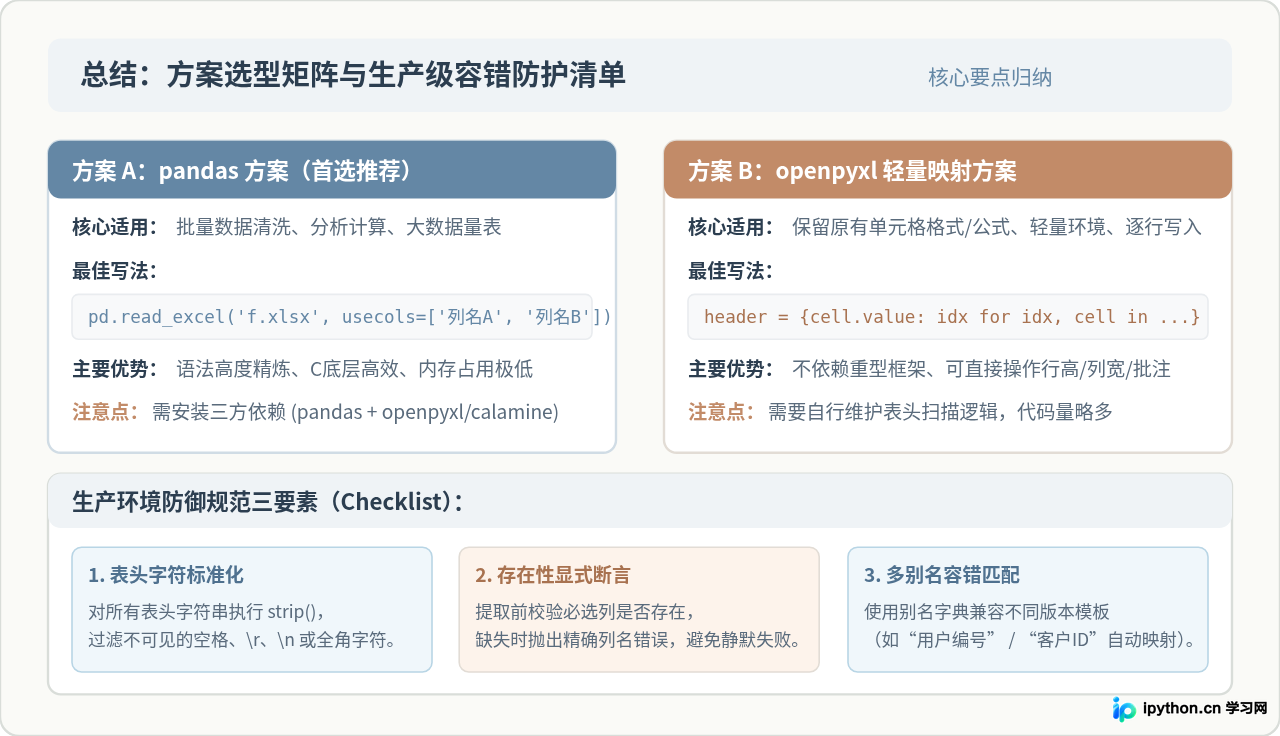
综上所述,应对 Excel 列顺序变动的本质在于“解耦物理位置,建立语义映射”。无论采用 pandas 还是 openpyxl,只要在入口处规范执行表头去除多余空格、显式校验必需字段,并在提取时使用列名进行精准索引,就能彻底摆脱对列号位置的脆弱依赖,确保自动化流程长期稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















