


Python字符串切片步长为0会报什么错?

在 Python 中对字符串(以及列表、元组等序列类型)执行切片操作时,如果将步长(step)显式或隐式设置为 0,解释器会立即抛出 ValueError: slice step cannot be zero。这个错误明确指出:切片的步长参数不能为零。切片需要借助非零的步长来确定游标遍历的方向与跨度,步长为零会导致切片游标原地停滞、无法推进,因此 CPython 底层在执行切片前对此进行了硬性校验并主动拦截。本文将详细解析该报错的具体表现、底层原理、典型触发场景,并给出实用的排查与代码防御方案。
一、报错具体表现与代码示例
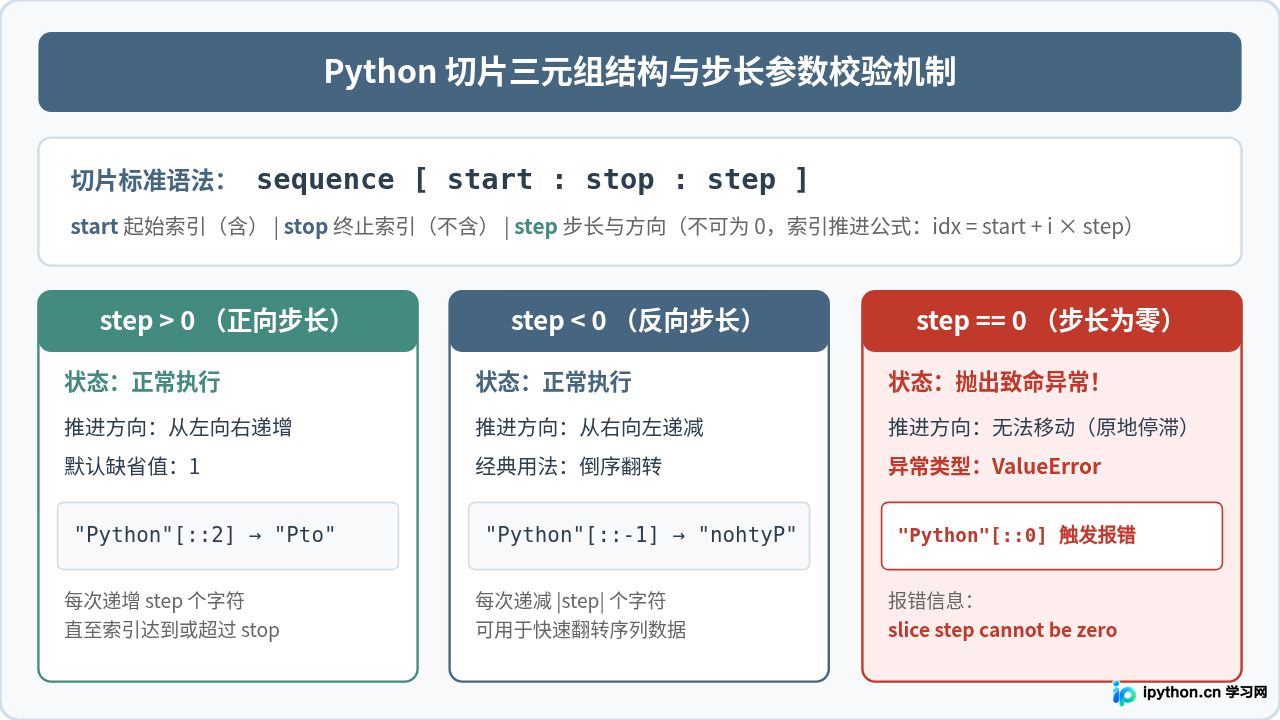
在 Python 中,切片是通过方括号三元组语法 [start:stop:step] 来完成的。当第三个参数传入 0 时,无论第一个参数和第二个参数取何值,程序均会立刻中断并输出异常堆栈。
以下是触发该报错的典型交互式示例:
# 示例:直接设置步长为 0
text = "Python"
result = text[::0]
执行上述代码后,控制台会输出如下标准 Traceback 报错信息(示例输出):
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
ValueError: slice step cannot be zero
从报错信息中可以提取出两个关键信息:
- 异常类型:
ValueError。在 Python 异常体系中,当传入函数的参数类型正确(0 确实是合法的整数类型),但具体取值不符合操作规则时,便会抛出值错误(ValueError)。 - 错误提示:
slice step cannot be zero。英文含义为“切片步长不能为零”,直截了当地说明了问题核心。不仅字符串切片如此,列表(list[::0])、元组(tuple[::0])以及切片对象计算(slice.indices())均遵循完全相同的报错规则。
二、深入底层:为什么 Python 严格禁止步长为 0?
要理解 Python 为何对步长为 0 采取“零容忍”的态度,需要从切片的数学模型与底层 CPython 解释器的实现逻辑两个维度来看。
1. 数学模型与迭代循环逻辑
切片在本质上是按等差数列规则对序列索引进行抽样的过程。如果用公式来表示第 i 次抽样命中的索引位置:
index_i = start + (i * step)每次完成一次元素提取,游标通过 index += step 向下推进:
- 当
step > 0时,索引单调递增,游标逐步逼近stop上界,循环有限且方向明确。 - 当
step < 0时,索引单调递减,游标逐步逼近stop下界,循环有限且反向明确。 - 当
step == 0时,i * step始终为 0,index_i永远恒等于start。游标原地打转,既无法前进也无法后退,无法形成合法的遍历区间。如果不做拦截,遍历逻辑要么陷入无限死循环,要么产生完全无实际价值的歧义。
2. CPython 底层源码实现拦截
在 CPython 的核心源码文件 Objects/sliceobject.c 中,切片索引计算由 PySlice_GetIndicesEx 函数负责。在该函数执行具体的边界换算前,设置了明确的前置校验:
/* CPython sliceobject.c 核心逻辑简化对照 */
if (step == 0) {
    PyErr_SetString(PyExc_ValueError, "slice step cannot be zero");
    return -1;
}
一旦检测到 step == 0,解释器根本不会去计算 start 或 stop 的有效范围,而是立即抛出 ValueError 并终止执行。这一硬性约束确保了切片操作在底层层面的安全与确定性。
三、常见触发场景与错误排查
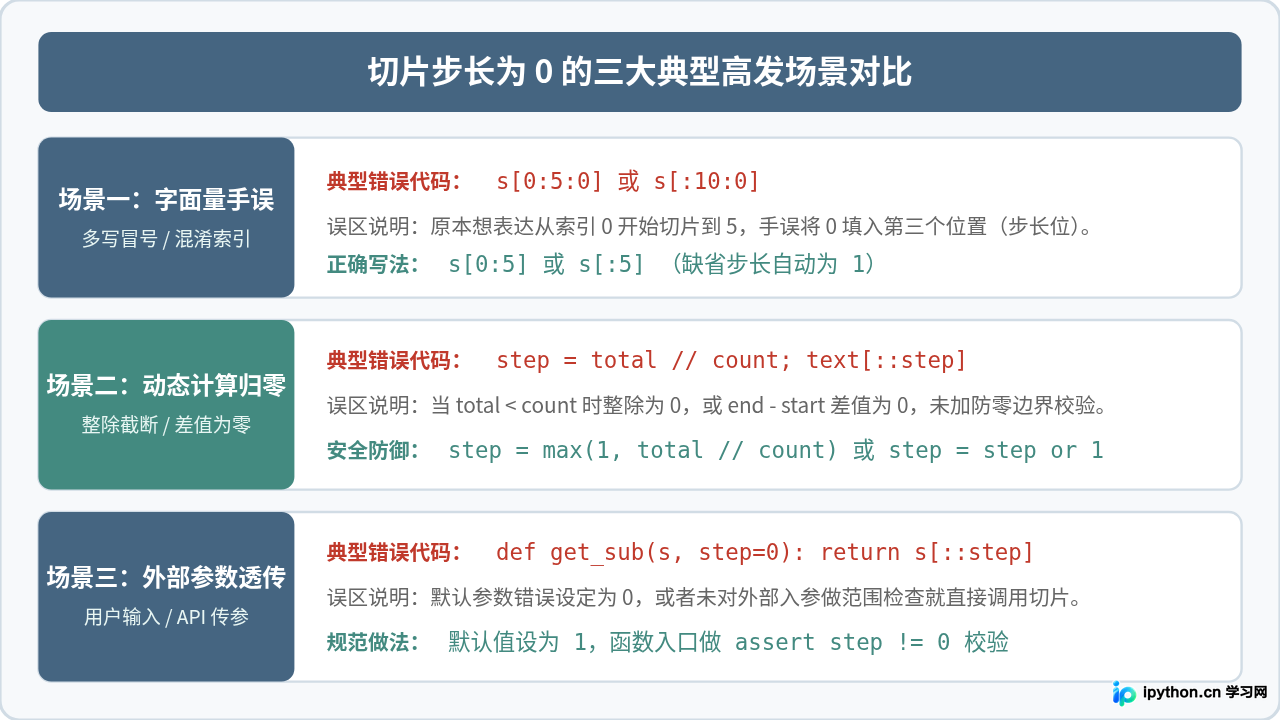
在实际编码过程中,极少有开发者会显式编写 text[::0] 这样明显的硬编码。该错误绝大多数发生在以下三种容易被忽视的场景中:
1. 场景一:语法混淆与键入笔误
初学者容易将“从索引 0 开始”的意图误放到了步长位置。例如,本意是截取前 5 个字符 text[0:5],却不慎写成 text[0:5:0] 或 text[:5:0]。在 Python 切片中,第三个位置专属于步长,省略时默认即为 1,绝不可填入 0。
2. 场景二:动态变量计算归零(高隐蔽性 Bug)
这是生产环境中最常见的事故类型。步长来自数学表达式的计算,在特定边界数据下计算结果变成了 0:
# 隐蔽错误示例:整除计算导致步长为 0
sample_rate = total_items // target_count
# 当 total_items < target_count 时,整除结果为 0
sampled_text = raw_text[::sample_rate]  # 崩溃:ValueError
3. 场景三:外部入参透传未过滤
当封装通用工具函数时,如果直接接收前端表单、API 参数或命令行输入并透传给切片,且未预先做参数校验,一旦调用方传递了 step=0,底层就会发生非预期崩溃。
四、定位与修复标准四步流程
当在排查或运维中遇到 ValueError: slice step cannot be zero 报错时,可遵循以下四个步骤快速定位并完成根治修复:
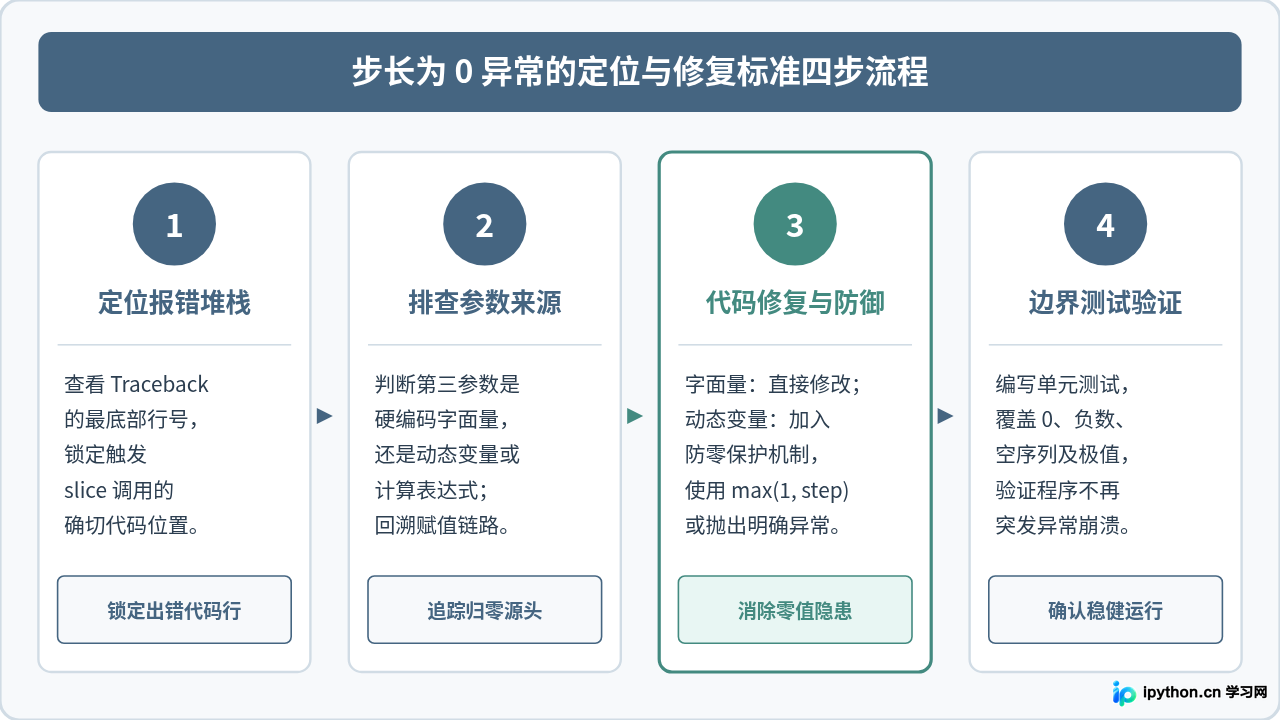
- 第一步:精准定位出错文件与代码行。观察终端输出的调用栈最下方(最后一层),找到对应的
File "...", line X,定位包含切片语法的具体行。 - 第二步:审查切片表达式与参数链路。检查该行代码中的切片第三个参数是字面量还是变量。如果是变量(例如
s[::step]),向前排查step是在哪里被定义或计算出来的。 - 第三步:实施防御性代码修复。如果是静态误写,直接修改为所需正数或删去步长;如果是动态计算变量,加入防零兜底逻辑(如使用
max(1, step))。 - 第四步:编写边界用例进行回归验证。针对数据为空、计算值为 0、负数等边界条件运行自动化测试,确认程序即使面临极限数据也不会再次抛出
ValueError。
五、代码防御与安全切片实践
在面对可能存在零值风险的动态步长切片时,推荐采用以下几种兼具稳健性与可读性的编码范式:
1. 使用 max() 或短路逻辑提供保底默认值
在允许默认步长的业务场景下,当计算结果可能为 0 时,可通过 max(1, step) 强制限制步长下限,或使用 step or 1 进行快速兜底:
# 方案一:使用 max() 设置最小安全步长
raw_step = total // count
safe_step = max(1, raw_step)
result = data[::safe_step]

# 方案二:利用短路逻辑兜底(当 step 为 0 时自动回退为 1)
safe_step = step or 1
result = data[::safe_step]
2. 入口参数显式校验与抛出业务异常
如果切片步长代表严格的业务含义(例如采样间隔、分页跨度),不能随意替调用方将 0 篡改为 1,则应当在函数入口主动防御并给出清晰的业务提示:
def sample_string(text: str, interval: int) -> str:
    """按固定步长对字符串进行采样。"""
    if interval == 0:
        raise ValueError("采样间隔 interval 不能为 0,请提供非零正整数或负整数。")
    return text[::interval]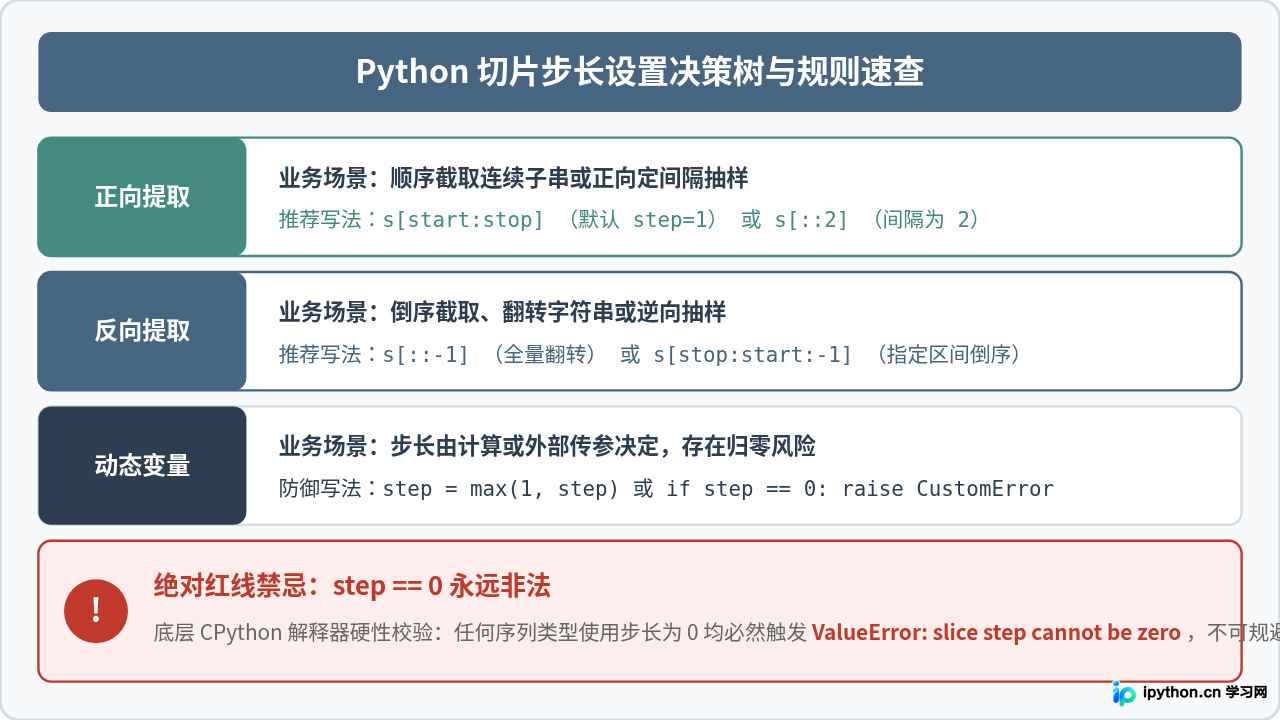
六、核心要点总结
- 明确报错原因:步长为 0 会抛出
ValueError: slice step cannot be zero,表明切片游标步长不能为零。 - 理解底层约束:切片依赖等差递增算法
start + i * step,步长为 0 无法形成有效推进方向,CPython 底层硬性拦截。 - 牢记默认机制:省略步长参数时,默认步长是 1 而不是 0;反向翻转使用负步长
-1。 - 做好动态防护:遇到动态计算或外部输入的步长,切记在执行切片前加入
max(1, step)、step or 1或条件断言进行防零保护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















