


Python字符串切片索引越界为什么不报错?

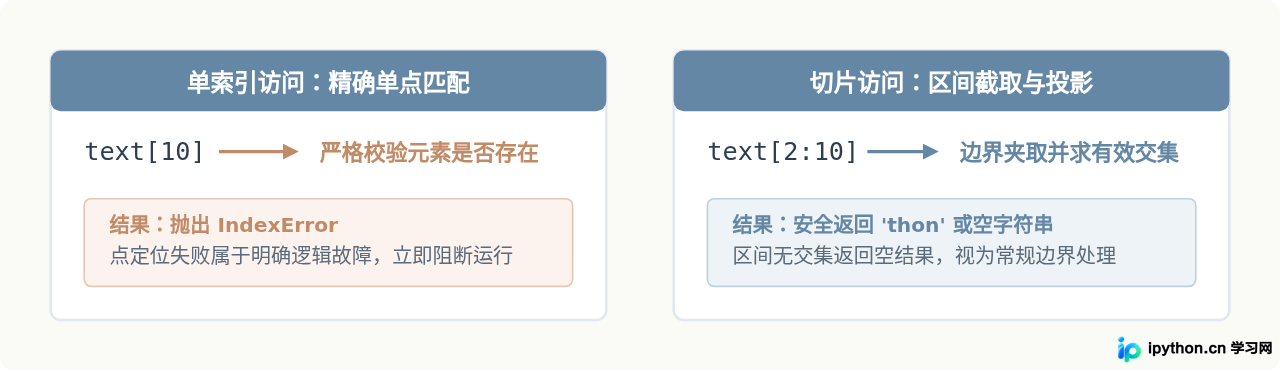
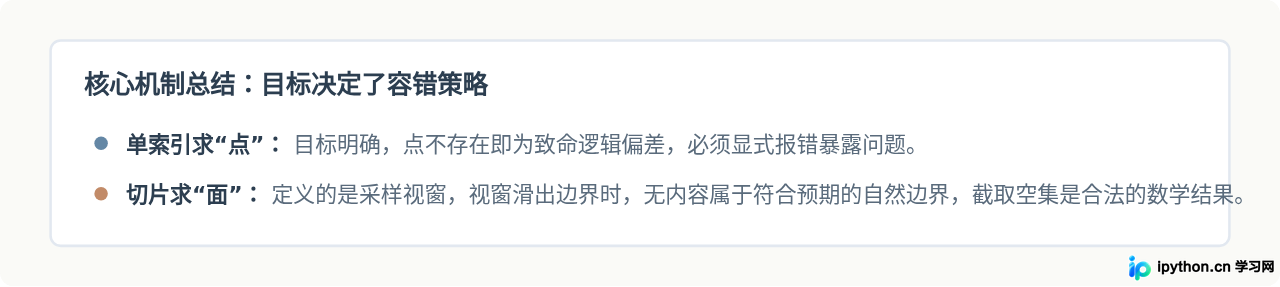
在 Python 中,单字符索引操作(如 s[10])如果超出字符串范围会抛出 IndexError: string index out of range,但范围切片(如 s[2:10])即便索引远远超出长度,却只会截取到有效末尾或直接返回空字符串 ""。这种看似不一致的行为并非语言缺陷,而是 Python 故意为之的设计:单个索引要求精准定位必须存在的目标元素,而切片定义的是一个允许动态伸缩的数据提取区间,底层的边界自动裁剪机制确保了集合截取的高容错性与健壮性。
一、现象对比:单索引与切片的不同反馈
为了直观观察这个现象,我们定义一个长度为 5 的字符串 text = "Python"(实际长度为 6,包含索引 0 到 5)。
text = "Python"

# 1. 单字符索引取值
print(text[2])   # 输出: 't'
# print(text[10]) # 抛出异常: IndexError: string index out of range

# 2. 切片范围提取
print(text[2:10])  # 输出: 'thon'
print(text[10:20]) # 输出: ''在上面的代码中,text[10] 直接导致程序异常终止;而 text[2:10] 不仅没有报错,还提取出了从索引 2 开始直到末尾的全部内容 'thon';更加极端的 text[10:20] 甚至直接输出了一个空字符串。
二、语义模型的差异:点寻址 vs 栅栏模型
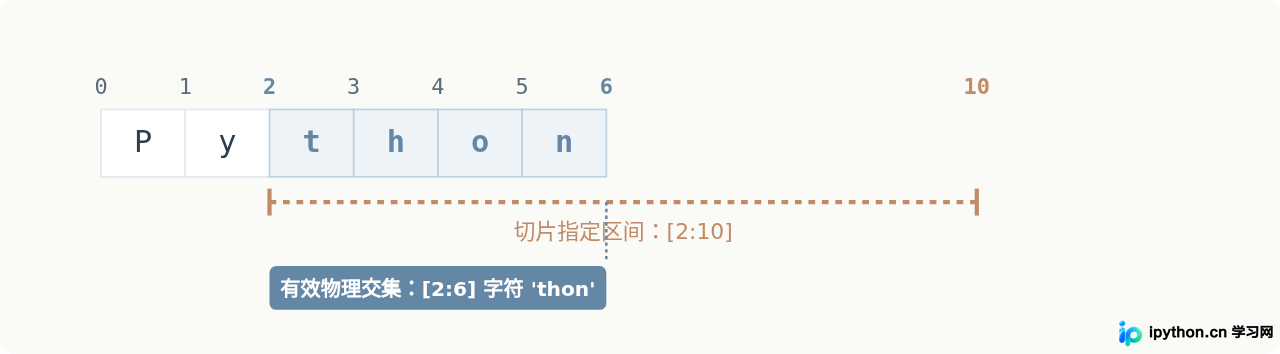
要理解切片为什么不报错,首要的一点是理解 Python 中切片索引的几何含义。我们日常习惯将索引看作“字符下方的序号”,但在切片语法里,更准确的视角是把索引看作字符之间的缝隙(Fenceposts 栅栏模型)。
对于长度为 6 的字符串 "Python",它的切片边界坐标从 0 开始一直延伸到 6:
 字符位置:   P   y   t   h   o   n
 栅栏坐标: |   |   |   |   |   |   |
           0   1   2   3   4   5   6
当执行 text[2:4] 时,表示截取从栅栏标号 2 到标号 4 之间的所有字符,也就是 'th'。这种坐标体系自然地支持开闭区间的数学定义:左闭右开 [start, stop)。
在栅栏模型中,区间的定义本质上是对数轴上一段范围的框选:
- 如果框选的范围
[2, 10]超出了当前已有的栅栏界限[0, 6],Python 会将选区与实际存在的字符范围计算交集,最终交集是[2, 6],即输出剩余字符。 - 如果选取的起始点与终止点都在有效界限之外且没有交集(如
[10, 20]),求交集的结果就是一个空区间,因此返回空字符串。
三、底层执行过程:PySlice_GetIndicesEx 边界截断
在 CPython 解释器底层,一切切片操作的边界换算都由专门的内部函数处理(在 C API 中为 PySlice_Unpack 与 PySlice_AdjustIndices,早期版本对应 PySlice_GetIndicesEx)。
当你执行 text[start:stop:step] 时,解释器会按顺序执行以下四个推导步骤:
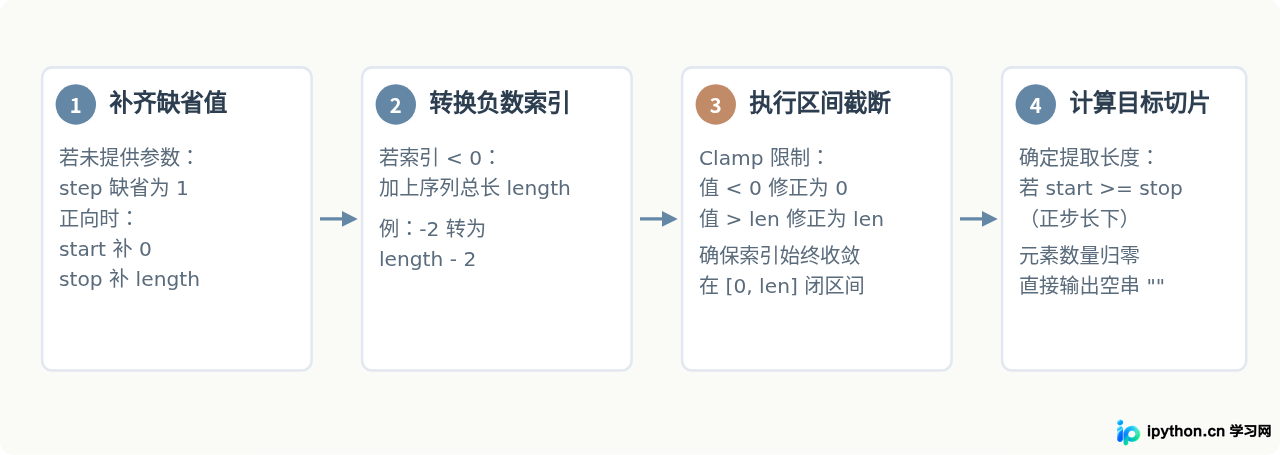
具体来看各个操作数在经历上述流程后的状态变化:
- 对于
text[2:10]:字符串总长length = 6。start = 2无需修改;stop = 10超过了 6,因此在第 3 步被直接强行限制为stop = 6。截取范围变为[2:6],成功返回'thon'。 - 对于
text[10:20]:start = 10被修正为 6,stop = 20被修正为 6。截取范围变为[6:6]。因为起点等于终点,循环步数为 0,返回空字符串""。 - 对于
text[-100:2]:负数索引先加 6 变为 -94,随后在第 3 步小于 0 时被限制为 0。最终截取范围变为[0:2],输出'Py'。
四、为什么如此设计:工程实用性与防御性编程
理解了原理之后,很自然会问:Python 官方为什么不把切片也设计为越界报错?原因在于切片的主要应用场景是批处理和边界截取,自动裁剪机制能大幅简化业务代码。
1. 消除繁重的防御性边界检查
在网络数据解析、文件分块或字符串分页展示时,文本长度往往是动态未知的。如果切片越界会报错,开发者每次截取都必须编写重复的 min() 比较:
# 假设切片会报错时的写法(繁琐且低效)
chunk_size = 10
end_idx = min(start_idx + chunk_size, len(data))
chunk = data[start_idx:end_idx]

# Python 现有的切片机制(简洁安全)
chunk = data[start_idx:start_idx + chunk_size]
无论 data 是否还有足够的剩余长度,切片机制都会尽可能多地返回有效内容,不需要编写额外的溢出保护逻辑。
2. 数据拆分时的无缝连接性
栅栏模型保证了任意两个相邻切片能够自然拼接且不重不漏。对于任意非负整数 k,表达式 s[:k] + s[k:] 的结果永远等于原始字符串 s,即使 k > len(s) 依然恒成立:
text = "Python"
k = 100

# 无论 k 是多大,前缀加后缀始终保持一致
reconstructed = text[:k] + text[k:]
print(reconstructed == text) # 输出: True,text[:100]为'Python',text[100:]为''packet[20:30] 将静默返回 ""。如果后续逻辑未校验长度,可能会将空值误认为是合法数据。在需要严格定长字段的场景下,切片后应主动校验所得内容的实际长度。
五、总结:单索引与切片的特性对比
| 对比维度 | 单索引访问(如 s[i]) |
切片范围提取(如 s[i:j]) |
|---|---|---|
| 语法目标 | 提取容器内的单个具体元素 | 提取满足区间的子序列集合 |
| 越界行为 | 立即抛出 IndexError 异常终止程序 |
静默裁剪至有效边界,无交集则返回空序列 |
| 返回类型 | 对应单个字符(在 Python 中仍为单字符 str) | 与原序列类型一致的子序列(str) |
| 典型使用场景 | 明确需要确认某个位置的内容存在并提取 | 安全截取、批量分包、动态截断、反转等序列操作 |
| 底层实现逻辑 | 0 <= index < length 的硬性断言检查 |
PySlice_AdjustIndices 自动区间夹持与规范化 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















