


Python报错UnidentifiedImageError怎么解决

在 Python 中使用 Pillow(PIL)处理图像时,PIL.UnidentifiedImageError: cannot identify image file 是极其常见的异常。该报错的核心原因是:Pillow 在执行 Image.open() 时,无法从给定的文件路径或字节流中识别出合法的图像文件头(Magic Bytes)。解决该问题的标准路径包括:首先检查文件物理状态排除 0 字节与下载截断;其次纠正网络请求中的字节流读取方式与指针偏移;接着通过魔数嗅探排查伪装为图片的 HTML 拦截页;最后针对 HEIC 或 AVIF 等较新格式补齐第三方解码扩展库。
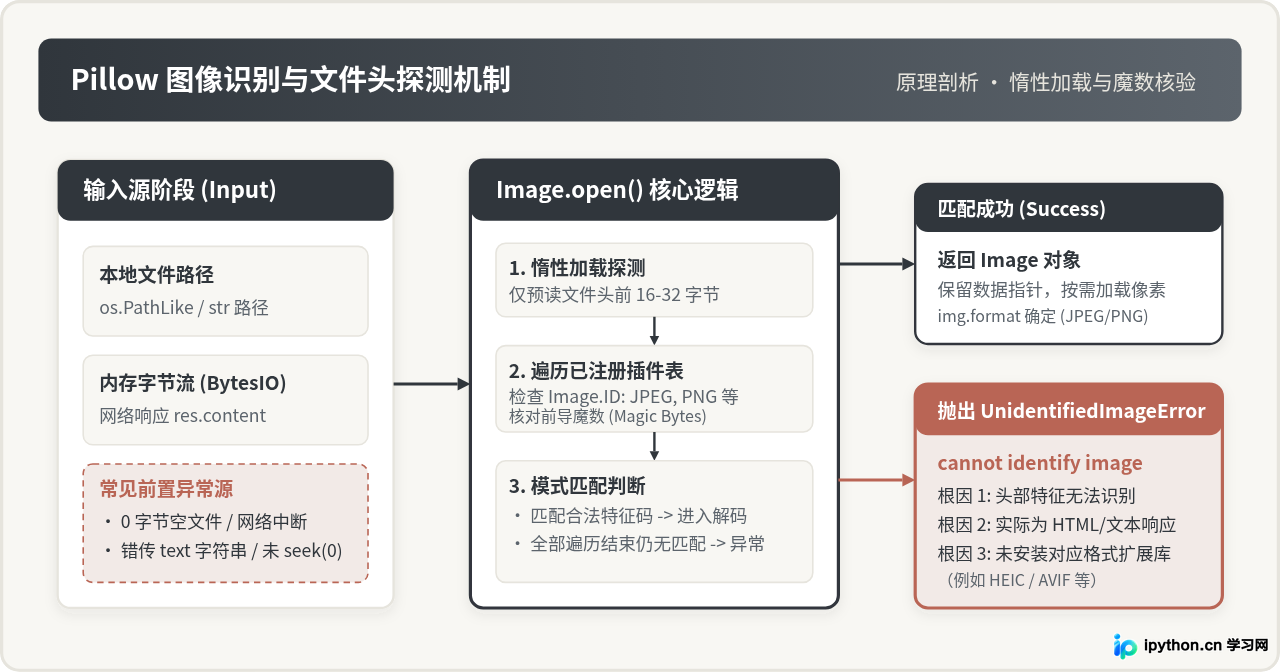
1. 报错成因与 Pillow 识别底层机制
Pillow 采用“惰性加载”(Lazy Loading)架构。调用 Image.open(fp) 时,Pillow 并不会立即将整个图像的完整像素数据解压到内存中,而仅仅是读取文件开头的若干字节(通常为 16 到 32 字节),随后遍历内部已注册的解码插件列表(如 JpegImagePlugin、PngImagePlugin 等)。每个插件会核对自己专属的前导签名魔数(Magic Bytes)。
一旦所有注册插件都无法从数据流头部匹配到已知的签名,Pillow 便会立即抛出 UnidentifiedImageError。引发该异常的具体根因通常可以归结为以下四类:
- 文件损坏或为空:文件体积为 0 字节、本地写入尚未刷盘完成,或者网络下载在传输途中发生异常中断,导致数据头缺失。
- 扩展名与内容严重不符:最典型的场景是爬虫抓取图片链接时,目标服务器返回了包含反爬验证码或 404 错误页面的 HTML 文本,但程序仍将其强行保存为
.jpg或.png。 - 内存字节流读取失误:在使用
requests库下载图片时,错误地读取了response.text导致二进制数据被字符编码篡改;或者对io.BytesIO执行了读取操作后,未调用seek(0)复位读取指针,导致传给 Pillow 时指针已在流末尾。 - 缺少特定格式的解码支持:图像本身是合法的 HEIC/HEIF 或 AVIF 格式,但当前 Pillow 环境未安装对应的底层解码库或桥接插件;或者误将 SVG 矢量图直接传给仅支持光栅图的
Image.open()。
2. 系统排查与定位的四步操作流程
面对该报错,切忌盲目尝试更换文件扩展名。按照“物理文件 -> 内存流 -> 文件魔数 -> 解码依赖”的递进顺序进行排查,能够在数分钟内准确定位并排除故障。
第一步:检查本地文件大小与物理状态
如果是从本地路径加载图片,首要任务是确认该路径下文件确实存在且体积大于 0 字节。多线程任务或异步下载脚本常常在文件尚未写入完毕时就触发了读取逻辑,造成空读。
import os

image_path = "dataset/sample_01.jpg"

if not os.path.exists(image_path):
    raise FileNotFoundError(f"文件不存在: {image_path}")

file_size = os.path.getsize(image_path)
if file_size == 0:
    raise ValueError(f"目标文件为空(0字节),无法解析为图片: {image_path}")

print(f"文件物理检查通过,大小: {file_size} 字节")
第二步:核验网络请求与内存流传递
如果图片来源于网络请求,必须严格从 response.content 提取原始二进制字节。若中途需要对字节流进行哈希校验或预读,必须在传入 Pillow 之前调用 stream.seek(0) 将内部读写游标重置至起点。
import io
import requests
from PIL import Image, UnidentifiedImageError

url = "https://example.com/photo.png"
response = requests.get(url, timeout=10)
response.raise_for_status()

# 核心规范:必须使用 response.content 接收原始二进制流
image_stream = io.BytesIO(response.content)

# 确保读指针处于流起始位置
image_stream.seek(0)

try:
    with Image.open(image_stream) as img:
        img.verify()  # 校验文件完整性
        print(f"图片加载成功,格式: {img.format},尺寸: {img.size}")
except UnidentifiedImageError as err:
    print(f"数据流无法被识别为图像: {err}")
第三步:通过 Magic Bytes 嗅探真实格式
当文件无法识别时,读取其前 16 个字节的十六进制内容,能够直接看清文件的“真实面目”。例如爬虫如果遇到反爬重定向,读取到的前几个字节通常为 b'<!DOCTYPE html>' 或 b'<html>'。
with open("sample.jpg", "rb") as f:
    header = f.read(16)

print("文件前导 16 字节十六进制:", header.hex(" "))
print("ASCII 文本映射:", repr(header))

# 快速判断是否为被拦截的 HTML 响应
if header.startswith(b"<!") or header.startswith(b"<html"):
    print("排查结论:该文件实际上是 HTML 文本页面,并非真实图像。请检查网络爬虫的反爬设置或URL有效性。")
第四步:补充缺失的格式解码扩展库
对于 iPhone 用户广泛使用的 HEIC 格式以及新兴的 AVIF 格式,标准版本的 Pillow 默认不包含解码器。此时需要通过安装专门的插件包并显式注册来扩展 Pillow 的识别能力。
在终端中执行以下命令安装插件:
pip install pillow-heif在 Python 代码中注册插件后,Pillow 即可原生识别 HEIC 图像:
from PIL import Image
from pillow_heif import register_heif_opener

# 注册 HEIF/HEIC 解码器到 Pillow 内部插件树
register_heif_opener()

# 此时直接打开 .heic 文件将不再报错
with Image.open("photo.heic") as img:
    print("HEIC 识别成功,格式:", img.format, "尺寸:", img.size)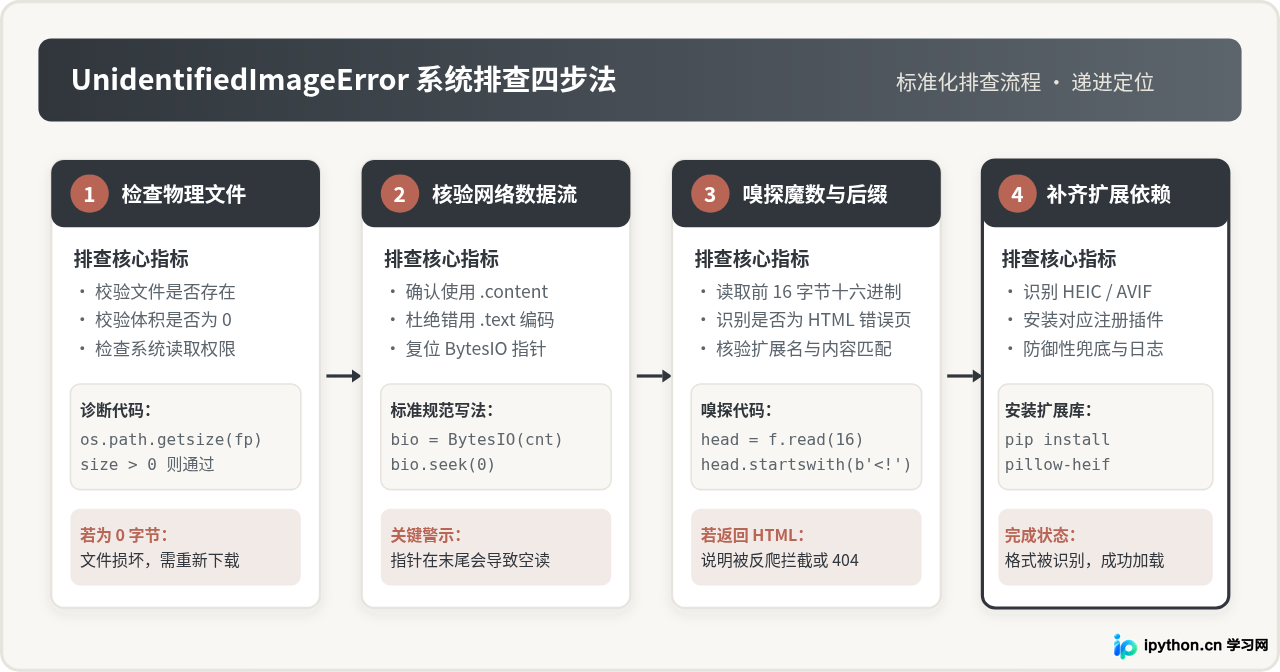
3. 网络请求与内存流高发踩坑对比
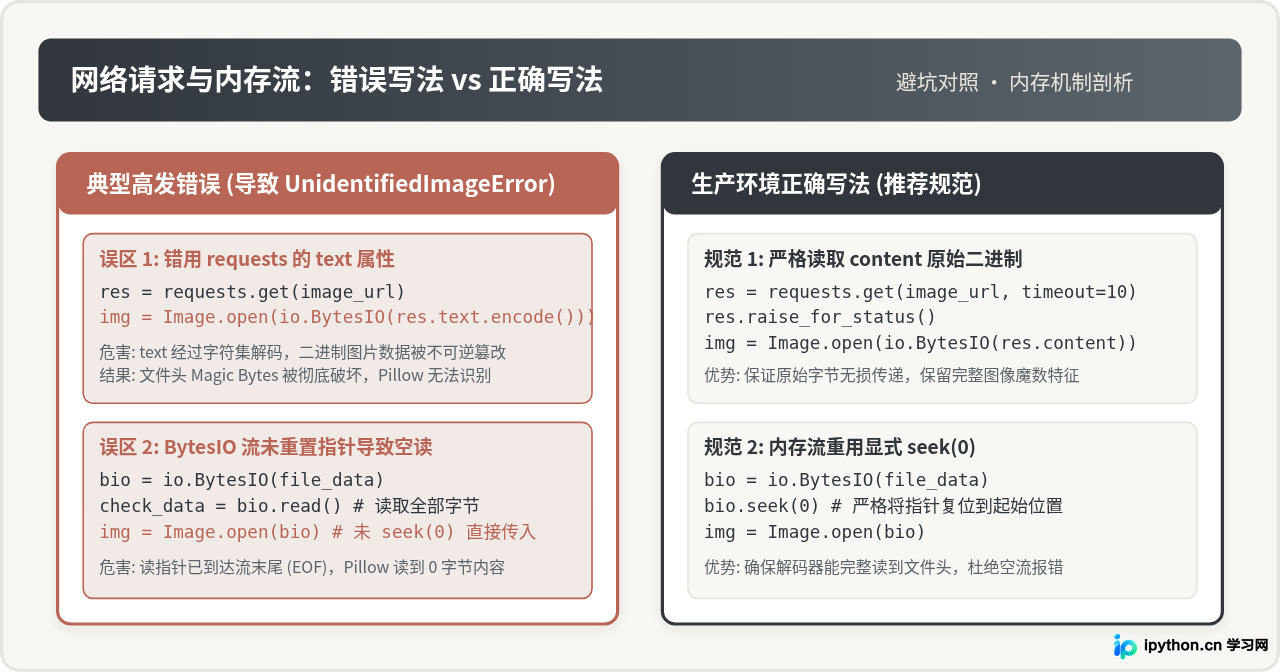
在涉及网络爬虫、API 调用与异步处理的场景中,代码往往容易陷入两类隐蔽的内存操作误区。理解这些误区能够帮助开发者避免在生产环境中反复排查无效数据。
response.text 会根据 HTTP 标头猜测的字符集(如 ISO-8859-1 或 UTF-8)对原始字节流进行字符串转码。在这一过程中,不可见字符或特定多字节序列会被替换或篡改,导致图像特有的二进制魔数被破坏。无论后续再怎样执行 .encode(),丢失的数据都无法复原。必须永远使用 response.content 提取未经任何字符处理的原始字节。
io.BytesIO 维护了一个内部读取偏移量指针。如果为了记录哈希值先调用了 hashlib.md5(bio.read()).hexdigest(),指针就会停留在字节流的最后一位。随后直接将 bio 传入 Image.open(bio),Pillow 调用 bio.read(32) 时只能读到 b''(0字节),进而立刻触发 UnidentifiedImageError。只需在二次读取前补充一句 bio.seek(0) 即可彻底解决。
4. 主流图像格式 Magic Bytes 与依赖速查
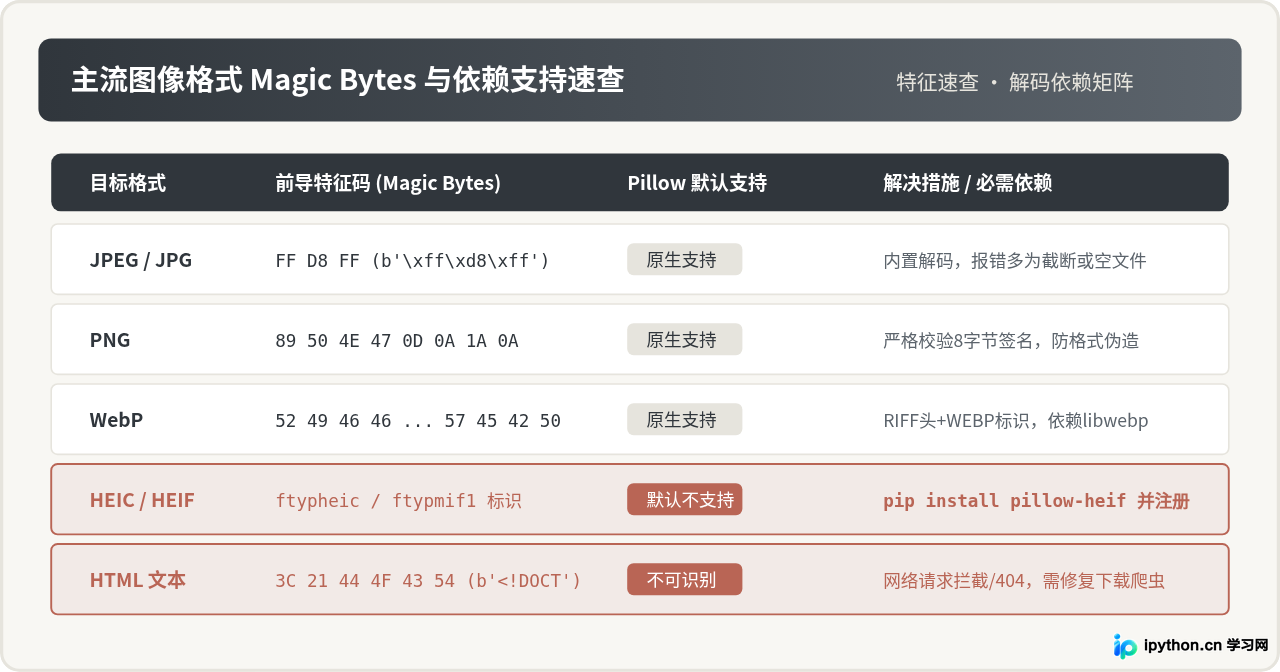
下表梳理了常见图像格式的文件头特征签名以及在 Pillow 中的支持要求。在编写自动化图像清洗管道时,可以直接通过比对前导字节对输入文件进行快速预检分类。
值得特别说明的是 SVG 矢量图形。Pillow 是专为位图像素网格设计的图像处理库,并不支持矢量图形的解析与光栅化渲染。如果业务中必须处理 SVG 文件,应该使用专门的矢量图工具(例如 cairosvg)将其转换为 PNG 位图后,再交由 Pillow 进行后续编辑操作:
import io
import cairosvg
from PIL import Image

# 将矢量 SVG 栅格化转换为 PNG 字节流
png_bytes = cairosvg.svg2png(url="icon.svg")

# 交由 Pillow 打开位图
with Image.open(io.BytesIO(png_bytes)) as img:
    print("SVG 栅格化后成功打开,尺寸:", img.size)
5. 生产环境防御性加载方案与完整代码
在生产环境的批量图像处理流水线中,单张损坏图片的异常不应阻断整个批量任务的执行。构建高健壮性的加载函数应包含三个层级:前置状态校验、魔数预检分发以及结构化异常捕获与回退。
以下是经过工业级验证的完整防御性图像加载实现:
import io
import os
import logging
from typing import Optional, Union
from PIL import Image, UnidentifiedImageError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("ImageLoader")

# 尝试挂载 HEIC 扩展插件
try:
    from pillow_heif import register_heif_opener
    register_heif_opener()
    HEIF_SUPPORTED = True
except ImportError:
    HEIF_SUPPORTED = False

def safe_load_image(source: Union[str, bytes, io.BytesIO]) -> Optional[Image.Image]:
    """
    防御性加载图像,具备前置检查、魔数嗅探与分级异常保护。
    成功返回 PIL.Image 实例,失败返回 None 并记录准确原因。
    """
    stream: io.BytesIO

    # 1. 统一转换为 BytesIO 内存流并完成前置体积校验
    if isinstance(source, str):
        if not os.path.exists(source):
            logger.error(f"加载失败:物理文件不存在 -> {source}")
            return None
        file_size = os.path.getsize(source)
        if file_size == 0:
            logger.error(f"加载失败:物理文件为空(0字节) -> {source}")
            return None
        with open(source, "rb") as f:
            stream = io.BytesIO(f.read())
    elif isinstance(source, bytes):
        if len(source) == 0:
            logger.error("加载失败:输入的字节数组为空")
            return None
        stream = io.BytesIO(source)
    elif isinstance(source, io.BytesIO):
        stream = source
    else:
        logger.error(f"加载失败:不支持的数据源类型 -> {type(source)}")
        return None

    # 2. 强制复位游标至文件起始
    stream.seek(0)
    header = stream.read(16)
    stream.seek(0)

    # 3. 拦截常见伪装文件(HTML 错误响应)
    if header.startswith(b"<!") or header.startswith(b"<html"):
        logger.error("加载失败:文件头识别为 HTML 页面,属于被拦截的网络响应或 404 页面")
        return None

    # 4. 尝试执行加载与完整性校验
    try:
        image = Image.open(stream)
        image.load()  # 强制解码像素,尽早暴露截断等深层损坏
        return image
    except UnidentifiedImageError as err:
        logger.error(f"格式无法识别(UnidentifiedImageError): {err}")
        if not HEIF_SUPPORTED:
            logger.warning("提示:当前环境未安装 pillow-heif,如目标为苹果实况照片格式请执行 pip install pillow-heif")
        return None
    except OSError as err:
        logger.error(f"图像数据底层损坏或截断(OSError): {err}")
        return None
    except Exception as err:
        logger.error(f"未预期的加载异常: {err}")
        return None

# 示例调用
if __name__ == "__main__":
    # 场景 A: 传入正常文件(示例)
    valid_png_bytes = b"\x89PNG\r\n\x1a\n\x00\x00\x00\rIHDR\x00\x00\x00\x01\x00\x00\x00\x01\x08\x06\x00\x00\x00\x1f\x15c4\x00\x00\x00\nIDATx\x9cc\x00\x01\x00\x00\x05\x00\x01\r\n-\xb4\x00\x00\x00\x00IEND\xaeB`\x82"
    result_valid = safe_load_image(valid_png_bytes)
    print("有效二进制加载结果:", "成功" if result_valid else "失败")

    # 场景 B: 传入 0 字节空流
    result_empty = safe_load_image(b"")
    print("空字节流加载结果:", "成功" if result_empty else "失败(符合预期安全拦截)")

    # 场景 C: 传入 HTML 错误文本
    html_bytes = b"<!DOCTYPE html><html><body>404 Not Found</body></html>"
    result_html = safe_load_image(html_bytes)
    print("HTML文本加载结果:", "成功" if result_html else "失败(符合预期安全拦截)")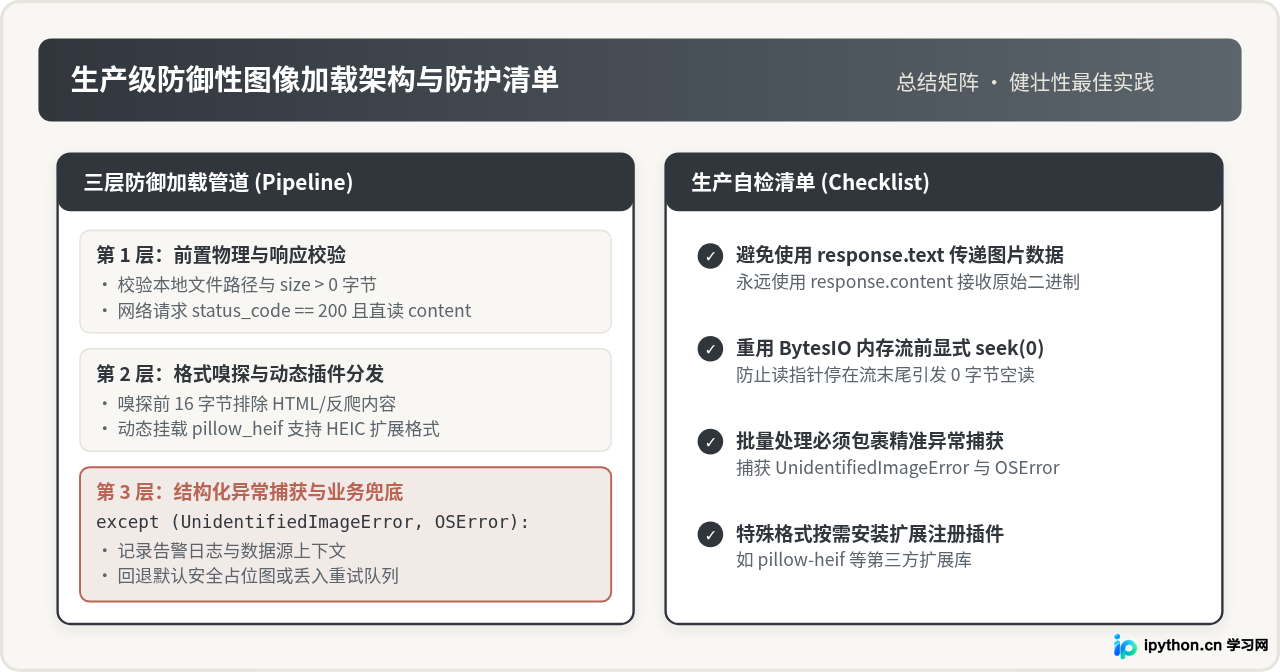
6. 常见疑问与疑难场景排查
为什么本地图片用系统照片查看器能正常打开,Pillow 却报错?
现代操作系统(Windows 照片、macOS Preview)内置了极强的容错修复机制与自动解码器。即使文件扩展名写错(例如实际上是 WebP 却命名为 .jpg),系统查看器也会在后台通过文件签名自动切换到正确的渲染引擎。另外,若文件尾部轻微截断,查看器通常会默认忽略尾部缺失并渲染已有部分。而 Pillow 在默认情况下更为严谨,如果扩展名与内部注册机制发生严重冲突,或文件头损坏,就会直接抛出 UnidentifiedImageError。按照前文第三步检查真实 Magic Bytes 即可找出根本差异。
高并发抓取图片时偶发该错误,如何解决?
在高并发爬虫或大批量下载任务中,偶发性报错通常由网络连接中途被重置导致数据截断引发。建议在保存或处理前,先核对 HTTP 响应头中的 Content-Length 与实际接收到的 len(response.content) 是否完全一致。如果不一致,说明下载不完整,应将其推入重试队列重新拉取,避免半成品数据流入下游图像处理逻辑。
Pillow 在加载截断图片时报 OSError,是否和本错误相关?
两者属于不同阶段的异常。UnidentifiedImageError 发生在文件头匹配阶段,说明文件头本身就无法被任何解码器接管;而 OSError: image file is truncated 发生在解码器已识别文件头、但在解压缩图像像素流时遇到了过早结尾。若业务允许展示不完整的破损图像,可以通过设置 from PIL import ImageFile; ImageFile.LOAD_TRUNCATED_IMAGES = True 允许容错加载截断文件,但对于无法识别头部的 UnidentifiedImageError,此设置不起作用,仍需按本文四步法彻底修复数据源。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















