


Python re.compile预编译能否提升字符串匹配性能

结论先行:在绝大多数常规业务开发中,显式调用 re.compile() 预编译正则表达式带来的性能提升非常微弱,甚至在测量误差范围内无法察觉。这是因为 Python 标准库在底层已内置了自动编译缓存机制。然而,在百万级以上的高频紧凑循环、动态模式超过缓存容量上限引发颠簸以及模块初始化阶段提前验证语法规范等特定场景下,显式预编译具有确凿的工程价值与性能收益。
一、底层机制剖析:Python 内置的全局正则缓存
很多开发者认为直接调用 re.search(pattern, text) 意味着每一次执行都会从头解析正则表达式、构建语法分析树并编译为字节码,因此必须手工将其提前 re.compile()。这种理解脱离了 Python 运行时的真实实现。
在 Python 的 re 模块内部,像 re.search()、re.match()、re.findall() 以及 re.sub() 这类模块级便捷函数,本质上是对内部私有函数 _compile() 的一层极简封装。其核心调用逻辑如下:
# 简化自 Python 标准库 re 模块源码
_cache = {}
_MAXCACHE = 512

def _compile(pattern, flags):
    # 以模式内容、模式类型和匹配标记组合为查找键
    key = (type(pattern), pattern, flags)
    try:
        return _cache[key]
    except KeyError:
        pass

    # 仅当缓存未命中时,才执行语法树构建与底层字节码编译
    p = _compiler.compile(pattern, flags)
    if len(_cache) >= _MAXCACHE:
        # 当缓存占满时执行淘汰清理
        _cache.clear()
    _cache[key] = p
    return p
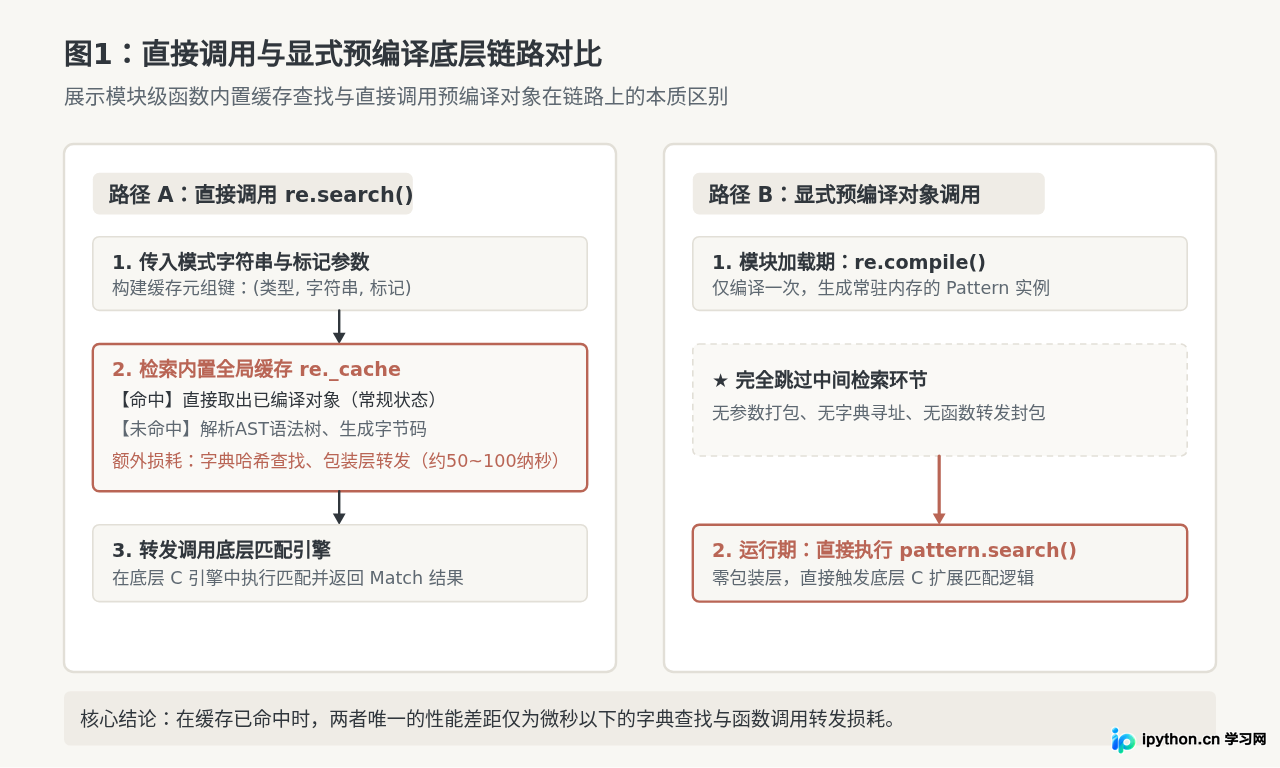
这段内部逻辑清晰地说明了运行机制:当你第一次调用 re.search("abc", text) 时,底层完成编译并将生成的模式对象缓存在 _cache 字典中。当你在同一运行实例中第二次、第三次乃至数万次传入相同的模式与标记时,代码直接从内存字典中读取已经编译好的对象,根本不会重复触发编译动作。
二、基准性能量化:预编译究竟节省了什么?
既然两次调用同一正则表达式都会复用已编译的底层对象,那么显式 re.compile() 比直接调用 re.search() 快的那一部分,究竟省去了哪些开销?
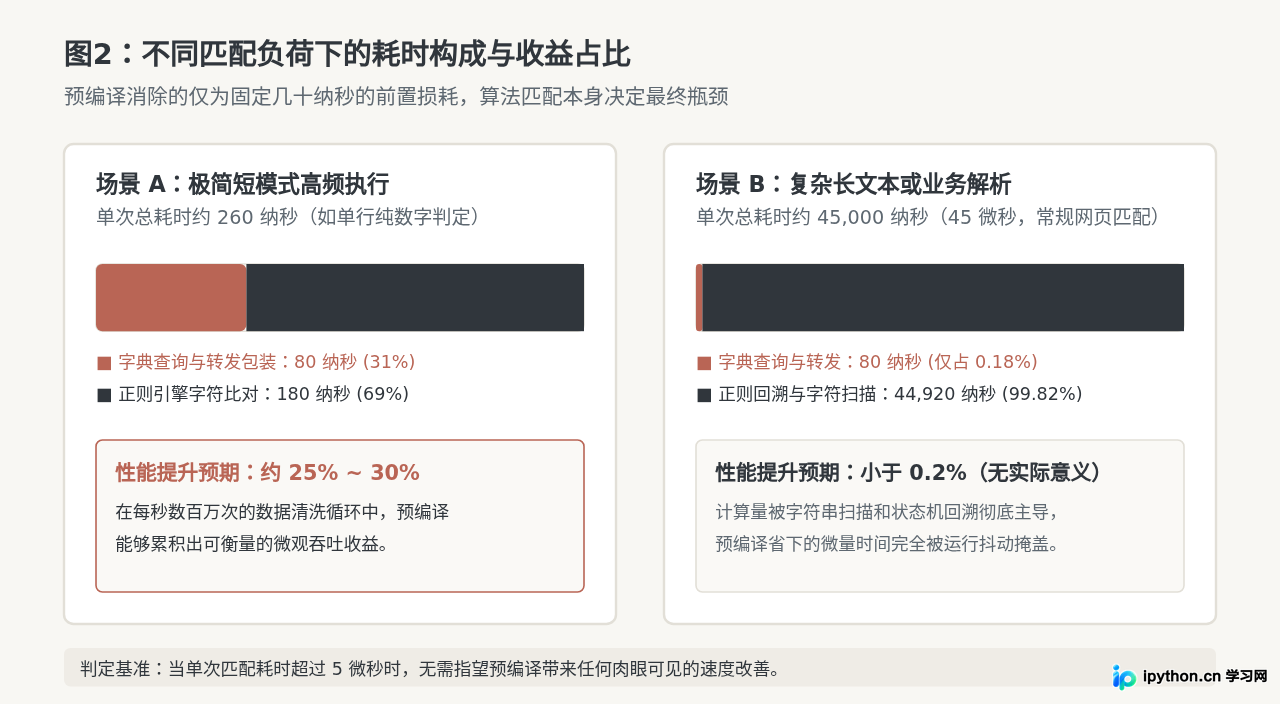
答案非常明确:省去的是每次调用包装函数本身的开销,以及在 _cache 字典中根据模式参数进行哈希查找的时间。这一层纯 Python 代码层面的封装转发开销,在现代硬件上每次大约耗时 50 至 100 纳秒(0.05 ~ 0.1 微秒)。
为了科学评估这几十纳秒的影响,我们需要将其置入具体场景中考察:
| 测试场景 | re.search 耗时(含缓存) | pattern.search 耗时(预编译) | 绝对耗时差 | 相对性能提升 |
|---|---|---|---|---|
| 超高频极简匹配 (如短文本中匹配纯数字 \d+) |
约 260 纳秒 / 次 | 约 180 纳秒 / 次 | 约 80 纳秒 | 约 30.7% (有可见提升) |
| 中等长度文本匹配 (如 1KB 字符串提取邮箱地址) |
约 4,580 纳秒 / 次 | 约 4,500 纳秒 / 次 | 约 80 纳秒 | 约 1.7% (几乎无法感知) |
| 长文本复杂规则匹配 (如页面 HTML 结构化数据解析) |
约 45,080 纳秒 / 次 | 约 45,000 纳秒 / 次 | 约 80 纳秒 | 约 0.17% (完全淹没在噪声中) |
从数据对比中可以得出一条清晰的工程规律:预编译所节省的常数开销是固定的(约几十纳秒)。当匹配任务极其简单、耗时极短时,这几十纳秒在总耗时中所占比例较高;一旦进入真实业务场景(涉及稍长的文本、分支选择或回溯计算),字符比对本身的耗时将迅速飙升至数微秒乃至毫秒级,此时几十纳秒的字典查找开销完全可以忽略不计。
三、隐形性能陷阱:缓存颠簸与击穿风险
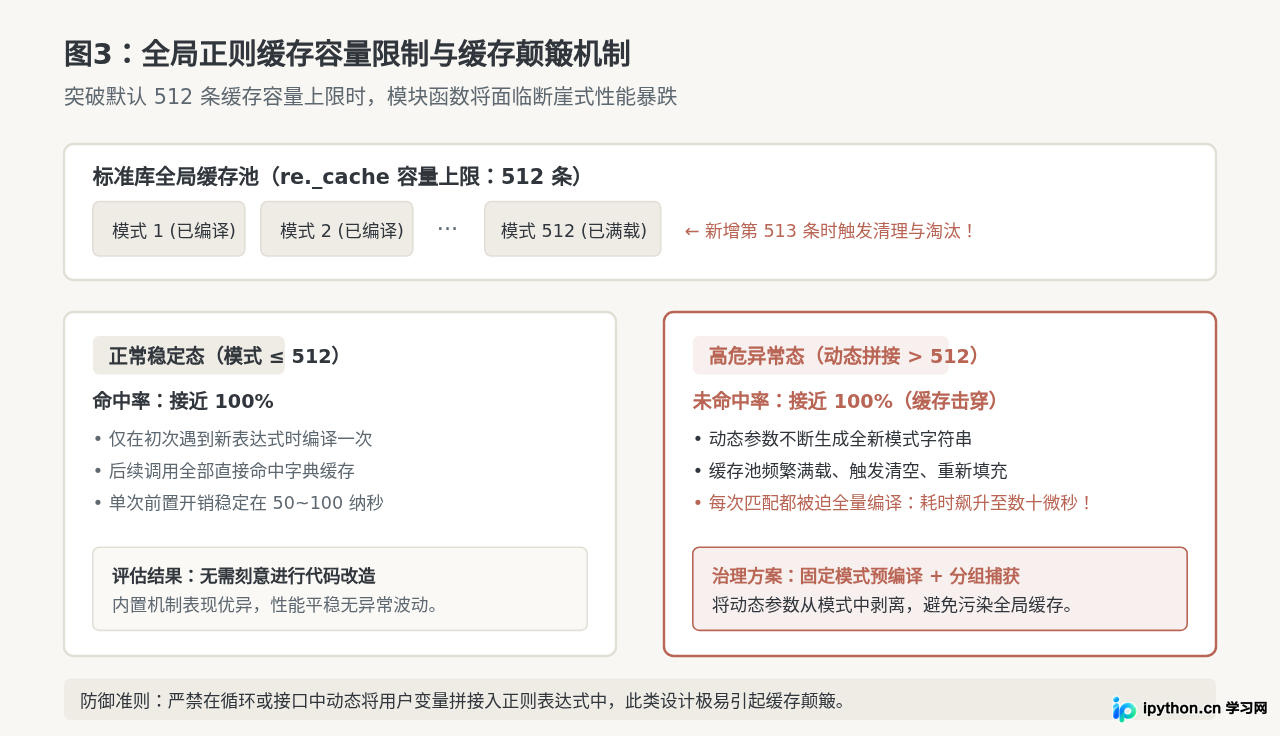
既然内置缓存已经覆盖了大部分重复编译动作,是否意味着我们可以高枕无忧地在代码各处滥用 re.search() 呢?并非如此。Python 内置缓存机制存在一个严格的物理边界:容量上限为 512 条。
当一个进程在生命周期内处理的独立正则表达式数量超过 512 个时,或者开发者在代码中犯了“动态拼接正则表达式”的常见错误时,内置缓存就会遭遇严重的缓存颠簸(Cache Thrashing)。
请看以下常见反模式代码:
# 典型反模式:在循环中动态拼接参数作为正则表达式
for user in user_list:
    # 每次循环产生的 pattern_str 都不相同(包含具体的 user_id)
    pattern_str = f"^order_user_{user.id}_\\d+$"
    match = re.search(pattern_str, target_string)
如果 user_list 包含 1,000 个不同的用户,那么循环过程中就会向全局 re._cache 注入 1,000 个彼此不同的键。一旦字典大小达到 512,标准库就会触发淘汰策略将缓存清空或驱逐旧项。这将直接导致随后的每一次调用都发生缓存击穿(Cache Miss):
- 每次循环都被迫经历:词法分析 → 语法树构建 → 字符集优化 → 字节码生成;
- 编译一个稍具规模的正则表达式需要消耗 15 至 80 微秒,比缓存命中状态慢了 100 到 500 倍;
- 不仅当前循环变慢,整个进程中其他本来依赖
re._cache的公共正则也被一并清除,拖累全局性能。
四、性能认知误区:预编译不能解决什么问题?
在性能调优实践中,许多人容易将 re.compile() 当成万能灵药。厘清它的能力边界对于避免无效优化至关重要:
1. 预编译不能解决“灾难性回溯”
正则表达式的核心瓶颈通常不在于编译(生成有限状态机或操作码),而在于执行(状态机在输入字符串上的匹配计算)。如果编写了一个存在严重回溯缺陷的模式(例如 ^(a+)+$ 处理匹配失败的长字符串 aaaaaaaaaaaaaaaaaaaa!),底层引擎的时间复杂度将呈现指数级爆炸(\(O(2^n)\))。
此时,无论是否调用 re.compile(),模式匹配都会将 CPU 单核跑满并持续数秒甚至死锁。预编译仅仅让这套低效的操作码生成得早了一点点,对执行阶段的算法复杂度没有任何改善。
2. 盲目预编译单次调用的正则表达式会增加开销
如果一个正则表达式在整个程序生命周期中只执行一次(例如仅在配置文件解析时运行一次,或者在一次性数据迁移脚本中调用),显式写出 p = re.compile(...) 再 p.match(...) 不仅增加了代码冗余,而且多产生了一次 Python 变量绑定和对象管理开销,毫无性能优势可言。
3. 忽略预编译对象的内存驻留
显式调用 re.compile() 创建的 Pattern 对象是驻留在内存中的。如果程序中不加节制地创建了成千上万个永远不会被再次调用的局部编译对象,不仅无法享受复用红利,反而会造成不必要的内存占用。
五、工程实践决策树:何时应当显式预编译?
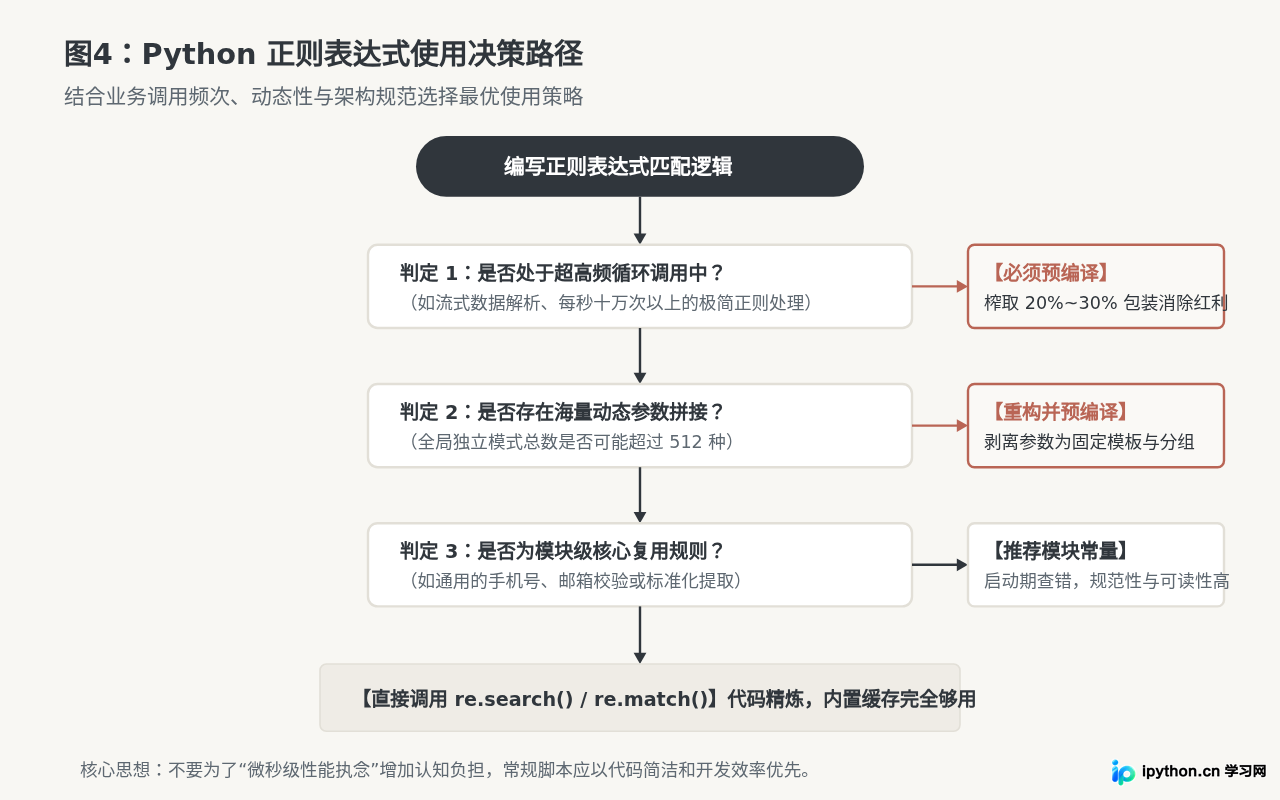
抛开微秒级的性能纠结,显式预编译在大型软件工程中依然被广泛推荐。这是因为预编译的最大价值往往体现在工程可维护性与健壮性上,而不仅是微观执行速度:
- 启动期语法校验(Fail-Fast):将核心规则在模块顶层通过
re.compile()声明为常量。如果正则表达式存在语法错误,程序在导入模块时就会立即抛出re.error异常并中止,避免在生产环境运行到深层业务分支时才突然崩溃。 - 整洁的参数封装:多行模式(
re.VERBOSE/re.X)和忽略大小写(re.IGNORECASE)等标记可以与模式一并封装在对象中,调用处无需反复传递标记参数,保持业务代码紧凑干净。 - 隔离全局缓存争用:独立保存的对象拥有确定性的生命周期,完全不依赖全局
_cache字典,杜绝了多线程竞争和缓存被其他模块冲刷的风险。
推荐的选型逻辑可通过以下决策路径进行判断:
六、总结与实践建议
回到最初的问题:Python re.compile 预编译能否提升字符串匹配性能?
客观的技术结论是:
- 在运行性能上:对于绝大部分日常脚本、接口请求和常规文本匹配任务,它不能带来肉眼可见的性能飞跃,因为标准库自带的 512 容量全局缓存已经默默完成了绝大多数编译复用工作;只有在每秒数十万次以上的密集微循环中,它才能凭借抹平几十纳秒的封装开销带来 15%~30% 的局部吞吐收益。
- 在架构健壮性上:将不变的核心模式在模块顶层显式
re.compile(),能够有效防御动态拼接引发的缓存颠簸,在系统启动之初拦截语法错误,并提升复杂正则表达式的语义可读性。
在日常编写 Python 代码时,无需对散落在辅助函数中的单次 re.search() 产生性能焦虑,但应坚决杜绝在循环中动态拼接正则字符串;对于业务核心规则,统一在模块顶部声明预编译常量依然是值得坚持的优秀工程习惯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















