


Python截图OCR中文识别率低?试试PaddleOCR或图像预处理

在用 Python 提取屏幕截图中的中文时,很多人会直接调用 Tesseract(pytesseract),随后发现生僻字漏识、相近字误判、标点混乱等问题频繁出现。要解决屏幕截图中文识别率低的问题,核心路径只有两条:一是换用原生支持现代深度学习中文字符集的识别引擎(如 PaddleOCR);二是在送入引擎前,利用 OpenCV 对截图执行针对性的尺寸放大与二值化预处理。
一、为什么屏幕截图的中文特别难识别?
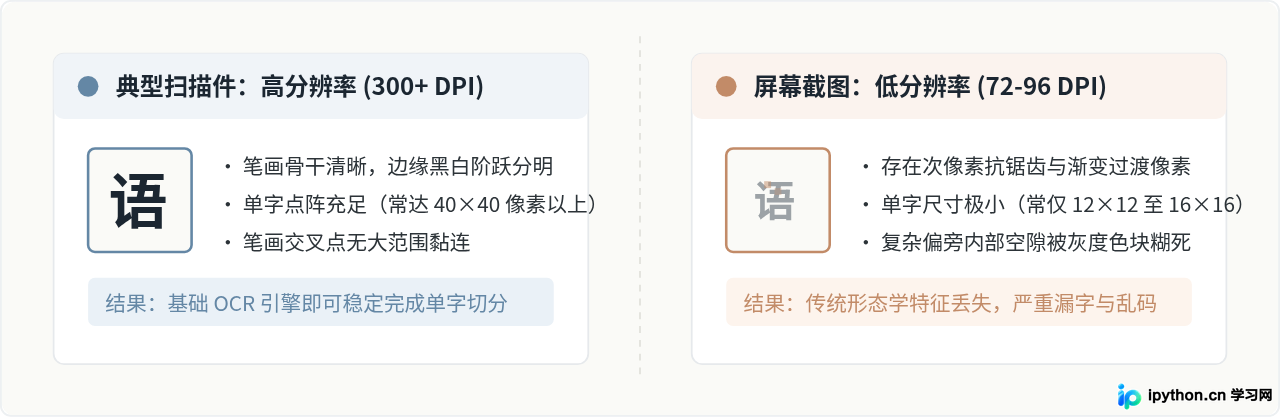
许多开发者在开发桌面辅助、网页自动化或游戏脚本时,第一反应是用 PIL.ImageGrab 截取局部画面,然后直接送给 OCR 引擎解析。这种做法在处理英文数字时偶有成效,但面对中文时错误率往往居高不下。这并不是代码写法有误,而是由屏幕图像本身的物理特征决定的。
主要原因可归纳为以下三点:
- 物理分辨率极低:印刷纸张的扫描件通常有 300 DPI 或更高精度,笔画分明;而标准显示器屏幕仅有 72 到 96 DPI,文字在微观像素上非常紧凑,部分汉字复杂笔画甚至只占单行 1 到 2 个物理像素。
- 子像素抗锯齿造成的边缘模糊:操作系统在渲染屏幕字体时,会采用 ClearType 或平滑抗锯齿技术。文字边缘混合了半透明甚至彩色的过渡像素,在灰度化后会变成大面积的淡灰色毛刺,破坏汉字骨架。
- 模型先验知识脱节:早期 OCR 引擎如 Tesseract 依赖形态学投影和单字切分,更擅长处理结构离散的西文字母。中文汉字多达数千常用字,形近字多、部首密集,如果没有现代深层卷积网络和序列注意力的支持,很难在低分辨率截图里把“大”和“太”、“日”和“曰”区分开来。
二、方案一:换用中文字符感知更强的 PaddleOCR
如果当前正在使用 Tesseract 处理截屏中文,最立竿见影的方案是替换识别核心。百度开源的 PaddleOCR 针对中文场景设计,采用了轻量级的 DB 文本检测算法与 SVTR/CRNN 序列识别架构,在低分辨率屏幕文字、网页渲染字体上具有明显优势。
1. 依赖安装
在 Python 运行环境中,安装 paddlepaddle 以及 paddleocr 工具库。CPU 环境下可直接执行以下命令:
pip install paddlepaddle -i https://pypi.tuna.tsinghua.edu.cn/simple
pip install paddleocr -i https://pypi.tuna.tsinghua.edu.cn/simplePaddleOCR 类时,程序会自动从官方源拉取轻量级检测模型(det)、方向分类模型(cls)与识别模型(rec)。请确保运行机器能够访问外网,或提前下载离线模型解压到本地指定目录。
2. 屏幕截图并执行识别的完整示例
以下代码截取指定屏幕区域并直接送入 PaddleOCR 进行检测与解析。无需提前将图片保存为临时文件,通过内存数据流即可完成处理:
import numpy as np
from PIL import ImageGrab
from paddleocr import PaddleOCR

# 初始化 PaddleOCR 实例,使用简体中文识别模型
# use_angle_cls=False 在纯水平桌面截图中可关闭,提高运行速度
ocr = PaddleOCR(use_angle_cls=False, lang="ch")

# 1. 抓取屏幕特定区域 (左, 上, 右, 下) 坐标
bbox = (100, 100, 600, 400)
screenshot = ImageGrab.grab(bbox)

# 2. PIL Image 转换为 PaddleOCR 接受的 numpy ndarray (RGB 格式)
img_np = np.array(screenshot)

# 3. 执行识别
result = ocr.ocr(img_np, cls=False)

# 4. 解析输出
print("--- 识别结果 ---")
if result and result[0]:
    for line in result[0]:
        box = line[0]        # 文本框四个顶点坐标
        text, score = line[1] # 识别出的文本与置信度
        print(f"置信度: {score:.2f} | 文本: {text}")
else:
print("未检测到有效文字")在同等未处理的低分辨率截图条件下,PaddleOCR 对复杂字形(如“藏”、“囊”、“警”)的结构还原能力显著优于传统模板匹配类引擎。
三、方案二:用 OpenCV 构建精准的预处理管线
如果由于部署环境限制(例如设备内存极度受限、必须使用内置的 Tesseract 或轻量级推理引擎),无法引入完整的 PaddlePaddle 深度学习运行时,那么对截图进行图像预处理是挽救识别率的唯一可靠手段。
针对屏幕截图的预处理目标非常明确:拉开字号以补足空间采样、剔除抗锯齿过渡色阶、增强笔画连通性。一套经得起检验的截屏预处理流程包含以下步骤:
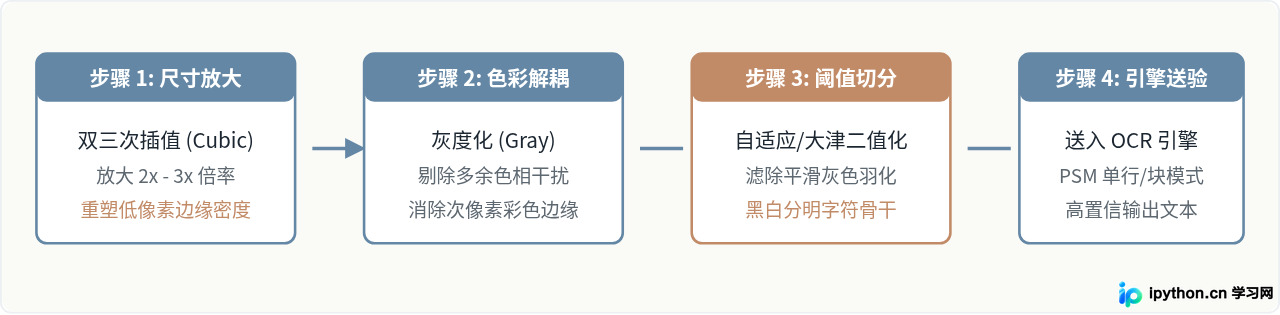
预处理代码实现
以下代码使用 OpenCV(opencv-python)实现完整的预处理流水线,并将结果交给 Tesseract 进行中文识别:
import cv2
import numpy as np
from PIL import ImageGrab
import pytesseract

def preprocess_screen_image(pil_img):
    # 1. PIL 图像转换为 OpenCV 的 BGR 矩阵
    src = cv2.cvtColor(np.array(pil_img), cv2.COLOR_RGB2BGR)

    # 2. 几何放大:双三次插值 (INTER_CUBIC)
    # 将低分辨率图像拉大 2 到 3 倍,使每个汉字的有效笔画宽度达到 3 像素以上
    height, width = src.shape[:2]
    scaled = cv2.resize(src, (width * 2, height * 2), interpolation=cv2.INTER_CUBIC)

    # 3. 灰度化:剔除抗锯齿形成的彩色像素
    gray = cv2.cvtColor(scaled, cv2.COLOR_BGR2GRAY)

    # 4. 二值化:使用 OTSU 大津算法自动寻找最合适的分界阈值
    # 若文字背景复杂(有渐变底色),可替换为 cv2.adaptiveThreshold
    _, binary = cv2.threshold(gray, 0, 255, cv2.THRESH_BINARY | cv2.THRESH_OTSU)

    return binary

# 捕获屏幕截图
bbox = (150, 200, 500, 320)
raw_img = ImageGrab.grab(bbox)

# 处理图像
processed_img = preprocess_screen_image(raw_img)

# 传入 pytesseract,指定中文简体语言包 (chi_sim)
# --psm 6 表示假设图像为单一均匀的文本块
custom_config = r'--oem 3 --psm 6'
text = pytesseract.image_to_string(processed_img, lang='chi_sim', config=custom_config)

print("识别文本如下:")
print(text.strip())cv2.INTER_CUBIC 而非 INTER_NEAREST(最近邻)?最近邻插值会直接复制像素,产生生硬的阶梯锯齿;而双三次插值能够平滑计算临近像素的过渡,为随后的二值化操作提供平稳的梯度分界。
四、组合运用:预处理对 PaddleOCR 同样有效吗?
一个常见的误区是:“既然 PaddleOCR 识别能力强,是不是就完全不需要预处理了?”
答案取决于文字大小。如果屏幕截取的文字属于网页标题、正文等标准字号(14px 以上),PaddleOCR 可以直接处理得很好。但如果是桌面软件状态栏、右键菜单、表格细小标注(10px 至 12px 左右的极小字号),PaddleOCR 内部的文本检测网络(DBNet)很可能直接将细小字块误判为背景噪点,导致整行文字被漏检。
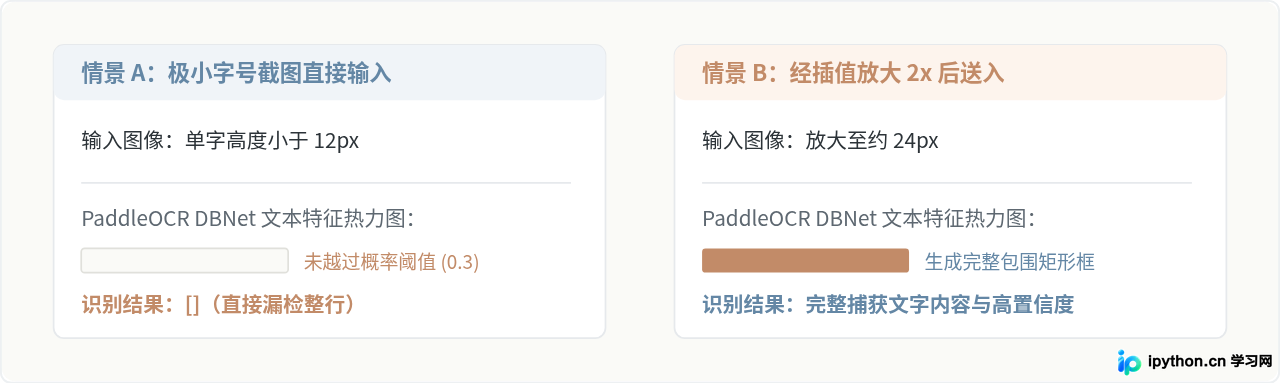
对 PaddleOCR 进行辅助预处理时,只需要做放大操作,不要做硬二值化。因为现代深度学习模型在训练时学习了大量包含抗锯齿边缘的真实字形,强制二值化反而会抹去笔画灰度中的语义信息,破坏识别器的特征提取。
五、两种路线的适用条件与决策对比
为了帮助读者根据实际项目限制快速决断,下表列出了常见开发场景下的选型建议:
| 对比维度 | 方案 A:OpenCV 预处理 + Tesseract | 方案 B:直接或配合放大 + PaddleOCR |
|---|---|---|
| 核心优势 | 运行极其轻量,资源占用低,无深度学习运行时依赖 | 中文原生的超高识别率,能自适应各种艺术字与低清字 |
| 典型短板 | 极度依赖预处理阈值调优,背景稍有渐变即乱码 | 依赖 Paddle 框架,首次加载稍慢,打包分发体积较大 |
| 适用场景 | 纯黑白简单文本、嵌入式设备、包体积受限的轻量级小脚本 | 绝大部分日常截屏提取、UI 自动化测试、跨语言混合图文分析 |
| 关键参数建议 | INTER_CUBIC 放大 2-3 倍,配合 OTSU 二值化 |
小字截图放大 1.5-2 倍即可,保持 RGB 格式输入 |
六、总结与落地决策树
解决 Python 屏幕截图中文识别率低的问题,不需要盲目尝试各种偏门滤镜。遵循一套清晰的排查与处理逻辑,即可在绝大多数业务场景中获得稳定可用的解析结果。
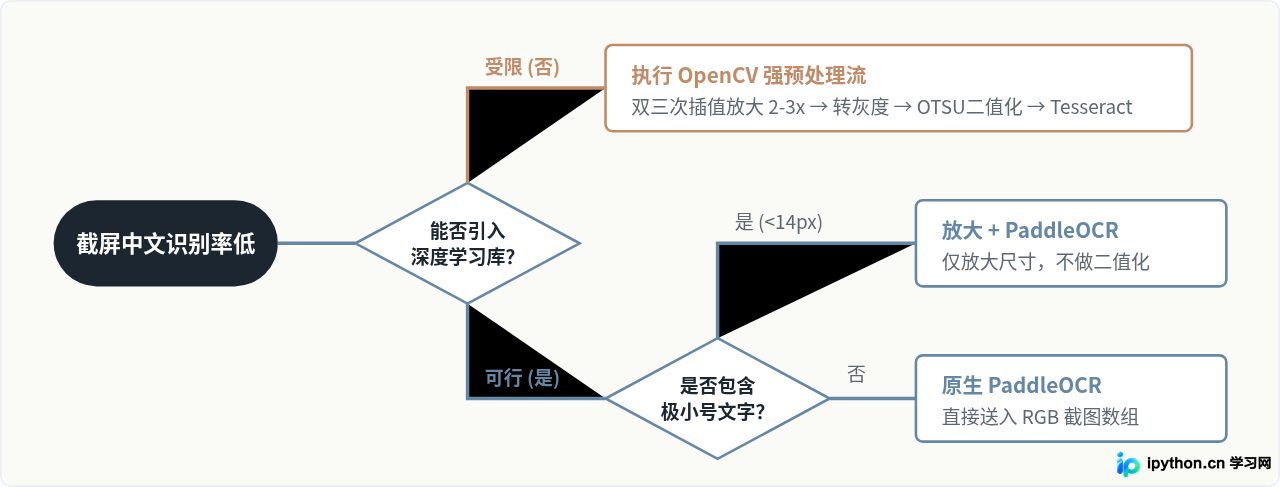
在工程实践中,遇到识别效果不佳时,优先建议将引擎切换至 PaddleOCR;如果受到打包尺寸或环境限制必须坚守轻量环境,则务必建立以“双三次插值放大 + 灰度化 + 自适应二值化”为核心的预处理流水线。针对不同场景匹配最合适的处理手段,就能从根本上解决屏幕截图识别率低的问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















