


Python中的“数组”是什么?list、tuple与array模块的区别

在许多编程语言中,“数组”通常指一段在内存中连续分配、长度固定且存储同一种数据类型的数据结构。而在日常编写 Python 代码时,大家口头上说的“数组”多半是指内置的列表(list)。严格来说,Python 并没有一个名叫 array 的原生保留关键字类型,而是根据不同需求提供了三种内置或标准库形态:灵活通用的 list、不可变的安全集合 tuple,以及专门用于存储紧凑数值的 array 模块。本文将具体厘清这些概念在内存存储、可变性与实际使用场景上的差异。
一、Python 里到底有没有真正的“数组”?
严格按照计算机科学的定义来看,C 或 Java 中的原生数组具备两个硬性特征:存储的数据类型一致、元素在内存中紧凑连续排列。在 Python 中:
- 最常被当作数组用的是
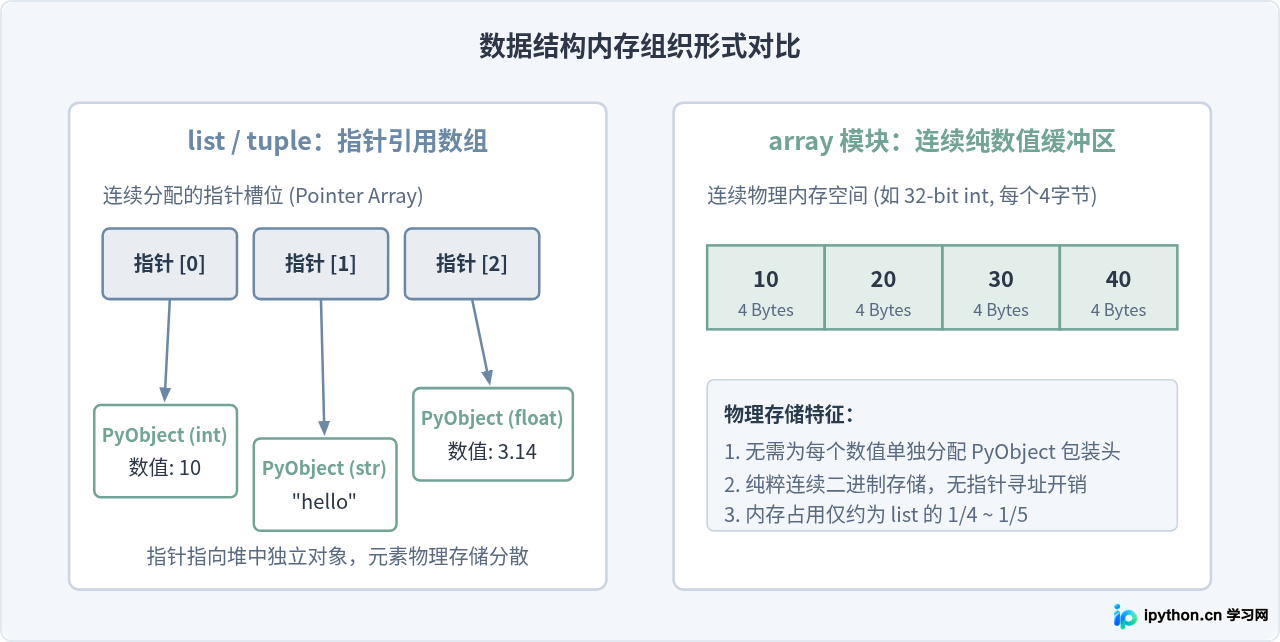
list(列表):它是动态引用数组,内部存储的不是具体数据本身,而是指向各个对象的指针。 tuple(元组):结构与列表类似,同样存储指针,但一旦创建就无法修改长度或替换元素,属于不可变的引用序列。- 标准库
array模块:这是 Python 官方提供的“严格意义上的基础数组”。它要求所有元素必须是同一基础 C 类型(如整型、浮点型),并在内存中连续存储原始字节。
为了直观展现它们在内存管理模式上的本质区别,可以参考下方的对象与内存布局对比:
二、核心角色深入剖析
1. list(列表):最常用的动态引用数组
平时通过方括号 [] 创建的就是列表。列表在 Python 底层(CPython)对应 PyListObject 结构体。它包含两个核心要素:当前元素数量、预分配的指针数组(PyObject**)。
正因为列表中保存的只是指针,它可以容纳任何类型的对象:
# 列表可以混装不同类型
my_list = [100, "文本", 3.14, [1, 2]]
my_list.append(500)       # 动态追加
my_list[0] = 999 # 允许修改现有元素注意内存机制:虽然 list 是动态的,但在增删元素时它会自动进行过量内存分配(Over-allocation),避免每次 append 都向操作系统申请内存。不过,每个元素对应的 Python 整数对象或字符串对象依然分散在堆内存各处,每次遍历都需要指针解引用。
2. tuple(元组):轻量不可变的序列
元组通过圆括号 () 创建。在底层,元组与列表的结构非常接近,但它去除了动态扩容机制,并在解释器层面限制了修改操作:
point = (10, 20)
# point[0] = 30  # 会直接抛出 TypeError: 'tuple' object does not support item assignment
因为不可变,元组具备几个关键优势:
- 内存占用更小:无需预留扩容的空闲指针槽位,大小刚刚容纳已有元素。
- 可用作字典的键:只要元组内部的元素全是可哈希类型,该元组就可以作为
dict的 key 或放入set。 - 数据安全保护:在函数间传递不希望被调用方意外修改的配置参数、坐标值时,元组是首选。
3. array 模块:高效紧凑的基础数据数组
如果你在处理数百万个整数或浮点数,且不需要做复杂的科学矩阵计算,标准库的 array 模块就是最轻量、零依赖的解决方案。它在初始化时必须指定一个类型代码(Type Code),规定该数组存放哪种底层 C 数据类型。
以下是使用标准库 array 的完整操作过程:
import array

# 创建一个存储有符号 32 位整数(类型代码为 'i')的数组
# 常见类型代码:'b'(char), 'h'(short), 'i'(int), 'f'(float), 'd'(double)
numbers = array.array('i', [10, 20, 30, 40])

# 支持大部分类似列表的操作
numbers.append(50)
print(numbers[0])  # 输出示例: 10

# 如果试图插入不符合类型约束的元素,会立即报错
try:
    numbers.append(3.14)
except TypeError as err:
    print(f"类型检查拦截: {err}")
    # 输出示例: 类型检查拦截: 'float' object cannot be interpreted as an integer
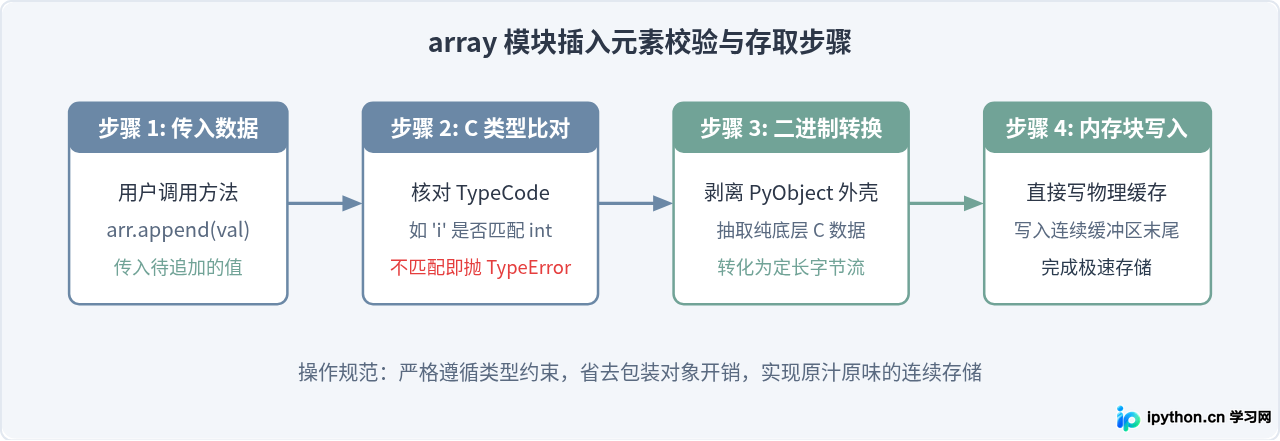
下面这幅流程图展示了在 Python 解释器中向 array.array 插入元素时的校验与存储执行步骤:
三、特性全面对比
了解三者的底层原理后,我们可以从日常开发的实际维度总结它们的区别:
| 特性维度 | list(列表) | tuple(元组) | array 模块 |
|---|---|---|---|
| 语法与引入 | 内置语法 [] |
内置语法 () |
标准库需 import array |
| 元素类型 | 任意对象,可异构混合 | 任意对象,可异构混合 | 同质基础数值(由类型代码限定) |
| 可变性 (Mutable) | 可变(可修改、增删) | 不可变(无法添加或直接修改) | 可变(同类型下可追加、替换) |
| 内存存放方式 | 对象指针的连续数组 | 对象指针的定长连续数组 | 基础数值的直接二进制连续块 |
| 内存占用 | 较大(含多余预留槽与对象头) | 较小(紧凑结构,无空闲槽) | 极小(纯物理数值紧密排布) |
| 字典键支持 | 不可作为 key | 元素均可哈希时可作为 key | 不可作为 key |
四、选型判断:在什么时候用哪一个?
很多开发者会产生疑惑:既然 array 模块省内存,为什么平时很少看到别人用?
原因在于应用生态的平衡。如果数据量只有几千个,list 的内存开销对现代电脑而言几乎可以忽略,而它支持任意类型、语法简单、生态方法极其丰富;如果涉及上百万、上亿个纯数值的科学计算或矩阵运算,Python 开发者通常会直接选用第三方库 numpy.ndarray,因为 NumPy 不仅连续存储,还提供了 C 语言级的多维向量运算支持。因此,内置的 array 模块更适合标准库环境下对大批量数值进行文件读写、网络二进制传输或受限硬件环境。
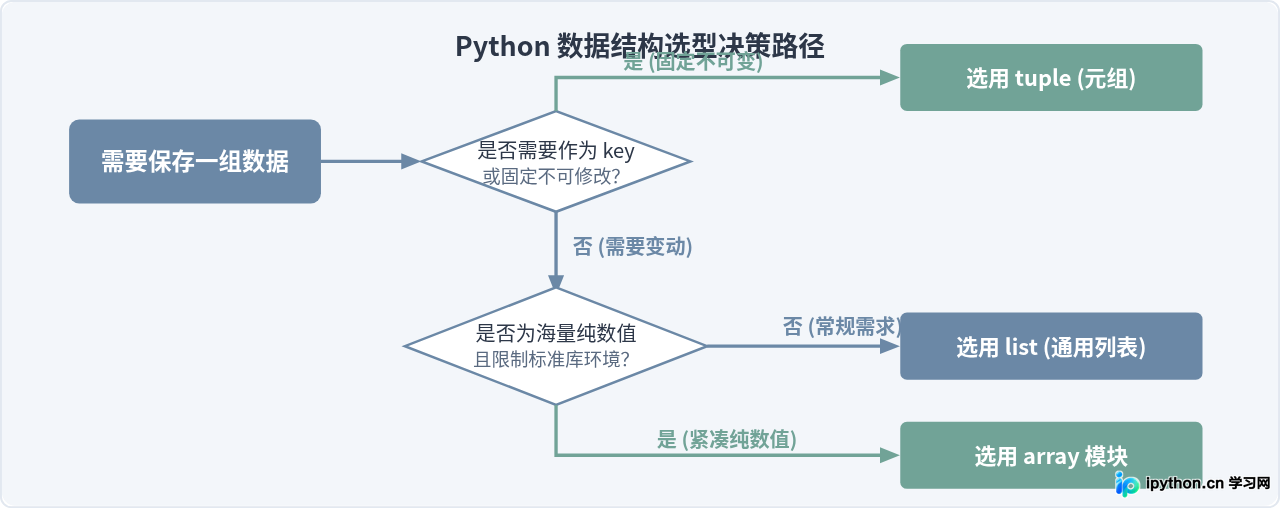
下图展示了面对不同业务需求时的选型决策路径:
五、实际使用中的常见陷阱与注意事项
元组的不可变性仅针对自身包含的指针槽位。如果元组内包含一个列表,例如
t = (1, [2, 3]),虽然你不能给 t[1] 重新赋值指向新列表,但你依然可以通过 t[1].append(4) 修改列表内部的内容。此时该元组是不可哈希的,不能作为字典的键。
与
list 不同,array.array 只能保存一维的一组数据。如果你需要声明二维矩阵(例如 3×3 矩阵),不能在 array 里面继续嵌套 array,这时应当使用嵌套列表,或者直接引入 numpy。
使用
[[0] * 3] * 3 创建所谓“二维数组”时,外部列表存储的是同一个内层列表的 3 个重复指针。修改其中一行会导致所有行同步被修改。推荐使用列表推导式:[[0] * 3 for _ in range(3)]。
六、知识全貌总结
总结来说,Python 中日常说的“数组”是一个泛指的口头表述。在理解 Python 基础时,只需要抓住一个核心:Python 没有关键字形式的数组,只有满足不同底层特性的序列容器。
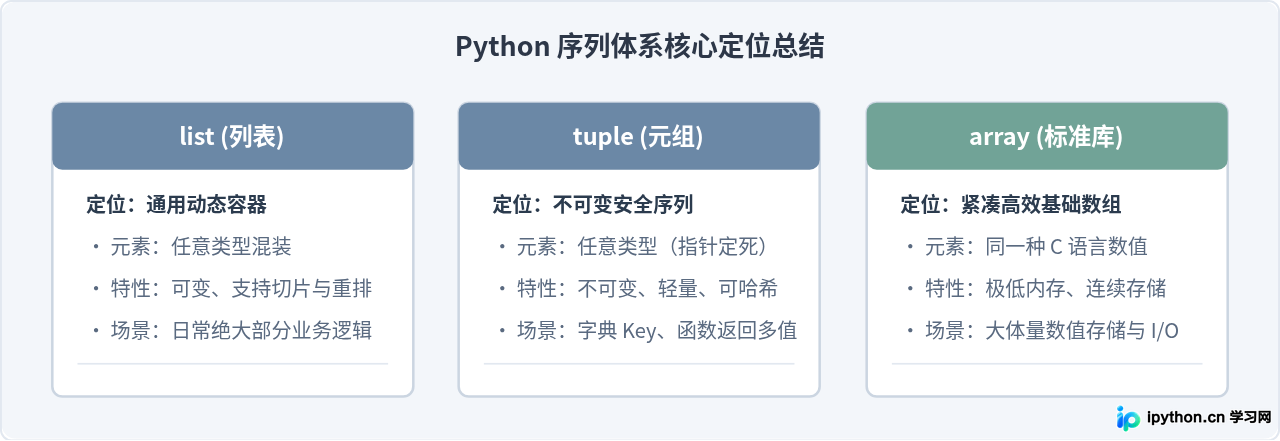
日常写业务代码时,默认选用 list 即可;如果要声明静态配置或充当字典键,选用 tuple;当面临内存瓶颈且限制只能使用标准库存储大量整数或浮点数时,再考虑使用 array 模块。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















