


Python爬虫基础:深入解析HTTP协议结构与工作流程

本文详解HTTP协议在Python爬虫中的核心作用,剖析HTTP请求(请求行、首部、体)与响应(状态码、首部、体)的标准格式,并通过Socket模块模拟真实通信过程,帮助开发者掌握爬虫底层原理。
前言
网络爬虫的核心机制在于模拟浏览器行为以发起HTTP请求,因此深入理解HTTP协议是开发高效爬虫的基石。在招聘网站对爬虫工程师的技能要求中,熟练掌握HTTP协议规范往往是硬性指标,这也意味着学习爬虫必须从掌握HTTP协议开始。
HTTP协议是什么?
互联网上呈现的每一个网页都依赖于HTTP协议。作为客户端(如浏览器)与服务器之间数据通信的标准协议,HTTP明确规定了客户端发送请求的格式以及服务器返回响应的格式,确保了双方交互的规范性。
只要遵循协议规定的请求与响应格式,任何开发者都可以基于HTTP协议构建自己的Web客户端(包括浏览器或爬虫程序)或Web服务器(如Nginx、Apache等常见服务器软件)。
HTTP协议的设计初衷是简单高效。它规定通信必须由客户端主动发起,服务器接收并处理请求后返回响应结果。此外,HTTP是一种无状态协议,这意味着协议本身不会记录客户端的历史请求记录,每次请求都是独立的。
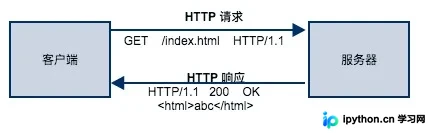
那么,HTTP协议具体是如何定义请求和响应的格式呢?客户端需要遵循何种格式才能正确发起HTTP请求?服务器又应以何种格式返回响应,以便客户端能够正确解析?
HTTP请求
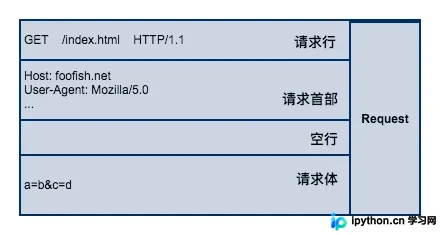
一个标准的HTTP请求由三个部分组成:请求行、请求首部和请求体。其中,首部和请求体是可选部分,并非所有请求都必须包含这两部分内容。
请求行
请求行是HTTP请求中不可或缺的部分,它由三个要素组成:请求方法(method)、请求URL(URI)以及HTTP协议版本,这三者之间以空格分隔。
在HTTP协议中,最常用的请求方法包括GET、POST、PUT和DELETE。其中,GET方法主要用于从服务器获取资源,据统计,约90%的爬虫任务都是基于GET请求来抓取数据的。
请求URL代表了资源所在服务器的路径地址。例如,在相关示例中,客户端旨在获取位于服务器foofish.net根目录(/)下的index.html资源。
请求首部
由于请求行携带的信息量有限,客户端需要向服务器传递的额外信息通常放置在请求首部(Header)中。请求首部用于提供补充信息,例如User-Agent字段用于标识客户端身份,帮助服务器区分请求是来自普通浏览器还是爬虫程序,以及具体使用的是Chrome还是Firefox浏览器。HTTP/1.1标准定义了47种首部字段类型。HTTP首部字段的格式类似于Python中的字典,由键值对组成,键与值之间用冒号分隔。例如:
User-Agent: Mozilla/5.0
当客户端发送请求时,传输的数据(报文)由字符串构成。为了明确区分请求首部的结束和请求体的开始,协议规定使用一个空行作为分隔符。当解析器遇到空行时,即表示首部结束,随后开始解析请求体。
请求体
请求体包含了客户端提交给服务器的实际数据。常见的应用场景包括用户登录时提交的用户名和密码、文件上传时的文件数据,以及注册新用户时提交的表单信息等。
接下来,我们将使用Python提供的最底层API——socket模块,来模拟向服务器发起一个HTTP请求的过程。
with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as s:
 # 1. 与服务器建立连接
 s.connect(("www.seriot.ch", 80))
 # 2. 构建请求行,请求资源是 index.php
 request_line = b"GET /index.php HTTP/1.1"
 # 3. 构建请求首部,指定主机名
 headers = b"Host: seriot.ch"
 # 4. 用空行标记请求首部的结束位置
 blank_line = b"\r\n"

 # 请求行、首部、空行这3部分内容用换行符分隔,组成一个请求报文字符串
 # 发送给服务器
 message = b"\r\n".join([request_line, headers, blank_line])
 s.send(message)

 # 服务器返回的响应内容稍后进行分析
 response = s.recv(1024)
 print(response)
HTTP响应
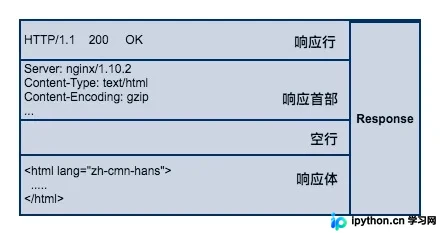
服务器在接收并处理请求后,会将响应内容返回给客户端。与请求类似,响应内容也必须遵循固定的格式,以便浏览器或客户端能够正确解析。HTTP响应同样由三部分组成:响应行、响应首部和响应体,这与HTTP请求的格式是对应的。
响应行
响应行也由三个部分组成:服务端支持的HTTP协议版本号、状态码以及对状态码的简短原因描述。
状态码是响应行中的关键字段,客户端通过状态码可以判断服务器是否正常处理了请求。例如,状态码200表示请求成功处理;500表示服务器在处理请求时出现异常;404表示请求的资源在服务器上未找到。虽然HTTP协议还定义了其他多种状态码,但这部分细节不在本文讨论范围内。
响应首部
响应首部的功能与请求首部类似,主要用于对响应内容进行补充说明。通过响应首部,服务器可以告知客户端响应体的数据类型、响应内容生成的时间、响应体是否经过压缩以及响应体最后一次修改的时间等信息。
响应体
响应体(body)是服务器返回的实际内容,它可以是一个HTML页面、一张图片、一段视频或其他任何格式的数据。
我们继续沿用之前的示例,观察服务器返回的响应结果。由于代码中仅接收了前1024个字节,因此部分响应内容未能显示。
b'HTTP/1.1 200 OK\r\n
Date: Tue, 04 Apr 2017 16:22:35 GMT\r\n
Server: Apache\r\n
Expires: Thu, 19 Nov 1981 08:52:00 GMT\r\n
Set-Cookie: PHPSESSID=66bea0a1f7cb572584745f9ce6984b7e; path=/\r\n
Transfer-Encoding: chunked\r\n
Content-Type: text/html; charset=UTF-8\r\n\r\n118d\r\n

<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Strict//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd">\n\n
<html xmlns="http://www.w3.org/1999/xhtml" xml:lang="en" lang="en">\n
<head>\n\t
 <meta http-equiv="Content-Type" content="text/html;charset=iso-8859-1" /> \n\t
 <meta http-equiv="content-language" content="en" />\n\t
...
</html>
从返回结果来看,其格式完全符合协议规范:第一行为响应行,状态码为200,表明请求成功;第二部分是响应首部信息,包含多个首部字段,如服务器返回响应的时间、Cookie信息等;第三部分则是真正的响应体,即HTML文本。
至此,你应该对HTTP协议有了整体的认识。爬虫行为的本质就是模拟浏览器发送HTTP请求,因此,若想在爬虫领域深入发展,理解HTTP协议是必不可少的基础。
总结
以上就是本文的全部内容,希望这些内容能对你的学习或工作有所帮助。如有任何疑问,欢迎留言交流,感谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















