


Python多进程与多线程性能深度解析:何时该用谁?

本文深入探讨Python中多进程与多线程的性能差异。受GIL限制,多线程在CPU密集型任务中无法真正并行,而多进程可独立利用多核资源。文章通过端口扫描(IO密集)和循环计算(CPU密集)实例验证:IO密集型场景多线程更高效,而CPU密集型场景多进程优势明显,并给出判断依据与代码示例。
Python 3.6
threading和multiprocessing
四核CPU搭配三星250G-850-SSD固态硬盘
在开始使用多进程和多线程进行编程后,我一直对两者的执行速度孰优孰劣感到困惑。网络上普遍观点认为Python多进程更快,主要归因于GIL(全局解释器锁)的存在。然而,在实际编写代码进行测试时,我发现多线程的执行时间反而更短,这背后的原因究竟是什么?近期我正在进行分词工作,原有代码运行速度过慢,急需寻找提速方案,因此希望通过此次探究找到有效的方法(文末附有相关代码及效果对比图)。
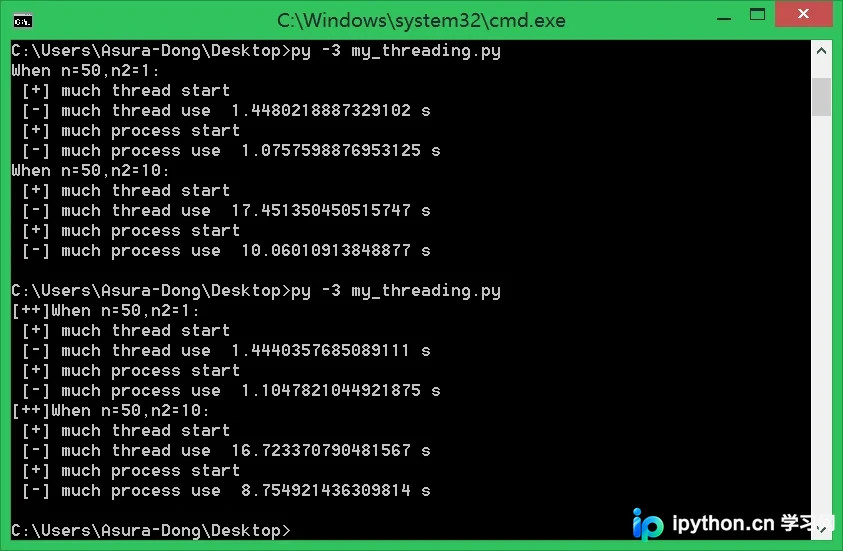
首先展示一张程序运行结果图,直观说明线程与进程在速度上的差异。
基础概念定义
并行(Parallelism)指的是两个或多个事件在同一确切时刻同时发生。并发(Concurrency)则是指两个或多个事件在同一时间间隔内交替发生。
线程是操作系统进行运算调度的最小单位,它被包含在进程内部,是进程中的实际运作单元。一个程序的执行实例即构成一个进程。
实现机制分析
在Python中,多线程执行时必须获取GIL才能执行代码,执行完毕后释放GIL。由于GIL的存在,多线程实际上无法实现真正的并行执行,而是通过时间片轮转实现并发,即多个任务在同一时间间隔内交替执行。
相比之下,每个进程拥有独立的GIL,因此多进程可以实现真正的并行执行。基于此,针对多核CPU架构,理论上采用多进程能更有效地利用硬件资源。
现实场景中的问题
在许多网络教程中,经常可以看到Python多线程的应用案例,例如网络爬虫教程和端口扫描教程。
以端口扫描为例,如果使用多进程来实现上述脚本,会发现多进程的执行速度更快。这似乎与我们之前的理论分析相矛盾,那么究竟该如何解释这一现象?
import sys,threading
from socket import *

host = "127.0.0.1" if len(sys.argv)==1 else sys.argv[1]
portList = [i for i in range(1,1000)]
scanList = []
lock = threading.Lock()
print('Please waiting... From ',host)


def scanPort(port):
  try:
    tcp = socket(AF_INET,SOCK_STREAM)
    tcp.connect((host,port))
  except:
    pass
  else:
    if lock.acquire():
      print('[+]port',port,'open')
      lock.release()
  finally:
    tcp.close()

for p in portList:
  t = threading.Thread(target=scanPort,args=(p,))
  scanList.append(t)
for i in range(len(portList)):
  scanList[i].start()
for i in range(len(portList)):
  scanList[i].join()
性能对比结论
由于Python中锁机制的存在,线程在进行锁竞争和切换时会产生额外的资源消耗。基于此,我们可以大胆推测:
在CPU密集型任务中,多进程的执行速度更快或效果更佳;而在IO密集型任务中,多线程能有效提高执行效率。
请参考以下测试代码:
import time
import threading
import multiprocessing

max_process = 4
max_thread = max_process

def fun(n,n2):
  #cpu密集型
  for i in range(0,n):
    for j in range(0,(int)(n*n*n*n2)):
      t = i*j

def thread_main(n2):
  thread_list = []
  for i in range(0,max_thread):
    t = threading.Thread(target=fun,args=(50,n2))
    thread_list.append(t)

  start = time.time()
  print(' [+] much thread start')
  for i in thread_list:
    i.start()
  for i in thread_list:
    i.join()
  print(' [-] much thread use ',time.time()-start,'s')

def process_main(n2):
  p = multiprocessing.Pool(max_process)
  for i in range(0,max_process):
    p.apply_async(func = fun,args=(50,n2))
  start = time.time()
  print(' [+] much process start')
  p.close()#关闭进程池
  p.join()#等待所有子进程完毕
  print(' [-] much process use ',time.time()-start,'s')

if __name__=='__main__':
  print("[++]When n=50,n2=0.1:")
  thread_main(0.1)
  process_main(0.1)
  print("[++]When n=50,n2=1:")
  thread_main(1)
  process_main(1)
  print("[++]When n=50,n2=10:")
  thread_main(10)
  process_main(10)
测试结果如下:
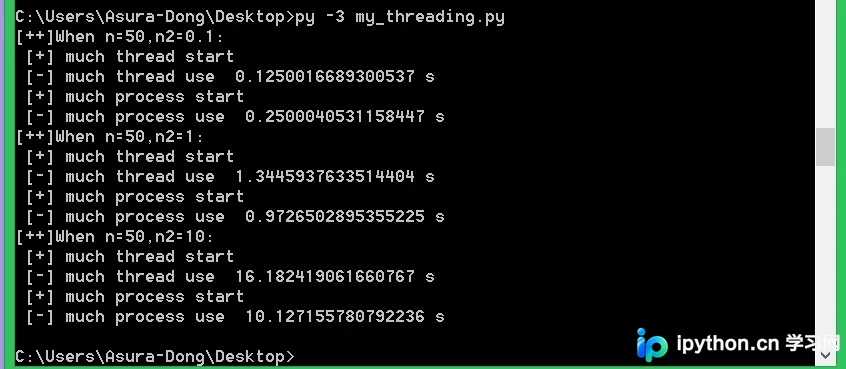
从结果可以看出,随着CPU使用率的提高(即代码中循环次数增加),多进程与多线程之间的性能差距越来越大。这验证了我们的猜想。
CPU密集型与IO密集型任务区分
1、CPU密集型代码:主要涉及各种循环处理、数值计算等场景。
2、IO密集型代码:主要涉及文件处理、网络请求(如网络爬虫)等场景。
判断任务类型的方法:
1、直接观察CPU占用率以及硬盘IO读写速度。
2、若计算量较大,属于CPU密集型;若等待时间较多(如网络爬虫中的网络延迟),属于IO密集型。
3、建议自行查阅相关资料进一步确认。
以上关于Python多进程和多线程性能对比的详解内容就是小编分享给大家的全部信息,希望能对大家有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















