


Python实现WebRTC语音端点检测:从原理到代码实战

本文详解利用Python及webrtcvad库实现语音端点检测(VAD)的方法。文章介绍了语音处理系统中ASR、NLU、TTS的流程,重点分析本地音频采集中的降噪、回声消除及VAD技术。通过对比唤醒词方案,展示了基于WebRTC VAD的纯语音起始与结束判定逻辑,并提供了完整的Python代码示例及运行方式,适合希望优化语音交互体验的开发者参考。
引言
语音端点检测(VAD)最初应用于电话传输和检测系统,旨在优化通信信道的时间分配,从而提升传输线路的利用效率。作为语音处理系统的前端环节,VAD在语音检测领域具有至关重要的地位。
然而,当前的语音端点检测技术,尤其是针对人声开始和结束时刻的精准判定,依然是行业内的技术难点。目前,多数公司处于“能够判断,但无法保证高判别准确率”的阶段。
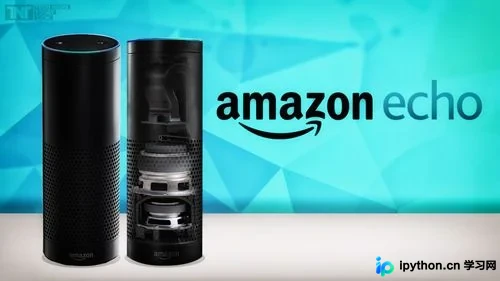
随着基于云端语义库的聊天机器人层出不穷,其中最为著名的代表当属亚马逊的Alexa/Echo智能音箱。
国内市场上也涌现出大量搭载语音聊天功能的智能音箱(如近期在知乎等平台推广的若琪机器人)及各类智能机器人产品。国内语音服务提供商主要聚焦于中文语音服务。由于语音不像图像拥有分辨率等客观指标,很多时候依赖主观判断,因此难以客观评估各家语音识别和合成技术的优劣。不过,个人认为国内中文语音服务在某些方面已具备超越国外英文语音服务的趋势。
通常搭建机器人聊天系统主要包含以下三个核心方面:
- 语音转文字(ASR/STT)
- 语义内容处理(NLU/NLP)
- 文字转语音(TTS)
语音转文字(ASR/STT)
在将语音数据发送至云端API之前,本地前端需要进行语音采集,这部分工作主要涵盖以下几个方面:
- 麦克风降噪
- 声源定位
- 回声消除
- 唤醒词识别
- 语音端点检测
- 音频格式压缩
Python端点检测实现
在实际应用中,单纯依靠能量检测特征等方法很难准确判断人声说话的起始点,因此市面上大多数语音产品采用唤醒词来判定语音起始。此外,结合声音回路还可实现语音打断功能。这种交互方式虽然有效,但每次必须喊出“唤醒词”才能继续聊天,长期使用可能会让人感到不便甚至疲惫。目前GitHub上有snowboy等唤醒词开源库,用户可登录snowboy官网训练自定义的唤醒词模型。
- Kitt-AI : Snowboy
- Sensory : Sensory
考虑到频繁使用唤醒词可能带来交互疲劳,本文大致调研了Python丰富的库资源,通过直接import即可使用。这种方式虽然容易受到强噪声干扰,但适合个人用户在家庭环境中尝试使用。
- pyaudio:通过命令 `pip install pyaudio` 安装,可从设备节点读取原始音频流数据,音频编码格式为PCM。
- webrtcvad:通过命令 `pip install webrtcvad` 安装,用于检测判断一组语音数据是否为空语音(即是否包含有效语音活动)。
当检测到持续时间长度 T1 内,VAD检测均显示有语音活动时,可判定为语音起始。
当检测到持续时间长度 T2 内,VAD检测均显示无语音活动时,可判定为语音结束。
完整程序代码可从我的GitHub仓库下载。
程序逻辑简单,相信读者稍作阅读即可理解。
'''
Requirements:
+ pyaudio - `pip install pyaudio`
+ py-webrtcvad - `pip install webrtcvad`
'''
import webrtcvad
import collections
import sys
import signal
import pyaudio

from array import array
from struct import pack
import wave
import time

FORMAT = pyaudio.paInt16
CHANNELS = 1
RATE = 16000
CHUNK_DURATION_MS = 30    # supports 10, 20 and 30 (ms)
PADDING_DURATION_MS = 1500  # 1 sec jugement
CHUNK_SIZE = int(RATE CHUNK_DURATION_MS / 1000) # chunk to read
CHUNK_BYTES = CHUNK_SIZE 2 # 16bit = 2 bytes, PCM
NUM_PADDING_CHUNKS = int(PADDING_DURATION_MS / CHUNK_DURATION_MS)
# NUM_WINDOW_CHUNKS = int(240 / CHUNK_DURATION_MS)
NUM_WINDOW_CHUNKS = int(400 / CHUNK_DURATION_MS) # 400 ms/ 30ms ge
NUM_WINDOW_CHUNKS_END = NUM_WINDOW_CHUNKS 2

START_OFFSET = int(NUM_WINDOW_CHUNKS CHUNK_DURATION_MS 0.5 RATE)

vad = webrtcvad.Vad(1)

pa = pyaudio.PyAudio()
stream = pa.open(format=FORMAT,
         channels=CHANNELS,
         rate=RATE,
         input=True,
         start=False,
         # input_device_index=2,
         frames_per_buffer=CHUNK_SIZE)


got_a_sentence = False
leave = False


def handle_int(sig, chunk):
  global leave, got_a_sentence
  leave = True
  got_a_sentence = True


def record_to_file(path, data, sample_width):
  "Records from the microphone and outputs the resulting data to 'path'"
  # sample_width, data = record()
  data = pack('<' + ('h' len(data)), data)
  wf = wave.open(path, 'wb')
  wf.setnchannels(1)
  wf.setsampwidth(sample_width)
  wf.setframerate(RATE)
  wf.writeframes(data)
  wf.close()


def normalize(snd_data):
  "Average the volume out"
  MAXIMUM = 32767 # 16384
  times = float(MAXIMUM) / max(abs(i) for i in snd_data)
  r = array('h')
  for i in snd_data:
    r.append(int(i times))
  return r

signal.signal(signal.SIGINT, handle_int)

while not leave:
  ring_buffer = collections.deque(maxlen=NUM_PADDING_CHUNKS)
  triggered = False
  voiced_frames = []
  ring_buffer_flags = [0] NUM_WINDOW_CHUNKS
  ring_buffer_index = 0

  ring_buffer_flags_end = [0] NUM_WINDOW_CHUNKS_END
  ring_buffer_index_end = 0
  buffer_in = ''
  # WangS
  raw_data = array('h')
  index = 0
  start_point = 0
  StartTime = time.time()
  print(" recording: ")
  stream.start_stream()

  while not got_a_sentence and not leave:
    chunk = stream.read(CHUNK_SIZE)
    # add WangS
    raw_data.extend(array('h', chunk))
    index += CHUNK_SIZE
    TimeUse = time.time() - StartTime

    active = vad.is_speech(chunk, RATE)

    sys.stdout.write('1' if active else '_')
    ring_buffer_flags[ring_buffer_index] = 1 if active else 0
    ring_buffer_index += 1
    ring_buffer_index %= NUM_WINDOW_CHUNKS

    ring_buffer_flags_end[ring_buffer_index_end] = 1 if active else 0
    ring_buffer_index_end += 1
    ring_buffer_index_end %= NUM_WINDOW_CHUNKS_END

    # start point detection
    if not triggered:
      ring_buffer.append(chunk)
      num_voiced = sum(ring_buffer_flags)
      if num_voiced > 0.8 NUM_WINDOW_CHUNKS:
        sys.stdout.write(' Open ')
        triggered = True
        start_point = index - CHUNK_SIZE 20 # start point
        # voiced_frames.extend(ring_buffer)
        ring_buffer.clear()
    # end point detection
    else:
      # voiced_frames.append(chunk)
      ring_buffer.append(chunk)
      num_unvoiced = NUM_WINDOW_CHUNKS_END - sum(ring_buffer_flags_end)
      if num_unvoiced > 0.90 NUM_WINDOW_CHUNKS_END or TimeUse > 10:
        sys.stdout.write(' Close ')
        triggered = False
        got_a_sentence = True

    sys.stdout.flush()

  sys.stdout.write('\n')
  # data = b''.join(voiced_frames)

  stream.stop_stream()
  print(" done recording")
  got_a_sentence = False

  # write to file
  raw_data.reverse()
  for index in range(start_point):
    raw_data.pop()
  raw_data.reverse()
  raw_data = normalize(raw_data)
  record_to_file("recording.wav", raw_data, 2)
  leave = True

stream.close()
程序运行方式:`sudo python vad.py`
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















