


Python实现Pairwise结对测试用例生成算法详解

本文介绍如何使用Python实现Pairwise(结对)算法以优化多参数测试用例组织。相比正交分析法产生的全量笛卡尔积组合,Pairwise通过覆盖所有两两参数交互,大幅减少测试用例数量。文章详细解析算法逻辑、Python代码实现及核心循环机制,帮助测试人员平衡覆盖率与执行成本。
开篇:
在多参数多值的测试场景中,以往常采用【正交分析法】来组织测试用例。其核心逻辑是将每个参数的所有取值与其他参数的所有取值进行全量组合,在Python中可通过itertools模块的product方法(即笛卡尔积法)来实现。
正交分析法的优势在于测试用例覆盖率达到100%,但其显著缺点是生成的用例数量庞大,导致执行测试时消耗大量人工成本。
Pairwise(结对)算法是对传统正交分析法的优化产物,其理论基础源自数学统计。由于直接阅读数学统计领域的学术论文存在难度,这里通过网上通俗易懂的解释来阐述其基本含义。
网络上常见的示例多使用【操作系统、浏览器、语言环境】这三个维度,本文也沿用相同的示例进行说明:
操作系统维度包含:W(Windows)、L(Linux)、Mac(Mac);浏览器维度包含:M(Firefox)、O(Opera)、IE;语言环境维度包含:C(中文)、E(英文)。
若采用正交分析法,将产生3×3×2=18种组合方式,从而实现100%的测试用例覆盖。
而Pairwise结对测试用例组织法可将组合压缩至9种。其优点在于测试用例数量显著减少,缺点则是必然存在一定程度的漏测风险。
引论:
Pairwise算法的核心理念
1、在一组由3个参数值组成的测试用例(如[W,M,C])中,任意两个元素进行两两组合,共有3种组合方式(考虑位置关系为[W,M]、[W,C]、[M,C]);
2、若第一组测试用例生成的3种组合方式,需遵循特定对比原则:[W,M]仅与其他组的第一个元素对比,[W,C]仅与其他组的第二个元素对比,依此类推;
若[W,M]、[W,C]、[M,C]这三个元素分别出现在其他有效组且位置相同的元素中,则判定当前这一组Case为冗余Case,应予删除。
名词解释:【有效组】指未被删除且尚未参与对比的组。例如:若第1、3组被删除,则第4组需对比的有效组为第2、5、6、7...18组。在处理有效组概念时容易踩坑,需特别注意。
3、最终获得的测试用例集合,即为Pairwise算法计算出的最优测试用例集。
相关学术背景简述
Pairwise概念由美国心理统计学家L. L. Thurstone(1887年5月29日–1955年9月30日)于1927年首次提出。该算法基于数学统计理论,并针对传统正交分析法进行了优化。
Pairwise算法基于以下两个假设:
(1)每个维度都是正交的,即各维度之间相互独立,没有交集。
(2)根据数学统计分析,73%的缺陷由单因子(占35%)或双因子相互作用(占38%)产生,另有19%的缺陷由3个因子相互作用产生。
因此,Pairwise算法旨在通过覆盖所有2因子交互作用来生成测试用例集合,从而获得最高的性价比。
正文
一、思路
针对测试场景,从输入被测条件到产出Pairwise测试用例的Python编程思路如下:
1、将allparams=[['M','O','P'],['W','L','I'],['C','E']]进行笛卡尔积全组合处理,生成正交分析法产生的全量测试用例集合的一维数组(长度为N);
2、对全量测试用例中的每个用例进行两两组合分解处理,生成与全量测试用例集合长度相同的二维数组(一维长度为N);
3、使用Python实现的Pairwise算法剔除无效测试用例,最终得到有效的结对测试用例集合;
代码中的第1、2函数利用Python自带的数学计算库itertools编写,第3函数为作者独立编写的核心算法代码。
二、直接上代码
# -*- coding: utf-8 -*-
from datetime import *
import random,os,copy,time
import logging
import itertools
'''
#Author:Kuzaman
#Time:2017-07-18
'''
class utils2 :
 #1、笛卡尔积 对参数分组全排列
 def product(self,tuple1):
  newlist=[]
  for x in eval('itertools.product'+str(tuple(tuple1))):
   newlist.append(x)
  return newlist

 #2、对笛卡尔积处理后的二维原始数据进行N配对处理,得到Pairwise计算之前的数据
 def get_pairslist(self,lista):
  pwlist = []
  for i in lista:
   subtemplist = []
   for sublista in itertools.combinations(i, 2):
    subtemplist.append(sublista)
   pwlist.append(subtemplist)
  return pwlist

 #3、进行Pirwise算法计算
 def pairwise(self,listb):
  sublistlen = len(listb[1])
  flag = [0]*sublistlen
  templistb = copy.deepcopy(listb)
  delmenu = []
  holdmenu=[]
  self.pprint (listb)
  print ('--'*25)
  for lb in listb:
   for sublb in lb:
    for k in templistb:
     Xa = lb.index(sublb)
     Ya = listb.index(lb)
     if k != lb and sublb == k[Xa]:
      # print (sublb,'===>' ,k[Xa],'相等了。。。')
      flag[Xa] = 1
      break
     else:
      # print (sublb,'===>' ,k[Xa],'不不不等了。。。')
      flag[Xa] = 0
   # print ('下标%d,子元素 %s 双匹配对比结果flag:%s'%(listb.index(lb),lb,flag))
   if 0 not in flag:
    num = listb.index(lb)
    delmenu.append(num)
    templistb.remove(lb)
    # print ('下标为%d行应删除,内容=%s,'%(num,lb))
    # print ('delmenu:',delmenu)
   else:
    num2 = listb.index(lb)
    holdmenu.append(num2)
    # print ('下标为%d行应保留,内容=%s,'%(num2,lb))
    # print('holdmenu=',holdmenu)
   # print ('***'*20)
  print ('保留元素列表:%s \n匹配重复元素列表:%s'%(holdmenu,delmenu))
  return templistb

 def pwresult(self,slist,delmenu):
  for x in delmenu:
   slist.remove(slist[x])
  return slist

 def pprint(self,list):
  for i in list:
   print ('line %d:'%(list.index(i)+1),i)

if __name__ == '__main__':
 u2 = utils2()
 allparams=[['M','O','P'],['W','L','I'],['C','E']]#,'K'],[1,2,3],['Yes','No']]
 str = u2.product(allparams)
 strpc = u2.get_pairslist(str)
 finallist = u2.pairwise(strpc)
 print('最终保留测试用例个数:%d 个'%(len(finallist)))
 u2.pprint(finallist)
代码解读:
第三层for循环(代码第39~48行)主要进行垂直判断,检查待检测元素与相同位置的元素是否存在重复;
第二层for循环(代码第38~48行)将一组测试用例中的两两配对,从左至右分别与同位置的元素进行对比;
第一层for循环(代码第37~48行)用于遍历每一组测试用例。
代码第50~58行判断一组用例的两两配对在其他组同位置上从上到下是否都能找到相同元素,若满足条件,则将改无效Case从templistb中删除,以保持templistb的有效性。
执行结果:
line 1: [('M', 'W'), ('M', 'C'), ('W', 'C')]  <---第二个函数get_pairslist(self,lista)处理后的两两配对组合
line 2: [('M', 'W'), ('M', 'E'), ('W', 'E')]  <---同第一行解释
line 3: [('M', 'L'), ('M', 'C'), ('L', 'C')]
line 4: [('M', 'L'), ('M', 'E'), ('L', 'E')]
line 5: [('M', 'I'), ('M', 'C'), ('I', 'C')]
line 6: [('M', 'I'), ('M', 'E'), ('I', 'E')]
line 7: [('O', 'W'), ('O', 'C'), ('W', 'C')]
line 8: [('O', 'W'), ('O', 'E'), ('W', 'E')]
line 9: [('O', 'L'), ('O', 'C'), ('L', 'C')]
line 10: [('O', 'L'), ('O', 'E'), ('L', 'E')]
line 11: [('O', 'I'), ('O', 'C'), ('I', 'C')]
line 12: [('O', 'I'), ('O', 'E'), ('I', 'E')]
line 13: [('P', 'W'), ('P', 'C'), ('W', 'C')]
line 14: [('P', 'W'), ('P', 'E'), ('W', 'E')]
line 15: [('P', 'L'), ('P', 'C'), ('L', 'C')]
line 16: [('P', 'L'), ('P', 'E'), ('L', 'E')]
line 17: [('P', 'I'), ('P', 'C'), ('I', 'C')]
line 18: [('P', 'I'), ('P', 'E'), ('I', 'E')]  <----同第一行解释
--------------------------------------------------
保留元素列表:[1, 3, 4, 7, 9, 10, 12, 14, 17]  <----有效用例在数组中下标
匹配重复元素列表:[0, 2, 5, 6, 8, 11, 13, 15, 16]  <----被剔除的无效测试用例在数组中下标
最终保留测试用例个数:9 个
line 1: [('M', 'W'), ('M', 'E'), ('W', 'E')]
line 2: [('M', 'L'), ('M', 'E'), ('L', 'E')]
line 3: [('M', 'I'), ('M', 'C'), ('I', 'C')]
line 4: [('O', 'W'), ('O', 'E'), ('W', 'E')]
line 5: [('O', 'L'), ('O', 'E'), ('L', 'E')]
line 6: [('O', 'I'), ('O', 'C'), ('I', 'C')]
line 7: [('P', 'W'), ('P', 'C'), ('W', 'C')]
line 8: [('P', 'L'), ('P', 'C'), ('L', 'C')]
line 9: [('P', 'I'), ('P', 'E'), ('I', 'E')]
[Finished in 0.2s]
三、代码核心内容白话解释
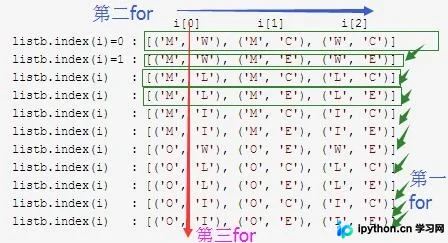
pairwise(self,listb)函数包含3层for循环,先构建一个二维数组模型:
i[0]  i[1]  i[2]
listb.index(i)=0 : [('M', 'W'), ('M', 'C'), ('W', 'C')]
listb.index(i)=1 : [('M', 'W'), ('M', 'E'), ('W', 'E')]
listb.index(i) : [('M', 'L'), ('M', 'C'), ('L', 'C')]
listb.index(i) : [('M', 'L'), ('M', 'E'), ('L', 'E')]
listb.index(i) : [('M', 'I'), ('M', 'C'), ('I', 'C')]
listb.index(i) : [('M', 'I'), ('M', 'E'), ('I', 'E')]
listb.index(i) : [('O', 'W'), ('O', 'E'), ('W', 'E')]
listb.index(i) : [('O', 'L'), ('O', 'C'), ('L', 'C')]
listb.index(i) : [('O', 'L'), ('O', 'E'), ('L', 'E')]
listb.index(i) : [('O', 'I'), ('O', 'C'), ('I', 'C')]
listb.index(i)=n : [('O', 'I'), ('O', 'E'), ('I', 'E')]
二维列表listb中,行(横排)从上到下对应第一层for循环;每一行中的i[0],i[1],i[2]对应第二层for循环从左至右;第三次for循环则是元素i[x]从上之下与有效组templistb同位置元素的对比过程。
1、第n行的i[0]需与有效templistb的其他行的i[0]元素进行对比(第三层for),若存在相等值,则记录标识flag1=True,若无相等值则记录flag1=False;
2、当第二层for中的i[0],i[1],i[2]均完成对比后,得到[flag1,flag2,flag3]数组,若所有flag均为True,则该行为无效用例;
3、第一层for遍历全部组合,最终得到保留下来的有效templistb。
见图:
完结篇
以上为作者编写的Pairwise算法全部内容,该算法共耗时3天完成:
第一天用于确定算法原理,查阅大量学术文献但未完全理解;
第二天开始编写程序,嵌套循环的设计耗费了较长时间;
第三天程序成型并得出执行结果,发现与参考文章结论存在差异,随后重新仔细研读参考文章,发现之前思路有误。最终推翻代码,按正确思路用1小时完成最终结果。
作者并非专业测试开发人员,编写代码较为吃力,这印证了“设计占70%,编码占30%”的道理。若基础较差且逻辑混乱,只能依靠时间堆砌。
希望本文对需要组织测试用例,或在自动化测试中涉及用例组织的同行有所帮助。
这篇高效测试用例组织算法pairwise之Python实现方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















