


Python实现CSDN自动登录及文章列表抓取实战

本文详解使用Python登录CSDN并抓取博客文章列表的完整流程。通过Fiddler分析登录接口,解决参数错误、JS跳转及正则匹配等常见问题,提供可直接运行的代码实例,帮助开发者掌握Web自动登录与数据抓取技巧。
分析登录过程
近期在研究百度登录与贴吧签到机制时,发现百度作为互联网巨头,其登录流程设计极为复杂,令人困惑。经过数日研究仍未完全理清,因此决定先从一个相对简单的目标入手,即选择CSDN作为突破口。
整个流程较为直观,此处省略截图步骤。实际操作中,打开浏览器并启动Fiddler进行抓包,随后执行CSDN登录操作。Fiddler捕获到浏览器向https://passport.csdn.net/account/login?ref=toolbar发送的POST请求,该请求携带了未加密的登录表单数据。尽管CSDN全站启用了HTTPS,保障了基本的安全性,但表单内容本身是明文传输的。
请求体包含username(用户名)和password(密码)等字段。
username=XXXXX&password=XXXXXX&rememberMe=true<=LT-461600-wEKpWAqbfZoULXmFmDIulKPbL44hAu&execution=e4s1&_eventId=submit
关于lt参数的作用,起初并不明确,但在页面源码中直接可见,该参数包含在表单内部。CSDN在代码注释中也提供了相关说明,使得参数结构一目了然。此外,若访问百度首页,浏览器日志中还会显示百度的招聘信息链接。
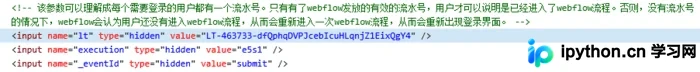
HTML截图
登录代码
掌握上述信息后,即可实现登录功能。以下直接展示代码实现,并重点说明在开发过程中遇到的几个典型问题。
第一个坑在于参数错误。虽然逻辑正确,但在复制粘贴代码时,未修改登录表单中的参数名,导致三个参数均被错误地命名为lt,从而返回错误页面。起初误以为是缺少请求头,经过长时间排查无果,最终通过Fiddler反复调试才定位到该参数命名错误。
第二个问题是CSDN的跳转机制较为隐蔽。由于浏览器内置JS引擎,从输入网址到页面加载的过程并非单一请求。中间可能涉及JS代码跳转至中间页面,最终才重定向至目标页面。代码中的_validate_redirect_url(self)函数即用于处理此逻辑:首次登录请求返回的页面包含JS重定向代码,需提取该重定向网址并再次发起请求,直至获得200 OK状态码,后续请求才能获取实际页面内容。
第三个问题涉及正则表达式对页面空格的匹配。获取文章列表前需知晓文章总数,通常页面显示类似“100条共20页”的格式。最初使用的正则表达式(\d+)条共(\d+)页未能匹配成功,经检查发现“条”与“共”之间是两个空格而非一个。解决此问题的方法是将正则修改为(\d+)条\s*共(\d+)页,利用\s*匹配任意数量的空白字符,从而避免因空格数量不确定导致的匹配失败。
import requests
from bs4 import BeautifulSoup
import re
import urllib.parse as parse


class CsdnHelper:
  """登录CSDN和列出所有文章的类"""
  csdn_login_url = 'https://passport.csdn.net/account/login?ref=toolbar'
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36',
  }
  blog_url = 'http://write.blog.csdn.net/postlist/'

  def __init__(self):
    self._session = requests.session()
    self._session.headers = CsdnHelper.headers

  def login(self, username, password):
    '''登录主函数'''
    form_data = self._prepare_login_form_data(username, password)
    response = self._session.post(CsdnHelper.csdn_login_url, data=form_data)
    if 'UserNick' in response.cookies:
      nick = response.cookies['UserNick']
      print(parse.unquote(nick))
    else:
      raise Exception('登录失败')

  def _prepare_login_form_data(self, username, password):
    '''从页面获取参数,准备提交表单'''
    response = self._session.get(CsdnHelper.csdn_login_url)
    login_page = BeautifulSoup(response.text, 'lxml')
    login_form = login_page.find('form', id='fm1')

    lt = login_form.find('input', attrs={'name': 'lt'})['value']
    execution = login_form.find('input', attrs={'name': 'execution'})['value']
    eventId = login_form.find('input', attrs={'name': '_eventId'})['value']
    form = {
      'username': username,
      'password': password,
      'lt': lt,
      'execution': execution,
      '_eventId': eventId
    }

    return form

  def _get_blog_count(self):
    '''获取文章数和页数'''
    self._validate_redirect_url()
    response = self._session.get(CsdnHelper.blog_url)
    blog_page = BeautifulSoup(response.text, 'lxml')
    span = blog_page.find('div', class_='page_nav').span
    print(span.string)
    pattern = re.compile(r'(\d+)条\s*共(\d+)页')
    result = pattern.findall(span.string)
    blog_count = int(result[0][0])
    page_count = int(result[0][1])
    return (blog_count, page_count)

  def _validate_redirect_url(self):
    '''验证重定向网页'''
    response = self._session.get(CsdnHelper.blog_url)
    redirect_url = re.findall(r'var redirect = "(\S+)";', response.text)[0]
    self._session.get(redirect_url)

  def print_blogs(self):
    '''输出文章信息'''
    blog_count, page_count = self._get_blog_count()
    for index in range(1, page_count + 1):
      url = f'http://write.blog.csdn.net/postlist/0/0/enabled/{index}'
      response = self._session.get(url)
      page = BeautifulSoup(response.text, 'lxml')
      links = page.find_all('a', href=re.compile(r'http://blog.csdn.net/u011054333/article/details/(\d+)'))
      print(f'----------第{index}页----------')
      for link in links:
        blog_name = link.string
        blog_url = link['href']
        print(f'文章名称:《{blog_name}》 文章链接:{blog_url}')


if __name__ == '__main__':
  csdn_helper = CsdnHelper()
  username = input("请输入用户名")
  password = input("请输入密码")
  csdn_helper.login(username, password)
  csdn_helper.print_blogs()
登录过程是后续操作的基础。成功登录后,可进一步开发备份工具,将CSDN博客的所有文章及图片下载至本地。有兴趣的读者可尝试实现该功能。
总结
本文介绍了使用Python登录CSDN并获取博客文章列表的完整代码实例,希望能为读者提供帮助。欢迎感兴趣的朋友继续查阅本站其他相关专题,如有不足之处,敬请留言指正。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















