


Python3爬虫实战:深入解析Ajax技术原理与应用

本文深入解析Python3爬虫中Ajax技术的应用。通过微博下拉刷新实例,阐述Ajax异步加载数据的原理,包括发送请求、解析内容及渲染网页三个核心步骤。重点介绍JavaScript中XMLHttpRequest对象的实现机制,并指导如何利用Python模拟Ajax请求以获取动态数据,为高效抓取网页内容提供技术支撑。
Ajax技术概述与核心价值
Ajax,全称为Asynchronous JavaScript and XML(异步JavaScript和XML)。它并非一门独立的编程语言,而是一项利用JavaScript技术,在保持页面不刷新、链接不跳转的前提下,与服务器进行数据交换并局部更新网页内容的技术。
传统网页在更新内容时通常需要刷新整个页面,而Ajax技术允许在不刷新整页的情况下更新部分内容。其核心机制是在后台与服务器进行数据交互,获取数据后利用JavaScript动态修改网页,从而实现内容的局部更新。
如需直观体验Ajax效果,可访问W3School的相关示例:http://www.w3school.com.cn/ajax/ajax_xmlhttprequest_send.asp。
Ajax在网页加载中的实际应用
1. 实例引入
浏览网页时,常遇到“下滑查看更多”的功能。以微博个人主页(https://m.weibo.cn/u/2830678474)为例,进入微博页面并持续下滑,当加载完若干条微博后,会出现加载动画,随后新内容自动出现在下方。这一过程即为Ajax加载,如图6-1所示。
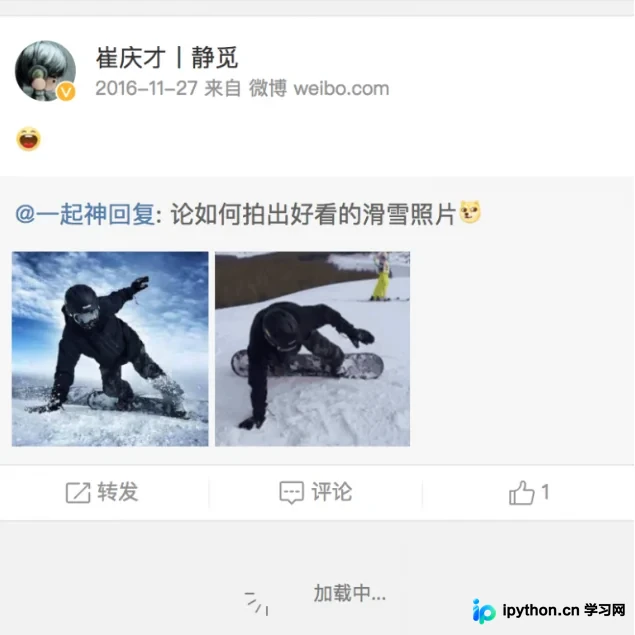
在此过程中,页面链接未发生变化,整页也未刷新,但网页内容增加了新微博。这正是通过Ajax获取新数据并呈现的典型过程。
Ajax工作原理与实现流程
2. 基本原理
了解Ajax的基本原理,需明确从发送请求到网页更新的流程,主要包含以下3个步骤:
(1) 发送请求; (2) 解析内容; (3) 渲染网页。
接下来将分别详细介绍这三个过程的具体实现。
发送请求:XMLHttpRequest对象的使用
发送请求
Ajax由JavaScript实现,其底层执行代码大致如下:
var xmlhttp;
if (window.XMLHttpRequest) {
    // code for IE7+, Firefox, Chrome, Opera, Safari
    xmlhttp=new XMLHttpRequest();
} else {// code for IE6, IE5
    xmlhttp=new ActiveXObject("Microsoft.XMLHTTP");
}
xmlhttp.onreadystatechange=function() {
    if (xmlhttp.readyState==4 && xmlhttp.status==200) {
        document.getElementById("myDiv").innerHTML=xmlhttp.responseText;
    }
}
xmlhttp.open("POST","/ajax/",true);
xmlhttp.send();
上述代码展示了Ajax最底层的实现方式:首先创建XMLHttpRequest对象,通过onreadystatechange属性设置监听器,随后调用open()和send()方法向指定链接(服务器)发送请求。此前在Python中我们直接获取响应结果,而在Ajax中,请求由JavaScript发起。由于设置了监听,服务器返回响应时,onreadystatechange对应的方法会被触发,进而在该方法中解析响应内容。
解析内容:响应数据的处理
解析内容
当服务器返回响应后,onreadystatechange属性对应的方法被触发。此时,通过xmlhttp的responseText属性即可获取响应内容。这与Python中使用requests库发起请求并获取响应的过程类似。返回的内容可能是HTML或JSON格式,需在方法中使用JavaScript进一步处理。例如,若为JSON格式,则需进行解析和转换。
渲染网页:DOM操作与内容更新
渲染网页
JavaScript具备修改网页内容的能力。在解析响应内容后,可调用JavaScript对解析后的内容进行处理,从而更新网页显示。例如,通过document.getElementById().innerHTML操作,可以更改特定元素内的源代码,进而改变网页显示内容。这种操作被称为DOM操作(对Document网页文档进行操作),包括更改、删除等。
在上例中,代码document.getElementById("myDiv").innerHTML=xmlhttp.responseText将ID为myDiv的节点内部HTML代码替换为服务器返回的内容,从而使myDiv元素展示新数据,实现网页部分内容的局部更新。
上述三个步骤均由JavaScript完成,涵盖了从请求发送、内容解析到网页渲染的全过程。
回顾微博下拉刷新的过程,实质上是JavaScript向服务器发送Ajax请求,获取新微博数据,解析数据后将其渲染至网页中。
Python爬虫中Ajax数据的抓取策略
由此可见,真实数据均通过Ajax请求获取。若要抓取这些数据,需明确请求的发送方式、目标地址及携带参数。掌握这些信息后,即可使用Python模拟该发送操作,从而获取所需结果。
在下一节中,我们将探讨如何查看后台Ajax操作,了解其发送机制及具体参数。
以上为Python3爬虫中Ajax用法的详细内容,更多关于Python3中Ajax的资料请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















