


Python3 Scrapy生成CSV文件实战:腾讯招聘数据爬取示例

发布时间:2026-10-13 |
3人浏览过
本文介绍如何使用Python3和Scrapy框架爬取腾讯招聘网信息并生成CSV文件。通过调用cmdline命令而非导入csv模块,实现高效数据导出。示例包含items定义、Spider编写及yield用法解析,适合新手参考学习。
为了获取腾讯招聘网站的相关信息,已有不少开发者完成过类似项目。出于新手学习的目的,本文也进行了实践尝试,供读者参考借鉴。
本方案采用调用cmdline命令的方式生成CSV文件,而非直接使用import csv模块。
from scrapy import cmdline
cmdline.execute("scrapy crawl field -o info.csv -t csv".split())
上述代码被保存至自定义的.py文件中,并在主程序里调用该模块。这种方式避免了每次在命令行手动输入指令的繁琐,操作更为便捷。
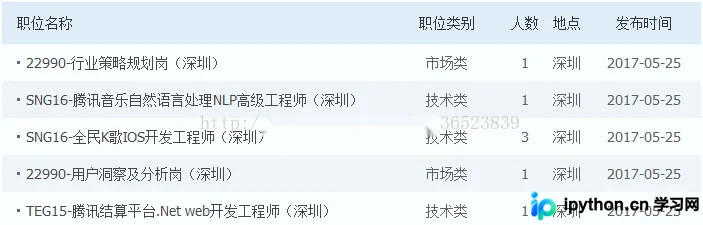
接下来进入核心环节,目标是获取腾讯招聘网的数据(网址:http://hr.tencent.com/position.php)。
最终保存的CSV文件内容如下所示:
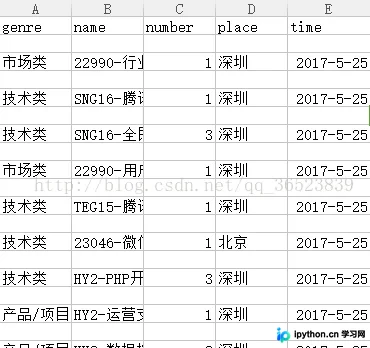
首先,需要利用Scrapy的items容器来定义并记录所需获取的数据字段:
import scrapy

class GetItem(scrapy.Item):
  name = scrapy.Field()    #招聘单位
  genre = scrapy.Field()   #招聘类型
  number = scrapy.Field()   #招聘人数
  place = scrapy.Field()   #招聘地点
  time = scrapy.Field()    #招聘时间
上述定义即为后续需要抓取的具体信息项。
随后,新建Spider文件以编写爬取网站的逻辑代码:
# _*_ coding:utf-8 _*_
import scrapy
from scrapy.http import Request
from time import sleep
import os
import sys
sys.path.append("D:\PYscrapy\get_Field") #我使用这种路径添加的方式来调用GetItem函数和main函数
from get_Field.items import GetItem
import main  #main函数开头就说了两行调用程序的代码,你也可以在cmd中使用scrapy crawl field -o info.csv -t csv来调用。主要是方便

class Tencentzhaopin(scrapy.Spider):
  name = "field"  #这个程序要执行的唯一标识名 可以自己设置
  start_urls = ["http://hr.tencent.com/position.php?&start=0#a"] #首页网址
  url = "http://hr.tencent.com/" #由于有翻页操作所以我们设置翻页前缀,等一下获取后缀
  count = 0
  names = []    #这五个列表记录我们获取的信息
  genres = []
  numbers = []
  places = []
  times = []
  filename = "data.txt"  #保存的文件名
  if os.path.exists(filename) == True:  #判断这个文件是否已经存在文件夹中,有就移除掉。
    os.remove(filename)

  def parse(self,response):
    self.count += 1 #设置我们需要爬去多少页,不设置的话会有几百页需要爬取
    name = response.xpath('//table//td[@class="l square"]//a//text()').extract()
    #通过xpath方法获取我们需要的内容,再使用extract()抽取器获取到
    for i in name:    #利用循环将每一次的内容存入我们上面设置的列表中去,方便后面存入csv文件(下面4个类似)
      self.names.append(i)
    genre = response.xpath('//table//tr[not(@class="h")]//td[2][not(@align="center")]//text()').extract()
    for i in genre:
      self.genres.append(i)
    number = response.xpath('//table//tr[not(@class="h")]//td[3][not(@align="center")]//text()').extract()
    for i in number:
      self.numbers.append(i)
    place = response.xpath('//table//tr[not(@class="h")]//td[4][not(@align="center")]//text()').extract()
    for i in place:
      self.places.append(i)
    time = response.xpath('//table//tr[not(@class="h")]//td[5][not(@align="center")]//text()').extract()
    for i in time:
      self.times.append(i)

    new_url = response.xpath('//*[@id="next"]//@href').extract()
    #前面我们说过需要翻页操作,所以这里是获取到翻页的后缀
    new_url = self.url+new_url[0] #再与前缀结合,获取到一个完整的下一页链接
    sleep(0.5) #我们设置一个翻页的时间,太快了不好。。。。(我是这样想的)

    #下面就是信息存入items容器
    for i in range(len(self.genres)): #for循环列表的长度,获取到所有信息
      info = GetItem()  #实例一个类info用来保存数据
      info["name"] = self.names[i]    #将每一个属性列表中的每一个数据保存依次保存到info中去
      info["genre"] = self.genres[i]
      info["number"] = self.numbers[i]
      info["place"] = self.places[i]
      info["time"] = self.times[i]
      yield info #这个yield注意了,嗯,这就很舒服了
      #我们将每一次保存的数据返回,但是返回了我们还需要程序继续执行,所以使用yield函数返回后继续执行

    if self.count<=20:
      yield Request(url=new_url,callback=self.parse)
      #如果满足20页以内,我们callback返回下一页的链接继续到parse这个默认函数,
以上即为Spider模块中的完整代码。
实现该代码并不复杂,唯一可能令人困惑的是第一个yield的使用。起初尝试通过调用新函数来返回值,但过程繁琐且存在小问题,因此采用当前简洁方式即可。yield负责将每次循环的数据返回,并在返回后继续执行后续循环逻辑。
总结
以上就是本文关于Python3使用Scrapy生成CSV文件的代码示例全部内容,希望对你有所帮助。感兴趣的朋友可继续查阅本站其他相关专题,如有不足之处,欢迎留言指正。感谢朋友们对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















