


Python微信好友数据分析:性别、头像、签名与位置可视化

本文基于Python对微信好友数据进行多维度分析,涵盖性别分布、头像识别、签名情感及地理位置。利用itchat获取数据,结合jieba、SnowNLP、matplotlib及wordcloud等库,通过饼图、柱状图与词云直观展示好友特征,探讨数据背后的社交现象与用户行为模式。
微信近期推出了一项重要更新,允许用户对“发现”页面进行自定义设置。不知从何时起,微信朋友圈的功能日益繁杂,随着越来越多用户开启“仅展示最近三天朋友圈”选项,微信官方似乎也对此感到无奈。随着好友关系的逐渐泛化,微信已从熟人社交平台演变为半熟人乃至陌生人社交场所,朋友圈中那些真假难辨的状态更新,仿佛在竭力证明每个个体的“独特性”。
有人通过朋友圈记录生活点滴,有人借此展示观点异同,但归根结底,人们总是在窥探他人生活的同时,又害怕被他人过度了解。人性中光明与黑暗交织,恰如一只长满尖刺的刺猬:离得太远感到寒冷,靠得太近又害怕被刺伤。朋友圈如同过年走亲戚,即便心中有一万个不痛快,也不愿彻底撕破脸,于是选择屏蔽、不展示或仅展示三天。结果是通讯录联系人越来越多,朋友圈越来越大,却再难出现真正触动内心的“小红点”。人类让产品变得愈发复杂,却抱怨其无法满足需求,这或许是一开始就始料未及的局面。
引言
有人说,人性远比计算机编程复杂,因为即使是人类最伟大的发明——计算机,在面对自然语言时也会显得手足无措。人类语言中存在大量模棱两可的含义,我认为语言往往是人类最大的误解来源。人们时常喜欢揣测语言背后隐藏的含义,仿佛表达清晰会让人感到“没面子”,更不用说网络上流行的猜测女友真实意图的案例了。金庸小说《射雕英雄传》中,信息闭塞的南宋时期,裘千丈的一句戏言便搅得武林天翻地覆。其实,一两句话能说清的事为何如此复杂?黄药师、全真七子、江南六怪间的纠葛,哪一场不是由误会引发?武功震古烁今的武林高手,为何缺乏去伪存真的能力?语言究竟造成了多少误会。
尽管人类语言复杂如无字天书,人们仍从中寻觅蛛丝马迹。古人有文王“拘而演周易”、东方朔测字卜卦,这种带有“迷信”色彩的原始崇拜,如同今天人们迷信星座运势,都是人类在千年演变中不断总结经验和训练的结果。从这个角度看,人工智能或许是一种更加科学化的“迷信”,因为数据和算法让我们不断相信这一切的真实性。生活在数字时代的我们,某种程度上是悲哀的:一面努力在他人面前隐藏真实自我,一面遗憾地感慨无处遁形。每一根数字神经都紧密连接着你和我,你不能期望任何数字设备具备真正的智能,但你生命中的每个瞬间,都在悄然间被数据折射出来。
本文将基于Python对微信好友进行数据分析,主要维度包括:性别、头像、签名、位置。结果主要通过图表和词云两种形式呈现,其中文本类信息将采用词频分析和情感分析两种方法。常言道:工欲善其事,必先利其器。在正式开始前,简要介绍本文使用的第三方模块:
* itchat:微信网页版接口的Python封装,用于获取微信好友信息。
* jieba:结巴分词的Python版本,用于对文本信息进行分词处理。
* matplotlib:Python中的图表绘制模块,用于绘制柱形图和饼图。
* snownlp:Python中的中文分词模块,用于对文本信息进行情感判断。
* PIL:Python中的图像处理模块,用于对图片进行处理。
* numpy:Python中的数值计算模块,配合wordcloud模块使用。
* wordcloud:Python中的词云模块,用于绘制词云图片。
* TencentYoutuyun:腾讯优图提供的Python版本SDK,用于识别人脸及提取图片标签信息。
以上模块均可通过pip安装,关于各模块使用的详细说明,请自行查阅各自文档。
数据分析
分析微信好友数据的前提是获取好友信息,使用itchat模块可使这一过程变得非常简单,通过以下两行代码即可实现:
itchat.auto_login(hotReload = True)
friends = itchat.get_friends(update = True)
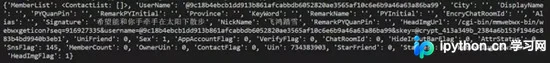
与平时登录网页版微信一样,我们使用手机扫描二维码登录。这里返回的friends对象是一个集合,第一个元素是当前用户。因此,在后续数据分析流程中,我们始终取friends[1:]作为原始输入数据。集合中的每个元素都是字典结构,以我本人为例,可以注意到这里有Sex、City、Province、HeadImgUrl、Signature这五个字段,我们接下来的分析将从这四个字段入手:
好友性别
分析好友性别,首先需获取所有好友的性别信息。我们将每个好友信息的Sex字段提取出来,分别统计Male、Female和Unkonw(原文拼写)的数目,将这三个数值组装到一个列表中,即可使用matplotlib模块绘制饼图。其代码实现如下:
def analyseSex(firends):
  sexs = list(map(lambda x:x['Sex'],friends[1:]))
 counts = list(map(lambda x:x[1],Counter(sexs).items()))
 labels = ['Unknow','Male','Female']
 colors = ['red','yellowgreen','lightskyblue']
 plt.figure(figsize=(8,5), dpi=80)
 plt.axes(aspect=1)
 plt.pie(counts, #性别统计结果
   labels=labels, #性别展示标签
   colors=colors, #饼图区域配色
   labeldistance = 1.1, #标签距离圆点距离
   autopct = '%3.1f%%', #饼图区域文本格式
   shadow = False, #饼图是否显示阴影
   startangle = 90, #饼图起始角度
   pctdistance = 0.6 #饼图区域文本距离圆点距离
 )
 plt.legend(loc='upper right',)
 plt.title(u'%s的微信好友性别组成' % friends[0]['NickName'])
 plt.show()
这里简单解释下这段代码,微信中性别字段的取值有Unkonw、Male和Female三种,其对应的数值分别为0、1、2。通过Collection模块中的Counter()对这三种不同的取值进行统计,其items()方法返回的是一个元组的集合,该元组的第一维元素表示键,即0、1、2,该元组的第二维元素表示数目,且该元组的集合是排序过的,即其键按照0、1、2的顺序排列,所以通过map()方法就可以得到这三种不同取值的数目,我们将其传递给matplotlib绘制即可,这三种不同取值各自所占的百分比由matplotlib计算得出。下图是matplotlib绘制的好友性别分布图:
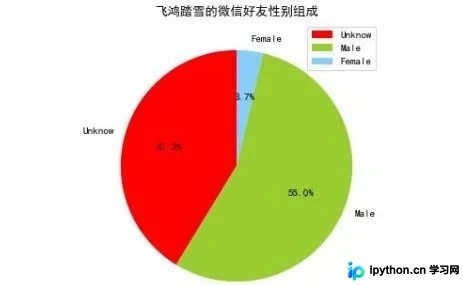
看到这个结果,我一点都不觉得意外,男女比例严重失衡。这虽然可以解释我单身的原因,可我不觉得通过调整男女比例就能解决问题。好多人认为自己单身是因为社交圈子狭小,那么是不是扩展了社交圈子就能摆脱单身呢?我觉得或许这样会增加脱单的概率,可幸运之神应该不会眷顾我,因为我的好运气早在我24岁以前就消耗完啦。在知乎上有一个热门的话题:现在的男性是否普遍不再对女性展开追求了?其实哪里会有人喜欢孤独呢?无非是怕一次又一次的失望罢了。有的人并不是我的花儿,我只是恰好途径了她的绽放。曾经有人说我是一个多情的人,可她永远不会知道,我做出的每一个决定都炽热而悲壮。所谓“慧极必伤,情深不寿;谦谦君子,温润如玉”,世人苦五毒者大抵如此。
好友头像
分析好友头像,从两个方面来分析:第一,在这些好友头像中,使用人脸头像的好友比重有多大;第二,从这些好友头像中,可以提取出哪些有价值的关键字。这里需要根据HeadImgUrl字段下载头像到本地,然后通过腾讯优图提供的人脸识别相关的API接口,检测头像图片中是否存在人脸以及提取图片中的标签。其中,前者是分类汇总,我们使用饼图来呈现结果;后者是对文本进行分析,我们使用词云来呈现结果。关键代码如下所示:
def analyseHeadImage(frineds):
 # Init Path
 basePath = os.path.abspath('.')
 baseFolder = basePath + '\\HeadImages\\'
 if(os.path.exists(baseFolder) == False):
  os.makedirs(baseFolder)
 # Analyse Images
 faceApi = FaceAPI()
 use_face = 0
 not_use_face = 0
 image_tags = ''
 for index in range(1,len(friends)):
  friend = friends[index]
  # Save HeadImages
  imgFile = baseFolder + '\\Image%s.jpg' % str(index)
  imgData = itchat.get_head_img(userName = friend['UserName'])
  if(os.path.exists(imgFile) == False):
   with open(imgFile,'wb') as file:
    file.write(imgData)
  # Detect Faces
  time.sleep(1)
  result = faceApi.detectFace(imgFile)
  if result == True:
   use_face += 1
  else:
   not_use_face += 1
  # Extract Tags
  result = faceApi.extractTags(imgFile)
  image_tags += ','.join(list(map(lambda x:x['tag_name'],result)))
 labels = [u'使用人脸头像',u'不使用人脸头像']
 counts = [use_face,not_use_face]
 colors = ['red','yellowgreen','lightskyblue']
 plt.figure(figsize=(8,5), dpi=80)
 plt.axes(aspect=1)
 plt.pie(counts, #性别统计结果
   labels=labels, #性别展示标签
   colors=colors, #饼图区域配色
   labeldistance = 1.1, #标签距离圆点距离
   autopct = '%3.1f%%', #饼图区域文本格式
   shadow = False, #饼图是否显示阴影
   startangle = 90, #饼图起始角度
   pctdistance = 0.6 #饼图区域文本距离圆点距离
 )
 plt.legend(loc='upper right',)
 plt.title(u'%s的微信好友使用人脸头像情况' % friends[0]['NickName'])
 plt.show()
 image_tags = image_tags.encode('iso8859-1').decode('utf-8')
 back_coloring = np.array(Image.open('face.jpg'))
 wordcloud = WordCloud(
  font_path='simfang.ttf',
  background_color="white",
  max_words=1200,
  mask=back_coloring,
  max_font_size=75,
  random_state=45,
  width=800,
  height=480,
  margin=15
 )
 wordcloud.generate(image_tags)
 plt.imshow(wordcloud)
 plt.axis("off")
 plt.show()
这里我们会在当前目录新建一个HeadImages目录,用以存储所有好友的头像,然后我们这里会用到一个名为FaceApi类,这个类由腾讯优图的SDK封装而来,这里分别调用了人脸检测和图像标签识别两个API接口,前者会统计“使用人脸头像”和“不使用人脸头像”的好友各自的数目,后者会累加每个头像中提取出来的标签。其分析结果如下图所示:
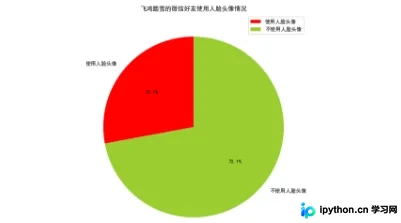
可以注意到,在所有微信好友中,约有接近1/4的微信好友使用了人脸头像,而有接近3/4的微信好友没有人脸头像。这说明在所有微信好友中对“颜值”有自信的人,仅仅占到好友总数的25%,或者说75%的微信好友行事风格偏低调为主,不喜欢用人脸头像做微信头像。这是否说明“好看的皮囊”并非是千篇一律,长得好看的人实在是少数中的少数?所以,当女生的妆容越来越向着“韩式半永久粗平眉”、“瓜子脸”和“大红唇”靠拢的时候,当男生的服饰越来越向着“大背头”、“高领毛衣”和“长款大衣”靠拢的时候,我们能不能真正地个性一次。生命中有太多被世俗绑架着的事情,既要和别人不一样,同时还要和大多数人一样,这是人生在世的无可奈何。考虑到腾讯优图并不能真正地识别“人脸”,我们这里对好友头像中的标签再次进行提取,来帮助我们了解微信好友的头像中有哪些关键词,其分析结果如图所示:
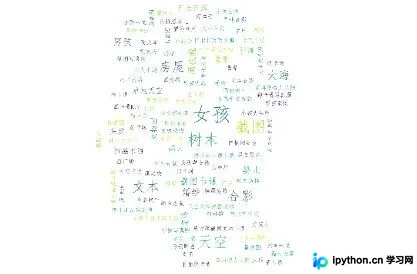
通过词云,我们可以发现:在微信好友中的签名词云中,出现频率相对较高的关键字有:女孩、树木、房屋、文本、截图、卡通、合影、天空、大海。这说明在我的微信好友中,好友选择的微信头像主要有日常、旅游、风景、截图四个来源,好友选择的微信头像中风格以卡通为主,好友选择的微信头像中常见的要素有天空、大海、房屋、树木。通过观察所有好友头像,我发现在我的微信好友中,使用个人照片作为微信头像的有15人,使用网络图片作为微信头像的有53人,使用动漫图片作为微信头像的有25人,使用合照图片作为微信头像的有3人,使用孩童照片作为微信头像的有5人,使用风景图片作为微信头像的有13人,使用女孩照片作为微信头像的有18人,基本符合图像标签提取的分析结果。
好友签名
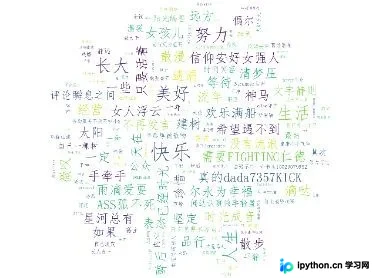
分析好友签名,签名是好友信息中最为丰富的文本信息。按照人类惯用的“贴标签”的方法论,签名可以分析出某一个人在某一段时间里的状态,就像人开心了会笑、哀伤了会哭,哭和笑两种标签,分别表明了人开心和哀伤的状态。这里我们对签名做两种处理:第一种是使用结巴分词进行分词后生成词云,目的是了解好友签名中的关键字有哪些,哪一个关键字出现的频率相对较高;第二种是使用SnowNLP分析好友签名中的感情倾向,即好友签名整体上是表现为正面的、负面的还是中立的,各自的比重是多少。这里提取Signature字段即可,其核心代码如下:
def analyseSignature(friends):
 signatures = ''
 emotions = []
 pattern = re.compile("1f\d.+")
 for friend in friends:
  signature = friend['Signature']
  if(signature != None):
   signature = signature.strip().replace('span', '').replace('class', '').replace('emoji', '')
   signature = re.sub(r'1f(\d.+)','',signature)
   if(len(signature)>0):
    nlp = SnowNLP(signature)
    emotions.append(nlp.sentiments)
    signatures += ' '.join(jieba.analyse.extract_tags(signature,5))
 with open('signatures.txt','wt',encoding='utf-8') as file:
   file.write(signatures)
 # Sinature WordCloud
 back_coloring = np.array(Image.open('flower.jpg'))
 wordcloud = WordCloud(
  font_path='simfang.ttf',
  background_color="white",
  max_words=1200,
  mask=back_coloring,
  max_font_size=75,
  random_state=45,
  width=960,
  height=720,
  margin=15
 )
 wordcloud.generate(signatures)
 plt.imshow(wordcloud)
 plt.axis("off")
 plt.show()
 wordcloud.to_file('signatures.jpg')
 # Signature Emotional Judgment
 count_good = len(list(filter(lambda x:x>0.66,emotions)))
 count_normal = len(list(filter(lambda x:x>=0.33 and x<=0.66,emotions)))
 count_bad = len(list(filter(lambda x:x<0.33,emotions)))
 labels = [u'负面消极',u'中性',u'正面积极']
 values = (count_bad,count_normal,count_good)
 plt.rcParams['font.sans-serif'] = ['simHei']
 plt.rcParams['axes.unicode_minus'] = False
 plt.xlabel(u'情感判断')
 plt.ylabel(u'频数')
 plt.xticks(range(3),labels)
 plt.legend(loc='upper right',)
 plt.bar(range(3), values, color = 'rgb')
 plt.title(u'%s的微信好友签名信息情感分析' % friends[0]['NickName'])
 plt.show()
通过词云,我们可以发现:在微信好友的签名信息中,出现频率相对较高的关键词有:努力、长大、美好、快乐、生活、幸福、人生、远方、时光、散步。果然我的微信好友都是温暖、正直的好青年啊!:smile:其实,签名这个设定,从某种程度上是在反映人的一种心态。人在年轻时不免“为赋新词强说愁”,等到你真正到了这个精神境界,突然发现年轻时图样图森破,或许这就是我们不愿意让别人了解过去的原因,因为伴随着人的成长,某一种瞬间的状态简直不忍直视。QQ空间陪伴了我们这代人的整个青春,令人印象深刻的“那年今日”功能,有时让我们感到回忆的温暖,有时让我们感到岁月的萧杀,“当时只道是寻常”的物是人非,“回首向来萧瑟处”的淡定从容,“今夕复何夕”的失落惆怅……都在这一行行签名里留下深深浅浅的印记。在知乎上有关于签名的话题讨论,对此感兴趣的朋友不妨找时间看看。:smile:
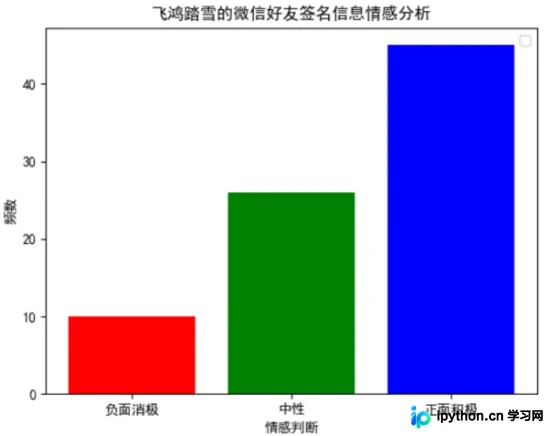
通过柱状图,我们可以发现:在微信好友的签名信息中,正面积极的情感判断约占到55.56%,中立的情感判断约占到32.10%,负面消极的情感判断约占到12.35%。这个结果和我们通过词云展示的结果基本吻合,这说明在微信好友的签名信息中,约有87.66%的签名信息,传达出来都是一种积极向上的态度。
朋友圈中基本上有两类用户:第一类用户使用朋友圈记录自己的生活,第二类用户使用朋友圈输出自己的观点。显然,对于第二类用户,它并不介意别人了解它的过去,它更在乎它从始至终输出的观点是否一致。所以,不管朋友圈里别人在或晒美食、或晒旅游、或秀恩爱、或晒宝宝、或煲鸡汤等等,在我看来这都是一种生活方式。精神层次和物质层次比你高的人群,觉得你朋友圈里的内容“无趣”,这是符合人类一贯的认知方式的。
在大多数情况下,反而是那些和你层次差不多的人群,对不熟悉的人或者事物妄加判断。如果你不喜欢我朋友圈里的内容,请直接屏蔽我就好,因为这样我们还可以做朋友;如果你因为喜欢A而在我这里和我说B不好,这就真的是三观不合啦。我相信没有完全兴趣匹配的两个人,即使是男女朋友或者情侣之间,总之人与人相处嘛,真诚和互相尊重是基本要求。
好友位置
分析好友位置,主要通过提取Province和City这两个字段。Python中的地图可视化主要通过Basemap模块,这个模块需要从国外网站下载地图信息,使用起来非常的不便。百度的ECharts在前端使用的比较多,虽然社区里提供了pyecharts项目,可我注意到因为政策的改变,目前Echarts不再支持导出地图的功能,所以地图的定制方面目前依然是一个问题。主流的技术方案是配置全国各省市的JSON数据,这里博主使用的是BDP个人版,这是一个零编程的方案,我们通过Python导出一个CSV文件,然后将其上传到BDP中,通过简单拖拽就可以制作可视化地图,简直不能再简单,这里我们仅仅展示生成CSV部分的代码:
def analyseLocation(friends):
 headers = ['NickName','Province','City']
 with open('location.csv','w',encoding='utf-8',newline='',) as csvFile:
  writer = csv.DictWriter(csvFile, headers)
  writer.writeheader()
  for friend in friends[1:]:
   row = {}
   row['NickName'] = friend['NickName']
   row['Province'] = friend['Province']
   row['City'] = friend['City']
   writer.writerow(row)
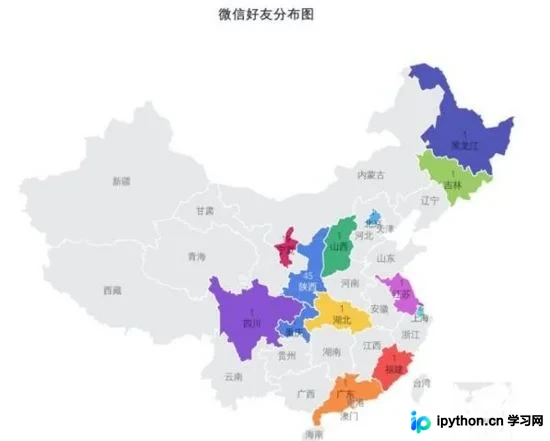
下图是BDP中生成的微信好友地理分布图,可以发现:我的微信好友主要集中在宁夏和陕西两个省份。数字时代的神经牵动着每一个社交关系链的人,我们想要竭力去保护的那点隐私,在这些数据中一点点地折射出来。人类或许可以不断地伪装自己,可这些从数据背后抽离出来的规律和联系不会欺骗人类。数学曾经被人称为最没有用的学科,因为生活中并不需要神圣而纯粹的计算,在不同的学科知识里,经验公式永远比理论公式更为常用。可是此时此刻,你看,这世界就像一只滴滴答答转动着的时钟,每一分每一秒都是严丝合缝的。
本文小结
写这篇文章的时候,我一直不知道该如何下笔,因为微信是一个神奇的存在,它是一个国民级别的全民APP,所以,微信的产品设计一直都是一个有趣的现象。从最初底部Tab的数目、每个Tab的名称、“发现”页面的定制、小程序入口、朋友圈入口到朋友圈评论等等一系列的设计细节,都是值得我们透过人性和心理去研究的。即使是被人们封神的“张小龙”,在面对结构最为复杂的中国用户群体的时候,他的潇洒中依旧不免充满无奈,从对朋友圈的置之不理就可以看出,这是一个怎么做都不会让人满意的功能。任何一个生态在面对巨大的用户群体的时候,功能的增减就会变成一个难题,所谓“林子大了什么鸟都有”,知乎面对的是同样的问题,营销类公众号在不断消费社会话题的同时,引导着一批又一批粉丝的价值取向。人类总渴望着别人了解自己,可人类真的了解自己吗?这篇博客是我对数据分析的又一次尝试,主要从性别、头像、签名、位置四个维度,对微信好友进行了一次简单的数据分析,主要采用图表和词云两种形式来呈现结果。总而言之一句话,“数据可视化是手段而并非目的”,重要的不是我们在这里做了这些图出来,而是从这些图里反映出来的现象,我们能够得到什么本质上的启示。我一位朋友问我怎么什么都想抓取,为什么啊,因为我不懂人类啊!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















