


Python数据分析全流程:从Pandas数据清洗到可视化实战

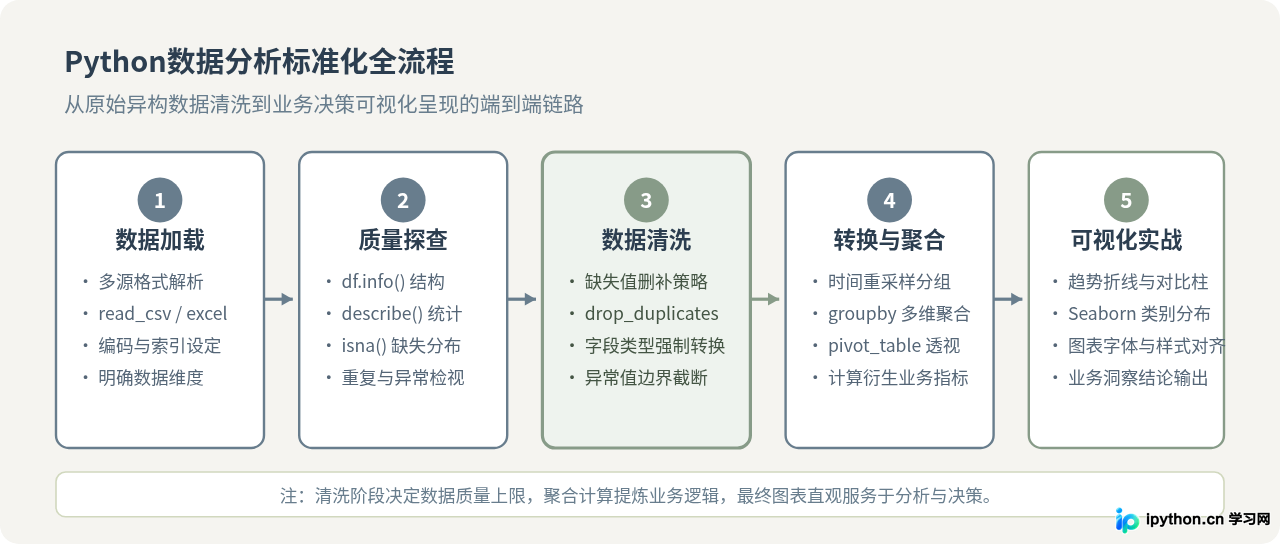
在实际业务中,数据很少以整洁完备的状态直接呈现,通常伴随格式混杂、关键字段缺失、重复录入以及数值越界等质量缺陷。标准的数据分析工作流需要依次完成数据加载、质量探查、数据清洗、多维聚合与可视化图表呈现五个环节。本文以一套典型的电商订单与用户行为数据为例,使用 Python 核心分析库 Pandas、Matplotlib 与 Seaborn,逐步拆解从原始脏数据到自解释业务图表的完整实操链路。
一、数据分析全流程概览与环境准备
完成端到端数据分析任务,需要确保运行环境中具备标准的科学计算与数据展示依赖。主要依赖库包含负责数据操作与清洗的 pandas、数值计算底座 numpy,以及绘图库 matplotlib 与 seaborn。在终端中通过如下命令完成安装:
pip install pandas numpy matplotlib seaborn整个分析流程遵循严格的自底向上推进逻辑:原始数据经过多源读取后,首先进行维度与质量探查;随后进入清洗阶段治理缺失值、重复项、类型错误和异常值;清洗后的干净数据帧流入聚合计算层提炼业务指标,最终输出为直观反映趋势、对比与构成的可视化图表。
二、样本数据构建与质量初步探查
为了完整复现分析现场,首先构建包含真实业务常见缺陷的电商订单样本数据集。数据包含订单编号、用户ID、购买时间、商品类别、订单金额、购买数量及支付方式等核心字段,并注入了缺失值、重复记录、字符串首尾空格以及负数异常金额。
import pandas as pd
import numpy as np

# 构造模拟电商交易脏数据
raw_data = {
    'order_id': ['ORD-1001', 'ORD-1002', 'ORD-1003', 'ORD-1004', 'ORD-1004', 'ORD-1005', 'ORD-1006', None],
    'user_id': ['U101', 'U102', 'U103', 'U104', 'U104', 'U105', 'U106', 'U107'],
    'order_time': ['2026-03-01 10:15:00', '2026-03-01 14:20:00', '2026/03/02 09:10:00',
                   '2026-03-03 11:00:00', '2026-03-03 11:00:00', '2026-03-04 16:45:00', 'invalid_time', '2026-03-05 18:30:00'],
    'category': [' 电子数码 ', '服饰鞋包', '电子数码', '食品生鲜', '食品生鲜', None, '家居百货', '服饰鞋包'],
    'amount': [2999.0, 158.5, -99.0, 89.9, 89.9, 450.0, None, 320.0],
    'quantity': [1, 2, 1, 3, 3, 1, 2, 1],
    'payment': ['微信支付', '支付宝', '银行卡', '微信支付', '微信支付', '支付宝', '微信支付', '支付宝']
}

df = pd.DataFrame(raw_data)
print("【原始数据预览】\n", df)
在进行任何具体操作前,必须使用 Pandas 内置的三项核心探查方法全面检查数据结构与分布概况:
df.info():检查数据表总行数、各列非空计数值(Non-Null Count)以及字段推断类型(Dtype)。如果时间字段显示为object,说明尚未转换为标准时间序列格式。df.isnull().sum():统计各字段缺失值的绝对数量,结合len(df)计算缺失比率,为后续删补决策提供定量支持。df.describe():输出数值型字段的均值、标准差、四分位数以及极值。若amount列的min为负值,可直接锁定异常数值的存在。
# 探查数据质量概况
print("--- 字段类型与非空统计 ---")
print(df.info())

print("\n--- 缺失值统计 ---")
print(df.isnull().sum())

print("\n--- 数值统计描述 ---")
print(df.describe())
三、Pandas 数据清洗四维核心操作体系
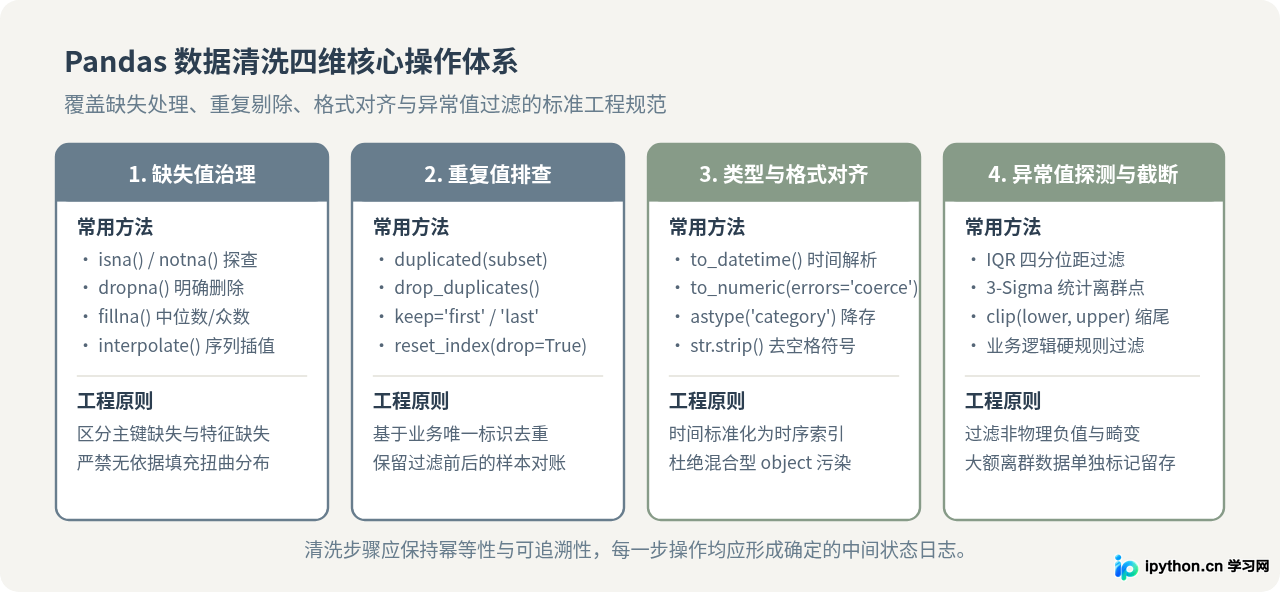
数据清洗的目标是将具有缺陷的异构表格收敛为语义严密、类型准确且取值合规的高质量数据集。完整的清洗操作涵盖缺失值治理、重复值剔除、类型格式规范化以及异常值边界截断四个关键维度。
1. 重复数据识别与去重
在数据流转过程中,前端重试提交或数据库连接中断恢复常常导致完全重复的记录。Pandas 提供 duplicated() 探查重复行,并使用 drop_duplicates() 进行剔除。参数 subset 指定判定唯一的字段组合,keep='first' 表示保留最先出现的样本。
# 依据 order_id 识别并剔除重复记录,重置连续索引
df_clean = df.drop_duplicates(subset=['order_id'], keep='first').copy()
df_clean.reset_index(drop=True, inplace=True)
print("去重后样本量:", len(df_clean))
2. 文本清洗与格式归一化
类别名称中的多余空格会导致本属于同一类的标签被算法识别为不同组别(例如 ' 电子数码 ' 与 '电子数码')。通过字符串访问器 .str.strip() 能够批量去除首尾空格。同时,时间字符串必须转换为标准 datetime64 类型,若存在无法解析的脏字符,使用 errors='coerce' 将其置为 NaT,避免程序崩溃中断。
# 去除类别名称首尾空白字符
df_clean['category'] = df_clean['category'].str.strip()

# 统一时间解析格式,非法字符串强制转为 NaT
df_clean['order_time'] = pd.to_datetime(df_clean['order_time'], errors='coerce')
3. 异常值识别与逻辑过滤
对于电商业务,交易金额小于等于 0 属于典型的逻辑矛盾数据(非退款数据表的正常销售记录)。通常结合业务硬规则或统计学边界进行处理。对于明显不合逻辑的负值行,直接通过布尔掩码进行条件过滤。
# 过滤掉非法的负数金额记录(保留正常正数或等待填补的空值)
valid_amount_mask = (df_clean['amount'].isna()) | (df_clean['amount'] > 0)
df_clean = df_clean[valid_amount_mask].copy()
四、关键机制对比:行级删除 (dropna) vs 统计填补 (fillna)
缺失值是清洗过程中最具争议的环节。初学者往往容易走入两个极端:要么简单粗暴地将所有包含空值的行全数删除,导致样本量严重缩水;要么不加区分地对所有字段一概填充均值,人为扭曲原始特征分布。在相同的清洗边界下,深入理解 dropna 与 fillna 的适用条件与深远影响至关重要。
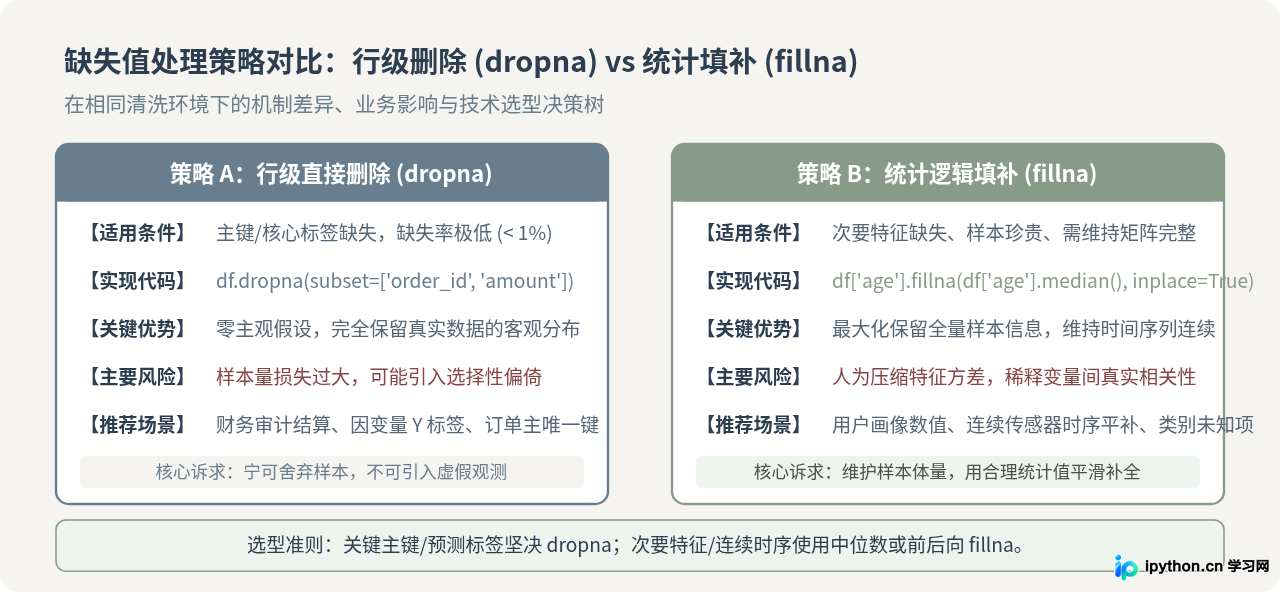
两者的本质差异在于对“样本完整度”与“分布保真度”的权衡抉择:
- 删除策略(dropna):适用于业务核心主键(如
order_id为空)或最终分析目标因变量缺失的情况。此时任何填补都会凭空制造虚假事实。删除能够保证留存数据的纯粹性,但当缺失并非随机发生时(Missing Not at Random),直接删除可能导致样本产生系统性偏差。 - 填补策略(fillna):适用于协变量、用户辅助特征或连续时间序列。对于数值型变量,使用不受极值影响的中位数(Median)通常显著优于受偏态拉动的均值(Mean);对于分类变量,可采用众数或明确的类别标签
'未知'进行填补。填补的代价是人为压低了该特征的方差,并在一定程度上稀释了其与其他字段的统计关联。
在本文的实战场景中,采取分层混合处理机制:对不可或缺的主键 order_id 执行行级删除;对描述性分类字段 category 填充 '未分类';对交易金额 amount 则采用同品类中位数进行合理填补。
# 1. 核心业务主键缺失:坚决删除
df_clean = df_clean.dropna(subset=['order_id']).copy()

# 2. 文本类别缺失:明确填充默认分类标签
df_clean['category'] = df_clean['category'].fillna('未分类')

# 3. 数值字段缺失:按总体中位数进行合理填充
median_amount = df_clean['amount'].median()
df_clean['amount'] = df_clean['amount'].fillna(median_amount)

print("【最终清洗完成数据】\n", df_clean[['order_id', 'order_time', 'category', 'amount', 'payment']])
五、数据变换与多维指标聚合
完成数据清洗后,数据帧具备了高置信度的结构化特征。然而单行订单流水无法直接支撑宏观决策,需要利用 Pandas 的 groupby 与 pivot_table 进行统计降维,提炼多维业务指标。
1. 品类维度业绩汇总
使用 groupby 对商品类别进行分组,同时计算交易总额(sum)、平均客单价(mean)以及订单成交笔数(count),并根据交易总额进行降序排列。
# 按品类统计交易表现
category_metrics = df_clean.groupby('category').agg(
    total_sales=('amount', 'sum'),
    avg_ticket=('amount', 'mean'),
    order_count=('order_id', 'count')
).reset_index().sort_values(by='total_sales', ascending=False)

print("【品类业务指标汇总】\n", category_metrics)
2. 交叉透视分析
利用 pivot_table 探查不同品类在各支付方式上的资金流动分布,直观揭示消费者支付渠道偏好。
# 透视分析:行-商品品类,列-支付方式,值-成交金额总和
payment_pivot = pd.pivot_table(
    df_clean,
    index='category',
    columns='payment',
    values='amount',
    aggfunc='sum',
    fill_value=0.0
)

print("【品类与支付方式交叉透视表】\n", payment_pivot)
六、数据可视化实战:图表构建与样式排版
高质量的可视化不仅要精准展示数据走势,还必须满足标签清晰、对比鲜明与图表自解释的基本要求。在 Python 环境中使用 Matplotlib 与 Seaborn 绘图时,首先需要正确配置中文字体与负号显示,防止中文方块与乱码问题。
import matplotlib.pyplot as plt
import seaborn as sns

# 配置绘图全局中文字体与基础参数
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False
sns.set_theme(style='whitegrid', font='PingFang SC')
实战图表:品类销售额对比与客单价双轴图
以下代码构建复合型业务看板,清晰呈现各品类的销售总额柱状分布与平均客单价折线趋势:
fig, ax1 = plt.subplots(figsize=(9, 5), dpi=100)

categories = category_metrics['category']
sales = category_metrics['total_sales']
avg_tickets = category_metrics['avg_ticket']

# 绘制品类销售总额主柱状图
bars = ax1.bar(categories, sales, color='#687D8D', width=0.45, label='销售总额 (元)')
ax1.set_ylabel('销售总额 (元)', fontsize=12, color='#2C3E50')
ax1.set_xlabel('商品品类', fontsize=12, color='#2C3E50')
ax1.tick_params(axis='y', labelcolor='#2C3E50')

# 在柱状图顶部添加数值标签
for bar in bars:
    height = bar.get_height()
    ax1.annotate(f'{height:.1f}',
                 xy=(bar.get_x() + bar.get_width() / 2, height),
                 xytext=(0, 3),
                 textcoords="offset points",
                 ha='center', va='bottom', fontsize=10, color='#2C3E50')

# 构建次坐标轴展示客单价折线
ax2 = ax1.twinx()
line = ax2.plot(categories, avg_tickets, color='#879B88', marker='o', linewidth=2.5, label='平均客单价 (元)')
ax2.set_ylabel('平均客单价 (元)', fontsize=12, color='#879B88')
ax2.tick_params(axis='y', labelcolor='#879B88')
ax2.grid(False)  # 避免次坐标轴网格线叠加干扰

plt.title('各商品品类销售总额与客单价表现实战对比', fontsize=14, fontweight='bold', pad=15)
fig.tight_layout()

# 保存图表为本地图像并关闭画布
plt.savefig('category_performance.png', dpi=300)
plt.close()- 避免 SettingWithCopyWarning:在对过滤或切片后的 DataFrame 进行赋值时,务必使用显式的
.copy()或.loc[row_indexer, col_indexer],防止在视图副本上操作产生隐蔽的数据污染。 - 时间索引排序陷阱:在按时间周期(如
resample或Grouper)聚合前,必须确保时间序列列经过sort_values升序排序,否则滑动窗口统计会出现逻辑乱序。 - Matplotlib 内存释放:在批量脚本或循环任务中生成图表时,务必在保存后调用
plt.close(fig)显式关闭图形对象,防止长时间运行导致显存与内存泄漏。
七、工程交付全景总结
综上所述,Python 数据分析绝非零散函数的堆砌,而是一套环环相扣的严谨工程化实践体系。从原始异构表格的输入,到经过严格清洗的干净数据帧,再到聚合指标矩阵与直达业务结论的图表看板,每一层的产出都构成了下一阶段的坚实地基。
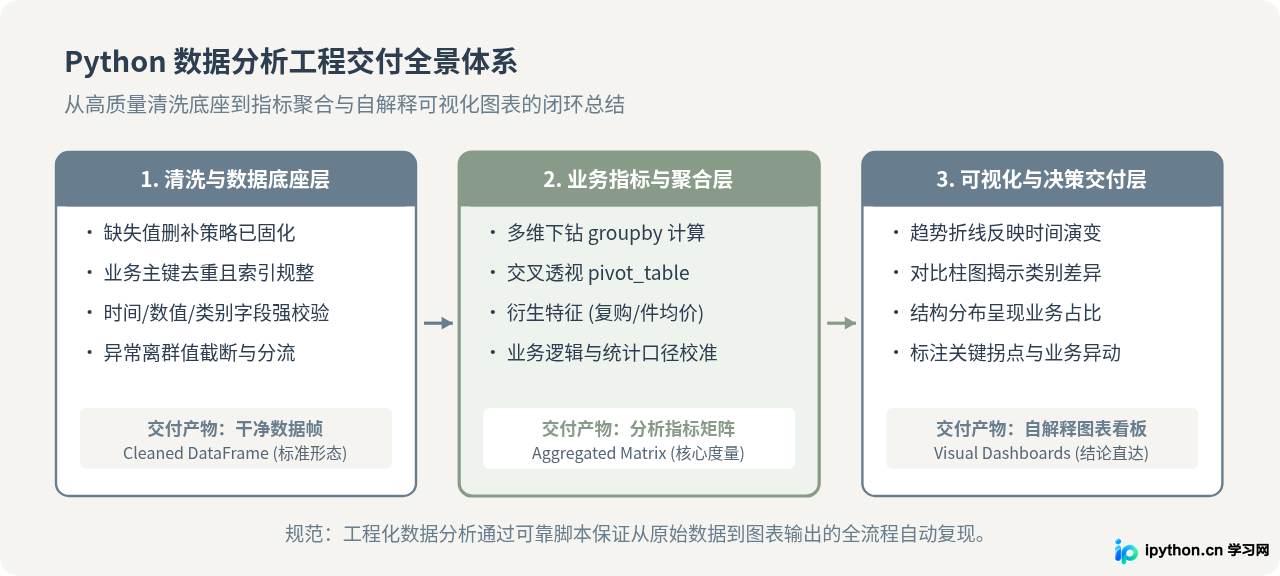
掌握这套标准化流程后,分析师在面对不同业务领域的数据时,都能够依据确定的技术规范快速展开清洗与分析,产出高质量、可复现、自解释的分析决策成果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















