


TensorFlow神经网络优化策略:学习率、正则化与滑动平均详解

本文深入解析TensorFlow中三大核心优化策略。首先介绍指数衰减法通过动态调整学习率平衡训练速度与稳定性;其次探讨L1与L2正则化在抑制过拟合及特征选择中的具体应用与代码实现;最后详解滑动平均模型如何提升模型在测试集上的鲁棒性。内容涵盖参数设置、损失函数构建及完整代码示例,助力开发者构建更稳健的神经网络。
在神经网络模型的优化过程中,开发者常面临诸多挑战,例如学习率的设定、过拟合的预防以及模型泛化能力的提升。通过采用指数衰减策略,模型可在训练初期快速收敛至较优解区域,并在后期稳定逼近最优解。针对过拟合现象,引入正则化手段可有效约束模型复杂度。此外,应用滑动平均模型能显著增强模型在未知数据上的表现稳健性。
一、学习率的设置
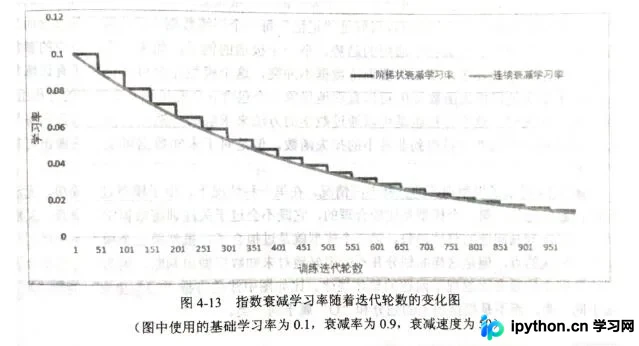
学习率的取值需适中,过大可能导致震荡无法收敛,过小则训练效率低下。TensorFlow提供了更为灵活的指数衰减学习率机制。该方法旨在初期利用较大的学习率加速寻找较优解,随后随迭代次数增加逐步降低学习率,从而确保模型在训练后期能够平滑且稳定地达到最优值。
tf.train.exponential_decay(learning_rate, global_step, decay_steps, decay_rate, staircase=False, name=None)
该函数通过指数级方式减小学习率,计算每轮实际优化时的衰减后学习率公式为:decayed_learning_rate = learning_rate * decay_rate ^ (global_step / decay_steps)。其中,learning_rate为初始设定的学习率,decay_rate为衰减系数,decay_steps控制衰减速度。如图所示,当参数staircase=False时,学习率呈连续曲线下降(浅色部分);当staircase=True时,学习率呈阶梯状下降(深色部分)。阶梯式设置常用于每完整遍历一遍训练数据后降低一次学习率的场景。
使用示例:learning_rate = tf.train.exponential_decay(starter_learning_rate, global_step, 100000, 0.96, staircase=True)。
二、过拟合问题
1. 过拟合问题及其解决方法
过拟合是指模型过于复杂,导致其记住了训练数据中的随机噪声,而忽略了对数据通用趋势的学习。
解决过拟合的常用方法是正则化(Regularization)。其核心思想是在损失函数中加入衡量模型复杂度的指标,将优化目标定义为J(θ)+λR(w)。其中,R(w)用于刻画模型复杂度,主要包含权重项w而不包括偏置项b;λ表示模型复杂损失在总损失中的权重比例。通常模型复杂度仅由权重w决定。常用的复杂度函数R(w)主要有两种:L1正则化和L2正则化。
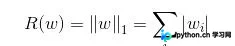
另一种是L2正则化:
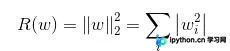
无论采用哪种正则化方式,基本思路均是通过限制权重大小,防止模型过度拟合训练数据中的随机噪声。两者的区别在于:L1正则化会使参数变得稀疏(即更多参数变为0),具有类似特征选择的功能;而L2正则化不会使参数稀疏。在实际应用中,也可同时使用L1和L2正则化:
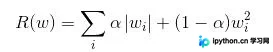
2. 过拟合问题的TensorFlow解决方案
loss = tf.reduce_mean(tf.square(y_ - y) + tf.contrib.layers.l2_regularizer(lambda)(w))
上述代码展示了一个包含L2正则化项的损失函数。第一部分为均方误差损失,第二部分为正则化项。参数lambda表示正则化项的权重(即公式中的λ),w为需要计算正则化损失的参数。tf.contrib.layers.l2_regularizer()函数用于计算给定参数的L2正则化项,类似地,tf.contrib.layers.l1_regularizer()用于计算L1正则化项。
# 比较L1正则化和L2正则化函数的作用效果
w = tf.constant([[1.0, -2.0], [-3.0, 4.0]])
with tf.Session() as sess:
  # 0.5*(|1|+|-2|+|-3|+|4|=5.0)
  print(sess.run(tf.contrib.layers.l1_regularizer(0.5)(w))) # 5.0
  # 0.5*[(1+4+9+16)/2]=7.5 TensorFlow会将L2正则化项除以2使得求导的结果更简洁
  print(sess.run(tf.contrib.layers.l2_regularizer(0.5)(w))) # 7.5
随着神经网络参数增多,直接定义损失函数会导致代码冗长且可读性差。当网络结构复杂时,定义网络结构与计算损失函数的部分可能分散在不同函数中,通过变量方式计算损失变得不便。为此,可利用TensorFlow提供的集合(collection)机制来解决此问题。具体实现见代码部分。
tf.add_to_collection()用于将变量加入指定集合;tf.get_collection()返回存储该集合元素的列表。
三、滑动平均模型
另一种提升模型在测试数据上鲁棒性(robust)的方法是滑动平均模型。在使用随机梯度下降算法训练神经网络时,应用滑动平均模型在许多场景下能提高最终模型在测试数据上的表现。GradientDescent和Momentum训练方式均可从ExponentialMovingAverage方法中受益。
TensorFlow提供的tf.train.ExponentialMovingAverage类用于实现滑动平均模型。初始化该对象时,需指定衰减率decay和动态控制衰减率的参数num_updates。该类为每个变量维护一个影子变量(shadow variable),其初始值与相应变量的初始值相同。每次变量更新时,执行公式:shadow_variable = decay * shadow_variable + (1 - decay) * variable。从公式可见,decay决定模型更新速度,decay越大模型越稳定,实际应用中通常设置为接近1的数值。num_updates默认为None;若设置,则衰减率按min(decay, (1 + num_updates) / (10 + num_updates))计算。
tf.train.ExponentialMovingAverage对象的apply方法返回对var_list进行更新滑动平均的操作,var_list必须是Variable或Tensor的列表。执行该操作会更新var_list的影子变量shadow_variable。average方法可获取滑动平均后变量的取值。
四、代码呈现
1. 复杂神经网络结构权重L2正则化方法
import tensorflow as tf

'''''
# 比较L1正则化和L2正则化函数的作用效果
w = tf.constant([[1.0, -2.0], [-3.0, 4.0]])
with tf.Session() as sess:
  # 0.5*(|1|+|-2|+|-3|+|4|=5.0)
  print(sess.run(tf.contrib.layers.l1_regularizer(0.5)(w))) # 5.0
  # 0.5*[(1+4+9+16)/2]=7.5 TensorFlow会将L2正则化项除以2使得求导的结果更简洁
  print(sess.run(tf.contrib.layers.l2_regularizer(0.5)(w))) # 7.5
'''

# 复杂神经网络结构权重L2正则化方法
# 定义各层的权重,并将该权重的L2正则化项加入至名称为‘losses'的集合
def get_weight(shape, lambda1):
  var = tf.Variable(tf.random_normal(shape), dtype=tf.float32)
  tf.add_to_collection('losses', tf.contrib.layers.l2_regularizer(lambda1)(var))
  return var

x = tf.placeholder(tf.float32, (None, 2))
y_ = tf.placeholder(tf.float32, (None, 1))

layer_dimension = [2,10,5,3,1] # 定义了神经网络每层的节点数
n_layers = len(layer_dimension)

current_layer = x # 将当前层设置为输入层
in_dimension = layer_dimension[0]

# 通过循环生成一个5层全连接的神经网络结构
for i in range(1,n_layers):
  out_dimension = layer_dimension[i]
  weight = get_weight([in_dimension,out_dimension], 0.003)
  bias = tf.Variable(tf.constant(0.1, shape=[out_dimension]))
  current_layer = tf.nn.relu(tf.matmul(current_layer, weight) + bias)
  in_dimension = layer_dimension[i]

mse_loss = tf.reduce_mean(tf.square(y_ - current_layer))
tf.add_to_collection('losses', mse_loss)
loss = tf.add_n(tf.get_collection('losses')) # 包含所有参数正则化项的损失函数
2. tf.train.ExponentialMovingAverage使用样例
import tensorflow as tf

# tf.train.ExponentialMovingAverage使用样例
v1 = tf.Variable(0, dtype=tf.float32)
step = tf.Variable(0, trainable=False) # 此处step模拟神经网络迭代的轮数
# 定义一个滑动平均的类对象,初始化衰减率decay=0.99,用于动态控制衰减率的参数num_updates
ema = tf.train.ExponentialMovingAverage(0.99, num_updates=step)

# apply方法返回一个对var_list进行更新滑动平均的操作,var_list必须是list的Variable或Tensor
# 该操作执行会更新var_list的影子变量shadow variable
maintain_averages_op = ema.apply(var_list=[v1])

with tf.Session() as sess:
  init_op = tf.global_variables_initializer()
  sess.run(init_op)
  # average方法可获取滑动平均后变量的取值
  print(sess.run([v1, ema.average(v1)])) # [0.0, 0.0]

  sess.run(tf.assign(v1, 5))
  # min{0.99, (1+step)(10+step)=0.1}=0.1
  # 更新v1的滑动平均值为 0.1*0.0+0.9*5=4.5
  sess.run(maintain_averages_op)
  print(sess.run([v1, ema.average(v1)])) # [5.0, 4.5]

  sess.run(tf.assign(step, 10000))
  sess.run(tf.assign(v1, 10))
  # min{0.99, (1+step)(10+step)=0.999}=0.99
  # 更新v1的滑动平均值为 0.99*4.5+0.01*10=4.555
  sess.run(maintain_averages_op)
  print(sess.run([v1, ema.average(v1)])) # [10.0, 4.5549998]

  # 更新v1的滑动平均值为 0.99*4.555+0.01*10=4.60945
  sess.run(maintain_averages_op)
  print(sess.run([v1, ema.average(v1)])) # [10.0, 4.6094499]
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















