为什么Python是人工智能和数据分析的首选语言
深入解析Python为何成为人工智能与数据分析领域的核心语言。从胶水语言架构、语法表达效率、生态库协同到典型应用流程与适用边界,提供详尽的技术对比与实践示例。
09-17
17




深入解析Python为何成为人工智能与数据分析领域的核心语言。从胶水语言架构、语法表达效率、生态库协同到典型应用流程与适用边界,提供详尽的技术对比与实践示例。
本文详细解析 C# 中 Console.WriteLine() 的进阶用法,包括使用 {0}、{1} 等占位符插入变量参数,以及通过 {v,w} 语法实现参数的长度控制与左右对齐。掌握这些技巧能让控制台输出更整齐美观,提高程序可读性。
本文介绍如何使用OpenCV内置的ANN_MLP类构建神经网络以识别手写数字。通过Keras加载MNIST数据集,配置反向传播算法与Sigmoid激活函数进行模型训练。实验显示100次迭代后准确率达0.9376,且模型文件仅1MB,远小于SVM和KNN,非常适合客户端部署。

本文介绍如何利用Python中的Keras库构建神经网络进行回归运算。Keras作为Tensorflow的高阶API,通过Sequential序贯模型和Dense全连接层简化模型构建。文章详细解析了model.compile中loss函数(如mse)与优化器(如sgd)的配置,并提供了一元线性回归的完整代码示例及运行结果分析。
本文解析Python神经网络中特征金字塔(FPN)的核心原理。针对小目标在深层网络中特征易丢失的问题,FPN通过自顶向下的上采样与横向连接,融合高低层语义信息,有效增强小目标检测能力。结合YOLO3等结构示例,阐述其下采样与上采样机制,为模型优化提供理论参考。
本文详细介绍 TensorFlow 中常用的四种激活函数:Sigmoid、Tanh、ReLU 和 Softplus。分析各自的数学特性、优缺点(如梯度消失、计算速度、零均值等),并提供对应的 TensorFlow API 调用示例,帮助开发者根据模型需求选择合适的非线性激活方式。
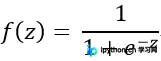
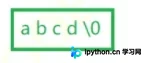
本文深入解析C语言中实现字符串左旋K个字符的多种方法。通过对比朴素移位法、三次逆序旋转法等经典算法,详细讲解其核心逻辑与代码实现。重点剖析如何利用双指针进行原地逆序操作,以最优的时间复杂度O(N)和空间复杂度O(1)解决该编程问题,附带完整代码示例与内存移动图解分析。
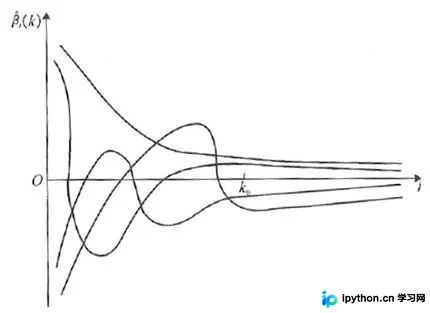
本文介绍如何在R语言中使用MASS包的longley数据集进行岭回归分析,以解决变量间的多重共线性问题。内容涵盖岭参数的选择原则、岭迹图的绘制与解读、Lambda值的最优估计方法,以及使用ridge包时可能遇到的兼容性错误及其排查建议。
本文深入解析Java编程中的高频易错点,涵盖异常处理中finally块对返回值的覆盖逻辑、switch语句的穿透机制、null安全调用以及线程生命周期判定。通过分析具体代码案例,帮助开发者理清JVM运行环境与内存模型的关键概念,避免常见陷阱。
本文详解如何在C语言中通过结构体和函数指针实现面向对象的三大特性。利用嵌套结构体达成继承,通过虚函数表机制实现多态,结合命名规范与静态作用域完成封装。文中提供完整的Shape、Triangle等类层次结构代码,展示对象创建、析构及方法调用的真实操作过程。
本文详细解析C#中Virtual(虚方法)与Abstract(抽象方法)的核心区别。Virtual提供可选重写且必须有实现,用于支持运行时多态;Abstract强制子类重写且无实现,常用于定义规范。文章通过代码示例对比两者在继承体系中的行为差异,并阐明Static关键字对方法调用的影响,帮助开发者准确选择修饰符以构建清晰的对象模型。
本文详细介绍Java中java.util.Random类的常用方法,包括如何生成任意随机整数和指定范围的随机数。重点演示了通过循环判断与独立检查方法生成不含重复数字的随机数组两种实现思路,并对比了基于Arrays.sort的二分查找方案的局限性,帮助开发者掌握基础随机数处理技巧。



