


初学者怎么利用Python进入人工智能领域
面向初学者的实用指南,详细讲解如何以Python为切入点逐步掌握数据处理、经典机器学习与深度学习的核心技能与学习路径。
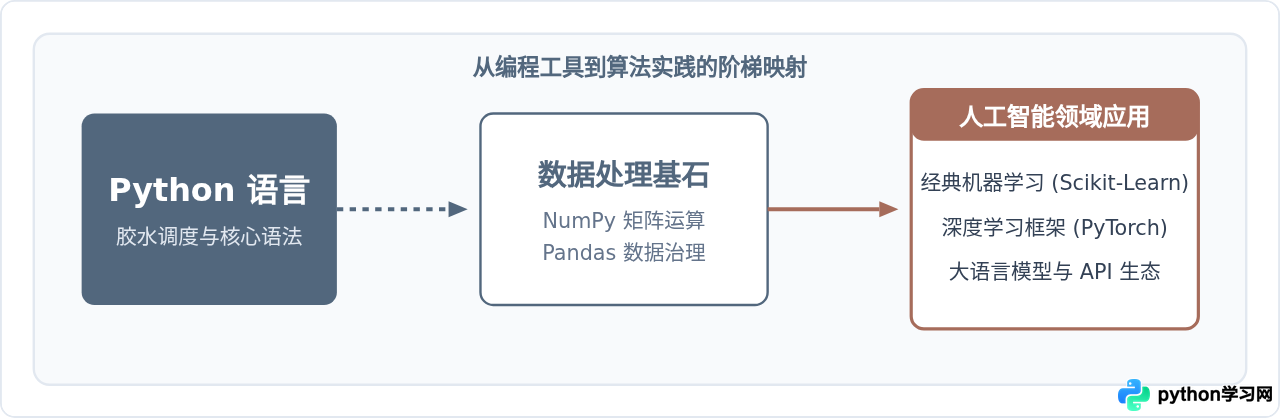
很多刚准备接触人工智能的读者,常常在一堆高深数学证明和花样百出的大模型论文前犹豫不决。进入这个领域最直接且阻力最小的途径,是把 Python 当作一把趁手的“手术刀”,先掌握它组织与清洗数据的能力,再借助成熟的数学与算法类库构建模型,最后延伸到深度学习或大模型应用中。这条路径的核心不是穷尽所有底层理论,而是通过可运行的代码建立对“数据输入、计算建模、结果输出”完整流程的具象理解。
一、厘清定位:Python 在 AI 体系中到底负责什么
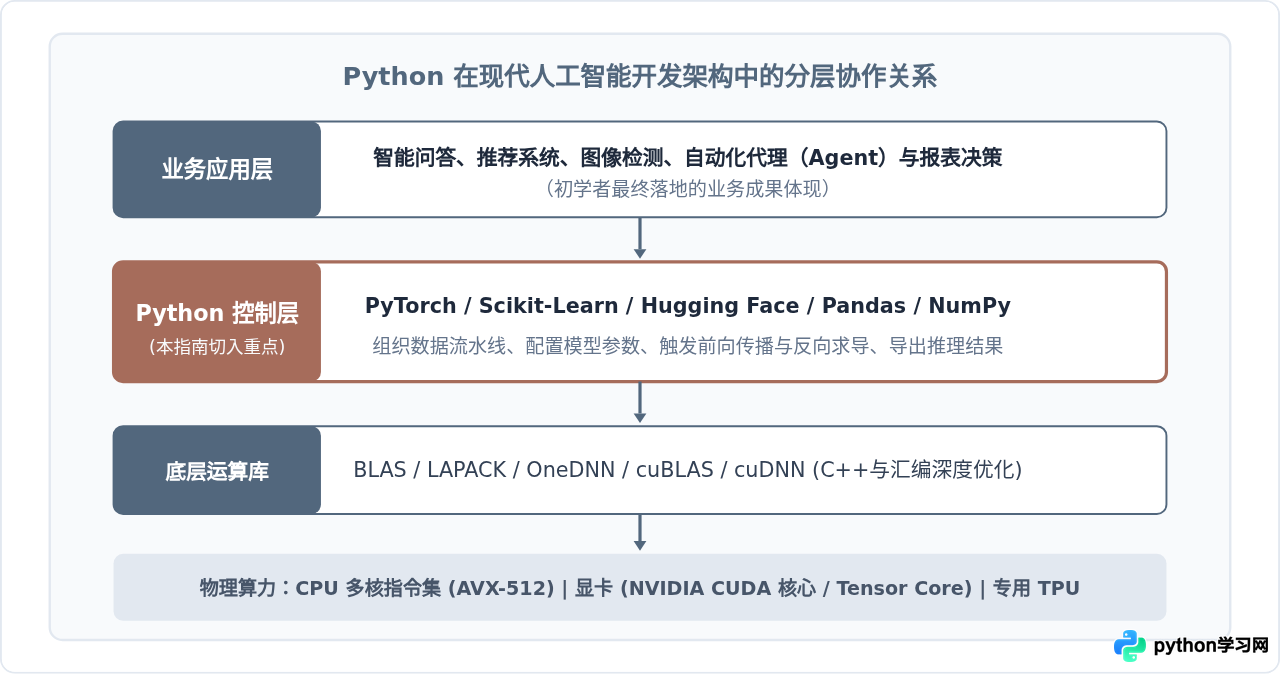
许多初学者容易产生一个误解,认为学人工智能就是从零用 Python 去手写复杂的神经网络底层运算。事实上,底层的张量卷积和矩阵乘法绝大多数由 C++ 或 CUDA 编写并直接跑在显卡上,Python 在整个体系中扮演的是高效率的调度中枢和粘合胶水。
这意味着初学者不需要花半年时间把 Python 的高级元编程、多线程并发锁等冷门机制研究透彻。面向人工智能领域,Python 真正需要熟练掌握的语法子集非常聚焦:
- 基础数据结构操作:熟练使用列表(List)、字典(Dict)、集合(Set)以及列表推导式,这是日常处理样本数据最频繁的方式。
- 函数与模块化封装:掌握参数传递、匿名函数(lambda)以及如何规范拆分数据预处理与预测函数。
- 面向对象编程基础:理解类(Class)与对象属性。因为无论是 PyTorch 的模型定义类,还是 Scikit-Learn 的估算器,都严格遵循面向对象范式。
- 环境管理工具:掌握使用
conda或venv创建独立的 Python 虚拟环境,避免各类算法库依赖冲突。
二、第一阶段:掌握数据组织的核心工具(NumPy 与 Pandas)
人工智能算法无论设计得多么巧妙,其本质都是对多维数组进行数学变换。一张图片是高宽色彩构成的三维张量,一段文本分词后映射为向量序列,一份业务报表是二维矩阵。如果不具备用代码组织数据的能力,后续任何算法都无从谈起。
1. 用 NumPy 理解向量与矩阵操作
NumPy 是科学计算的基础包,它提供了连续内存分配的 ndarray。初学者应当掌握的是数组维度的概念以及矩阵广播机制。
import numpy as np

# 模拟3个样本,每个样本包含4个特征数值
features = np.array([
    [1.2, 0.5, 2.1, 0.9],
    [0.8, 1.4, 1.9, 0.4],
    [2.3, 0.1, 0.5, 1.8]
])

# 均值归一化操作:按列计算特征均值,并利用广播机制消除量纲差异
col_mean = np.mean(features, axis=0)
normalized = features - col_mean

print("原始矩阵维度:", features.shape)
print("各列均值:", col_mean)
print("中心化后的前两个样本:\n", normalized[:2])原始矩阵维度: (3, 4)
各列均值: [1.43333333 0.66666667 1.5 1.03333333]
中心化后的前两个样本:
[[-0.23333333 -0.16666667 0.6 -0.13333333]
[-0.63333333 0.73333333 0.4 -0.63333333]]
2. 用 Pandas 处理真实表格数据
在现实业务中,数据往往以 CSV、Excel 或数据库表的形式存在,充满空缺值和非数字格式。Pandas 能够帮助初学者在数行代码内完成表格读取、缺失值插补以及特征类别转换。
三、第二阶段:依托 Scikit-Learn 跑通经典机器学习闭环
跳过经典机器学习直接去学大语言模型,往往会导致只见树木不见森林。Scikit-Learn 把所有常见的回归、分类和聚类算法标准化为统一的 API:fit() 负责学习参数,predict() 负责输出推断,score() 负责打分评价。通过这一套规整的流程,初学者能以最低的学习成本建立起对特征工程、过拟合与交叉验证的坚实理解。
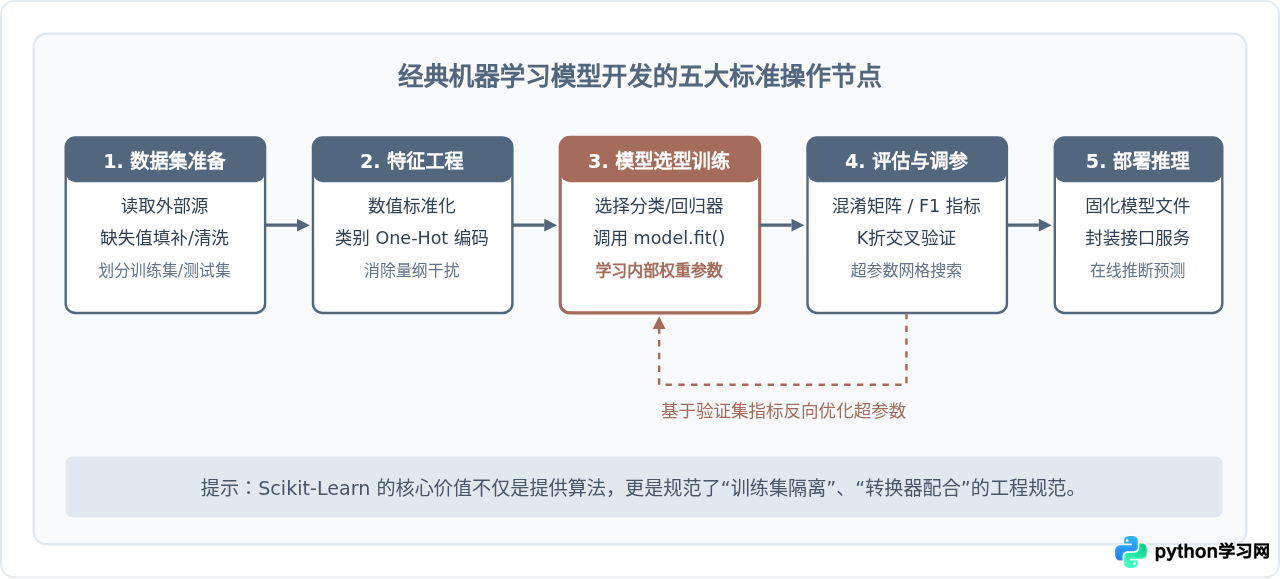
下面是一个完整的分类任务示范:加载鸢尾花数据、标准化特征、训练随机森林模型并评估泛化指标。
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 1. 载入标准测试数据
dataset = load_iris()
X, y = dataset.data, dataset.target

# 2. 严格隔离训练集与测试集(保留20%验证模型未知表现)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 特征缩放(仅在训练集上 fit,避免测试集数据泄漏)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 构建并训练随机森林分类器
model = RandomForestClassifier(n_estimators=50, random_state=42)
model.fit(X_train_scaled, y_train)

# 5. 在未知测试集上产生预测并查看综合指标
predictions = model.predict(X_test_scaled)
print(classification_report(y_test, predictions, target_names=dataset.target_names)) precision recall f1-score support
setosa 1.00 1.00 1.00 10
versicolor 0.90 0.90 0.90 10
virginica 0.90 0.90 0.90 10
accuracy 0.93 30
macro avg 0.93 0.93 0.93 30
weighted avg 0.93 0.93 0.93 30
四、第三阶段:技术进阶分水岭(深度学习还是大模型工程)
完成经典机器学习后,初学者将面临当下最关键的技术分支选择:是深入钻研PyTorch 深度学习框架,还是聚焦大语言模型(LLM)的工程应用生态?两者对知识储备和硬件设备的要求有明显差异,明确自身目标可以节省大量时间。
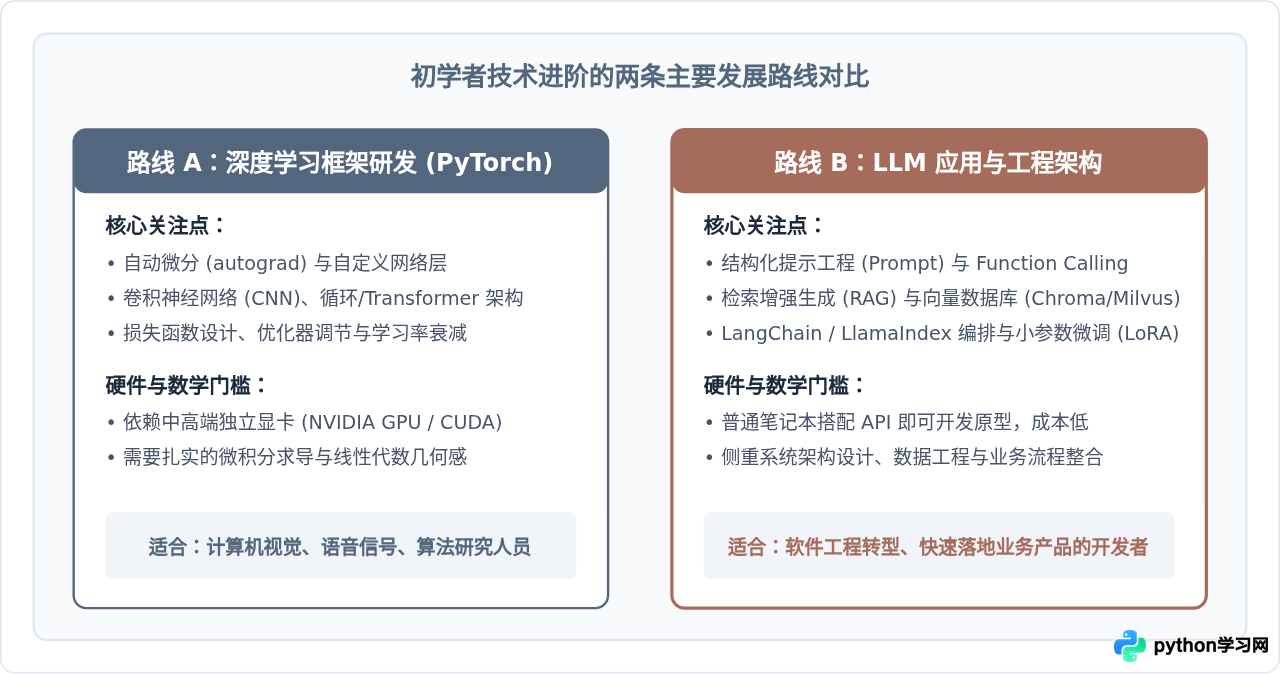
如果目标是路线 A,首先需要掌握 PyTorch 构建张量并在计算图中执行反向传播的基础骨架:
import torch
import torch.nn as nn

# 定义一个极简的两层前馈神经网络
class SimpleClassifier(nn.Module):
    def __init__(self, input_dim, hidden_dim, num_classes):
        super(SimpleClassifier, self).__init__()
        self.fc1 = nn.Linear(input_dim, hidden_dim)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_dim, num_classes)

    def forward(self, x):
        out = self.fc1(x)
        out = self.relu(out)
        out = self.fc2(out)
        return out

# 实例化模型
net = SimpleClassifier(input_dim=4, hidden_dim=16, num_classes=3)
sample_tensor = torch.randn(2, 4)  # 2个批次样本
output = net(sample_tensor)

print("模型结构:\n", net)
print("输出维度 (Batch, Classes):", output.shape)如果目标是路线 B,则无需纠结梯度流反向传递,重心应转向用 Python 组织数据流。例如利用 Hugging Face 接口载入预训练模型提取特征,或者通过结构化函数调用将大语言模型嵌入业务自动化流程。
五、学习路线总结与初学避坑法则
不少初学者在进入人工智能领域时,时间被大量无意义的消耗拖垮。常见的问题包括两个极端:一种是陷入泛函分析和概率论定理无法自拔,三个月写不出一行完整代码;另一种是盲目追赶每天涌现的新模型名字,下载几十个项目却不知道如何排查哪怕一次数据维度不匹配(Shape Mismatch)的报错。
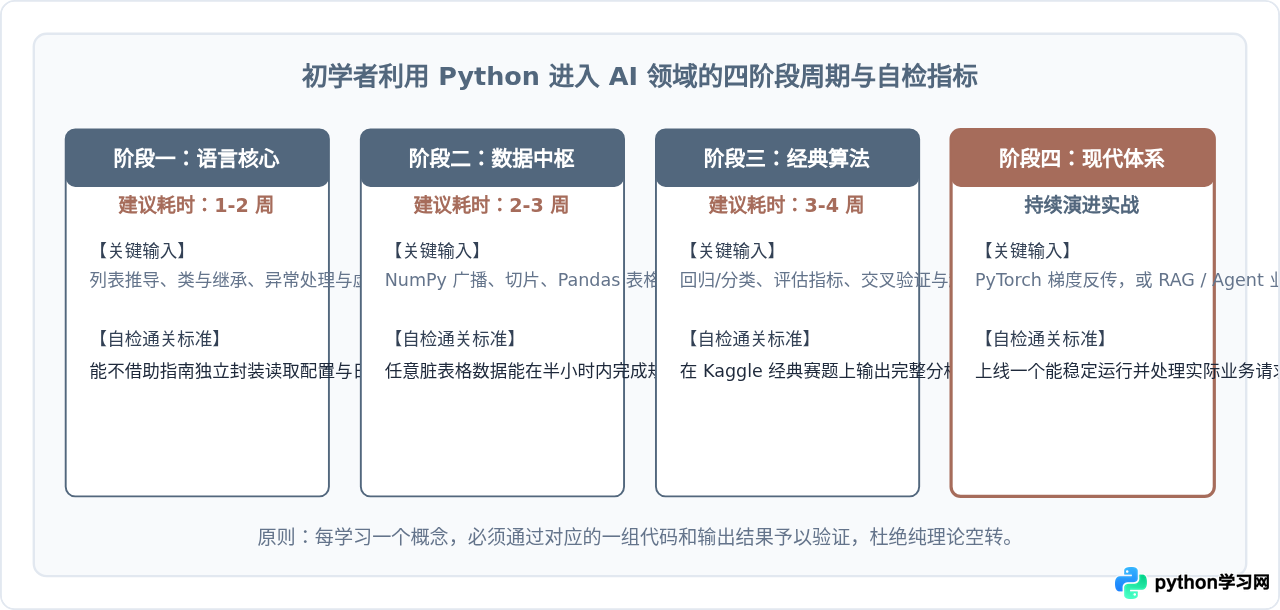
为了保证学习效率,建议在日常练习中遵循以下三条实操原则:
- 拒绝纯看视频教程:每一节知识点都必须在本地的 Jupyter Notebook 或 VS Code 中敲出代码并观察输入输出。对初学者而言,报错信息(Traceback)是理解程序内存分布与矩阵维度的最快途径。
- 按需补充数学知识:不要试图学完大学四年的所有数学课程才开始写代码。当在 Scikit-Learn 中遇到“梯度下降”时,再去翻阅导数与切线的几何意义;当遇到“主成分分析(PCA)”时,再去补充特征值与特征向量的含义。让实际代码需求拉动数学学习。
- 用微型项目串联技能:学完 Pandas 后做一次自动化表格分析,学完 Scikit-Learn 后做一次二手车估价预测,学完 LLM API 后做一个本地知识库问答助手。只有将 Python 的语法、数据结构和模型 API 串接成完整的项目链条,才能真正把“进入人工智能领域”转化为长期可复用的工程能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















