


llama.cpp b12432的KV回滚微基准应该怎样理解?
llama.cpp b12432预发布构建利用位置索引减少KV序列删除扫描;解释官方函数微基准、删除边界测试及生产评估限制。
llama.cpp b12432的预发布修改减少了KV缓存序列删除时的全量扫描,官方微基准测量的是局部函数开销。改变的是这段缓存管理工作的代价,不能直接解释为所有模型的生成速度都会按相同比例提高。
为什么删除少量位置也可能扫描整个缓存
KV缓存保存推理过程中使用的键和值。官方合并请求#32380指出,原有seq_rm通过检查缓存里的每个单元来定位某条序列对应的单元。分配的缓存越大,即使只回滚少量位置,也要承担检查大量单元的开销。
这里应区分分配容量与已经使用的内容。官方基准中的cells表示分配的缓存容量,对应-c参数;used表示对话中已经使用的token数量。两者不是同一个指标,不能把缓存容量直接当成当前对话长度。
llama.cpp b12432如何缩小查找范围
这次实现复用了已有的位置索引。索引按位置排序,新的删除函数从p0对应的下界开始,只遍历到p1之前,而不是从第一个缓存单元逐一检查到最后一个。范围采用[p0, p1),也就是包含起点、不包含终点。
代码仍按序列删除相应关联,并返回成为空单元的最低索引。缓存层据此调整后续寻找可用位置的起点。因此,这不是把全部KV缓存清空,也不是更换模型或扩大上下文上限,而是保持删除语义的同时减少查找工作。
官方微基准能说明什么
合并请求作者在Ryzen 7 5800X上进行了单核固定的微基准:使用-O2编译,对一条序列最后4个位置做一次回滚,取2000次运行的中位数。下列数字来自官方合并请求列出的函数微基准,属于该环境下的局部测量结果。
| 分配单元cells | 已用token | 原master,微秒 | 该修改,微秒 |
|---|---|---|---|
| 32768 | 24576 | 22.77 | 0.70 |
| 131072 | 98304 | 116.73 | 1.02 |
| 163584 | 98304 | 145.08 | 0.88 |
| 262144 | 8192 | 233.08 | 0.60 |
这些结果支持“大容量缓存中少量位置回滚的函数开销下降”这一判断。它们没有测量完整请求的首token延迟、每秒生成token数或GPU吞吐,也没有给出各种硬件和模型的统一性能结论。尤其不能将函数微秒数的比值直接当成整个推理服务的加速倍数。
删除行为是否仍保留原有边界
本次变更同时增加缓存测试,覆盖删除一条序列尾部时保留另一条序列、p1不包含在删除范围、重复位置的所有对应单元被删除,以及释放位置按单元索引重新使用等情况。对于多个序列共享的单元,移除其中一个序列的关联不会把另一个序列仍需的关联一并清掉。
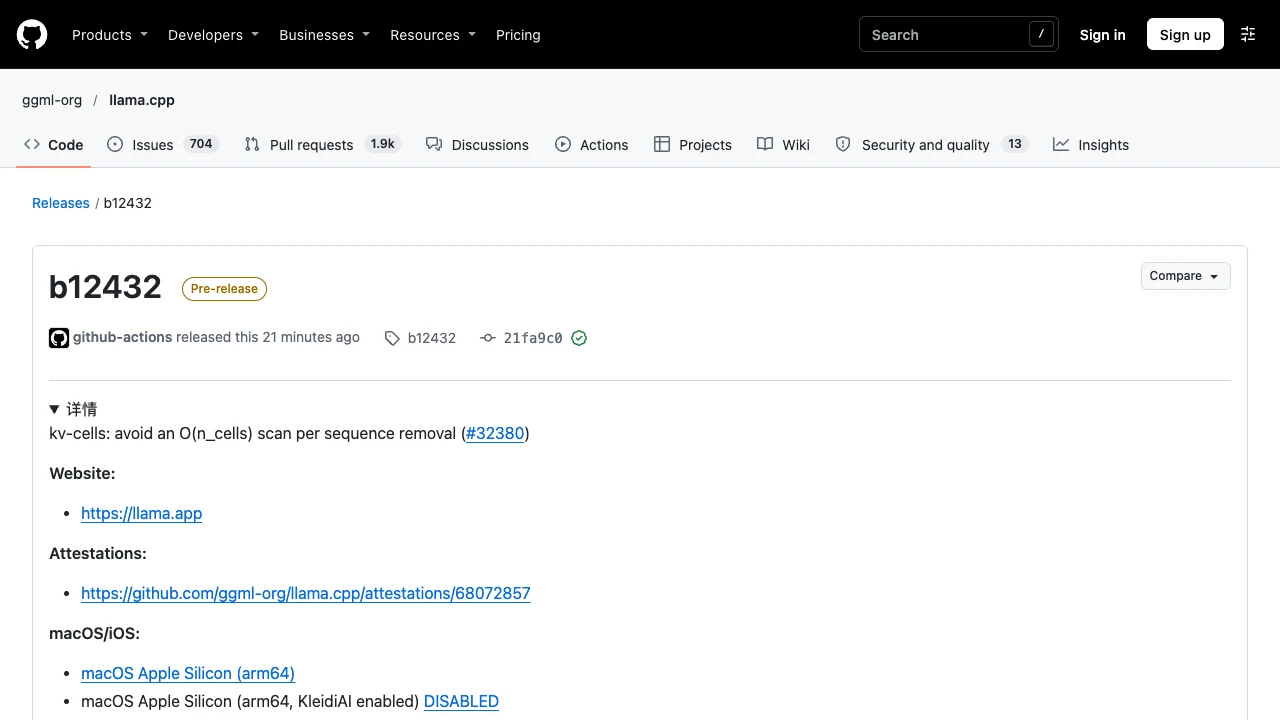
这些是官方新增代码与测试所覆盖的边界,不能外推为所有后端的验证结论。b12432的发布页仍标记Pre-release;对生产环境而言,它首先是可评估的测试构建,不能据此作稳定性承诺。
哪些使用场景更值得关注
分配较大KV缓存、且经常进行少量位置回滚的推理流程,更贴近这份微基准讨论的问题。若一次请求的大部分时间用于模型计算,减少缓存管理开销对总耗时的影响仍取决于实际负载。此次说明没有要求所有CPU、CUDA、HIP或其他后端用户立即更换环境,也没有披露安全风险或强制迁移期限。
理解llama.cpp b12432时,重点是“从扫描全部分配单元转向按序列位置范围查找”。它改善了一条明确的内部路径;模型、硬件、上下文大小与应用请求特征,仍然决定用户最终能观察到什么变化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















