Python爬取网页的详细步骤与代码实例教程
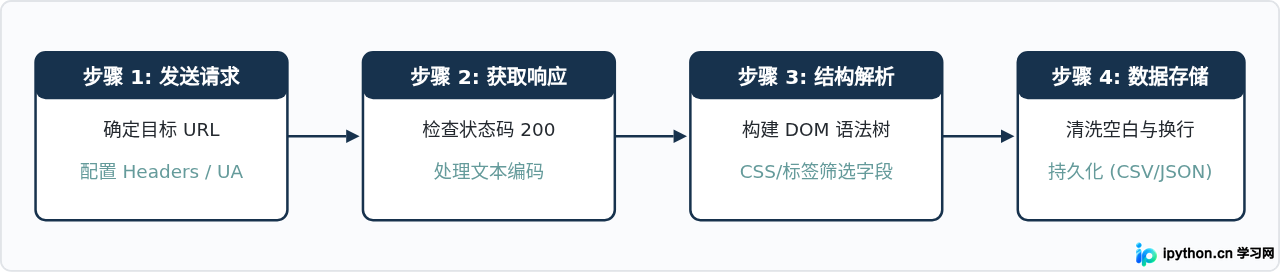
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
10-15
40




一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
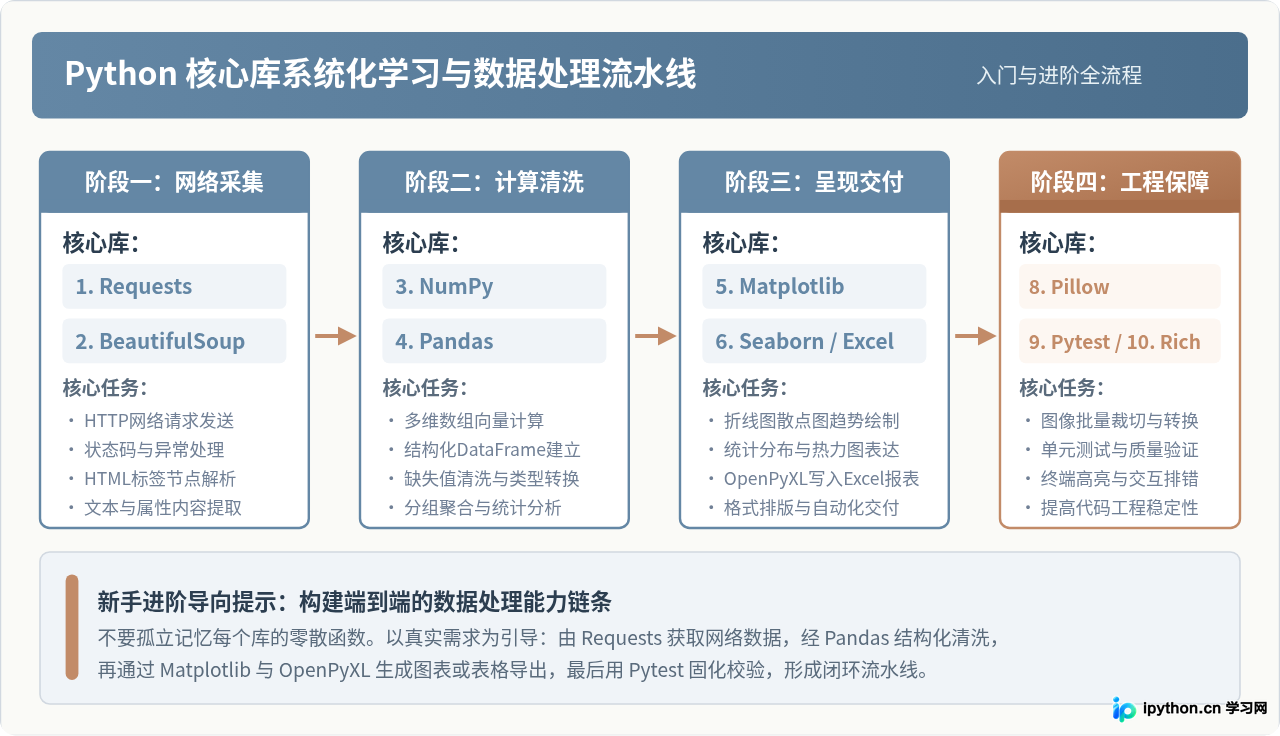
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
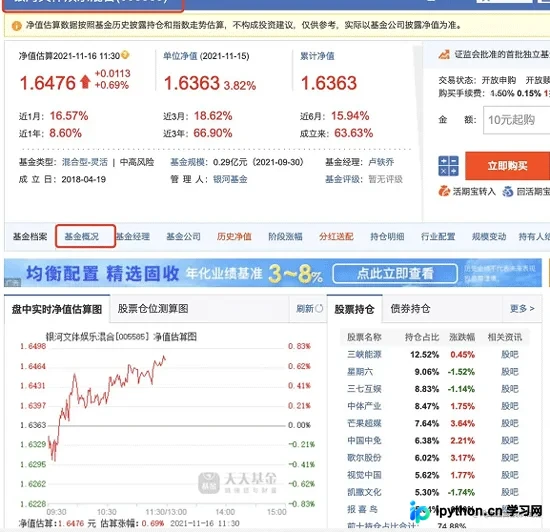
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
本文介绍如何利用Python的BeautifulSoup库批量从城市美食及景点介绍等HTML页面中提取body标签内的具体内容。通过遍历目录结构并解析文件,实现自动化数据抓取与存储,为后续数据处理提供基础。
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
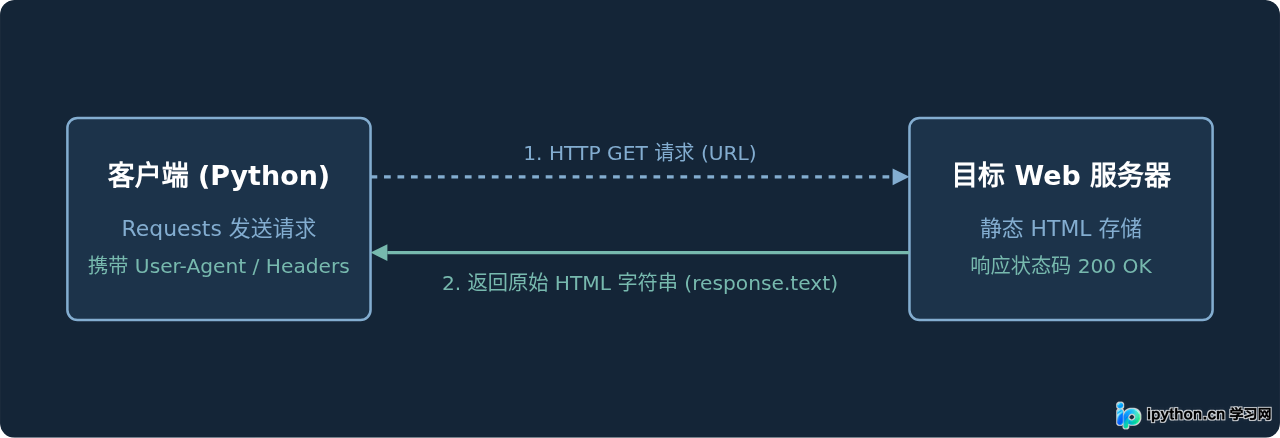
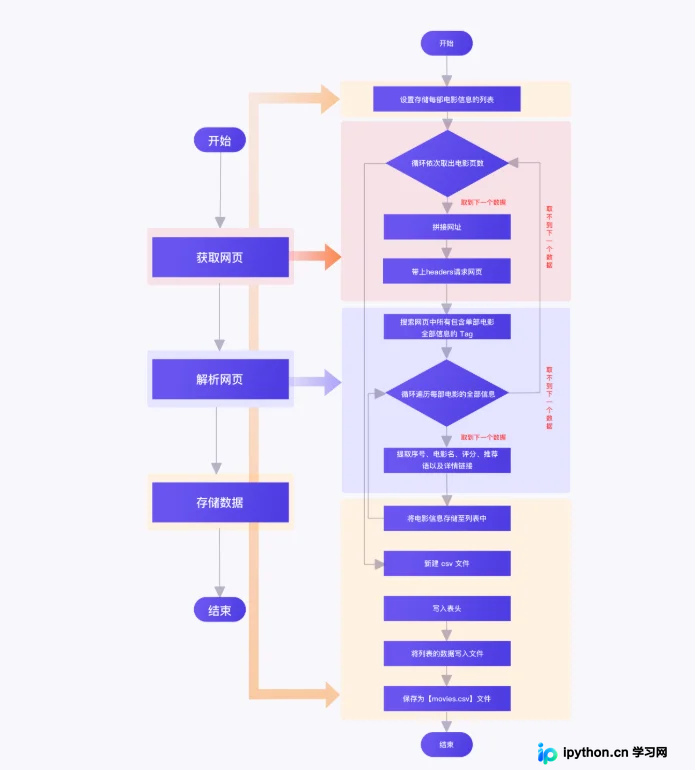
本文详细介绍如何使用Python爬取豆瓣电影Top100的数据。通过Requests库模拟浏览器请求,利用BeautifulSoup解析HTML结构提取电影信息,并采用CSV模块将结果持久化存储。文章涵盖网页规律分析、Headers设置、Robots协议检查及数据清洗存储等关键步骤,适合Python初学者学习网络爬虫基础。
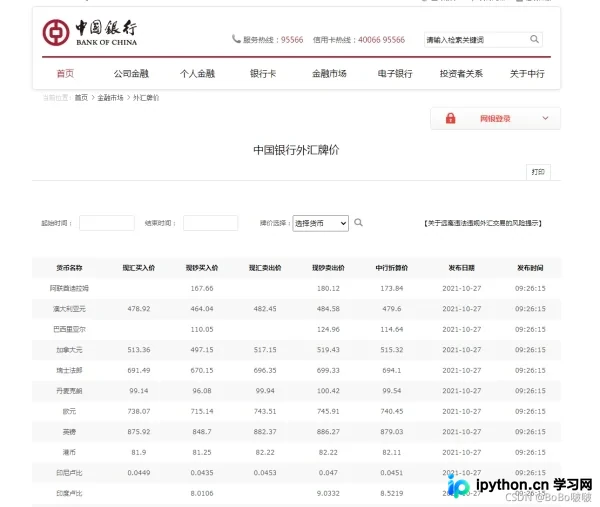
本文详解如何使用Python的requests、BeautifulSoup和xlwings库,从中国银行外汇牌价官网抓取实时数据。通过解析HTML表格提取关键信息,利用xlwings将数据写入Excel,并自动生成包含货币对价格的折线图,实现数据抓取、存储与可视化的完整流程。
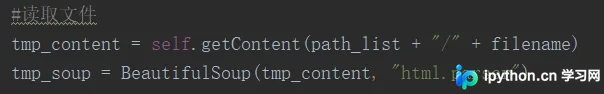
本文详解Python中BeautifulSoup库的基本用法,重点介绍如何通过html.parser读取本地HTML文件。内容涵盖使用select方法结合标签名与class属性(如div下的span)进行元素定位,以及利用find方法提取特定属性值。文章通过具体代码示例展示了如何获取ResultSet类型结果,帮助开发者快速掌握网页数据抓取的核心技巧。
本文详细介绍如何使用 Python 爬取吉首大学(JSU)的成绩单数据。教程涵盖环境配置(Python 3.5+、requests、BeautifulSoup4等)、通过浏览器开发者工具获取 Cookie 的方法,以及修改爬虫 URL 和运行 main.py 生成 CSV 文件的完整步骤。附带完整源码解析,帮助开发者快速掌握教务系统数据抓取技巧。

本文介绍使用Python和BeautifulSoup4编写简易爬虫,分别抓取开心网和豆瓣的个人日记。教程涵盖获取浏览器Cookie、配置请求头、处理HTML解析及文件保存等核心步骤,并提供完整代码示例与注意事项。
本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
本文介绍如何使用Python脚本绕过上学吧网站的验证码限制,自动获取题目详情与答案。通过构造随机X-Forwarded-For头信息规避IP检测,结合requests和BeautifulSoup库下载并解析验证码图片,用户只需手动输入计算结果即可实现免验证跳转查看内容。