PHP自动识别文本编码并转换的方法
在PHP开发中,处理未知来源的文本数据时,往往需要自动判断其是GBK还是UTF-8编码,以便进行统一转换。本文介绍了一种基于正则表达式特征匹配的高效检测方法,并结合mb_convert_encoding函数实现了从目标编码到指定编码(如GBK或UTF-8)的自动转换,解决传统iconv函数需预先知晓源编码的痛点。
10-13
6




在PHP开发中,处理未知来源的文本数据时,往往需要自动判断其是GBK还是UTF-8编码,以便进行统一转换。本文介绍了一种基于正则表达式特征匹配的高效检测方法,并结合mb_convert_encoding函数实现了从目标编码到指定编码(如GBK或UTF-8)的自动转换,解决传统iconv函数需预先知晓源编码的痛点。
本文解析PHP中将GB2312/GBK转换为UTF-8的方法。对比了高性能但需指定源编码的iconv函数,以及支持自动识别编码但性能稍低的mb_convert_encoding函数。提供了处理非法字符截断问题的方案,并演示了检测字符串编码后自动转换的代码示例。
本文解释 MySQL 中 utf8 仅支持最大3字节字符,无法存储4字节的 Emoji;而 utf8mb4 是完整的 UTF-8 实现。通过建表示例演示使用 utf8 导致插入含 Emoji 数据报错的原因及解决方案。
本文详细讲解了在PHP中如何正确处理包含中文等多字节字符的字符串截取。重点分析了原生substr函数导致的乱码问题,并提供了基于UTF-8正则匹配、GBK编码处理以及BugFree经典算法等多种解决方案,帮助开发者准确截断字符串并保留完整编码结构。
本文详解Python文件操作核心知识,涵盖ASCII、GBK到UTF-8的字符编码演变及Python2与Python3的差异。深入解析r、w、a及t、b模式的组合用法,介绍with语句的文件上下文管理。重点对比全量加载与逐行处理两种文件修改方式,并系统讲解无参、有参及空函数的定义规范与应用场景。
在开发短信网关或处理英文短信用户输入时,通常需要验证字符串是否符合GSM 7位编码标准。本文介绍使用正则表达式和内置过滤功能两种高效方法,替代低效的循环比对,确保输入的纯ASCII兼容字符符合通信协议要求。
本文提供多种 PHP 代码实现,用于准确判断字符串中是否包含中文、英文或数字。通过修正过时函数并优化正则逻辑,演示如何使用 preg_match 进行单一类型检测、混合内容分析及全汉字验证,适用于表单校验和数据处理场景。
当 PHP 环境未启用 mbstring 扩展时,处理 UTF-8、GBK 等多字节字符易出现乱码或截取不全。本文提供两套实用方案:第一套通过正则匹配统计中文字符长度并模拟 substr 进行安全截取;第二套封装支持 GB2312、GBK、UTF-8 和 Big5 编码的通用截取函数,自动添加省略号后缀,确保前端显示完整且无乱码。
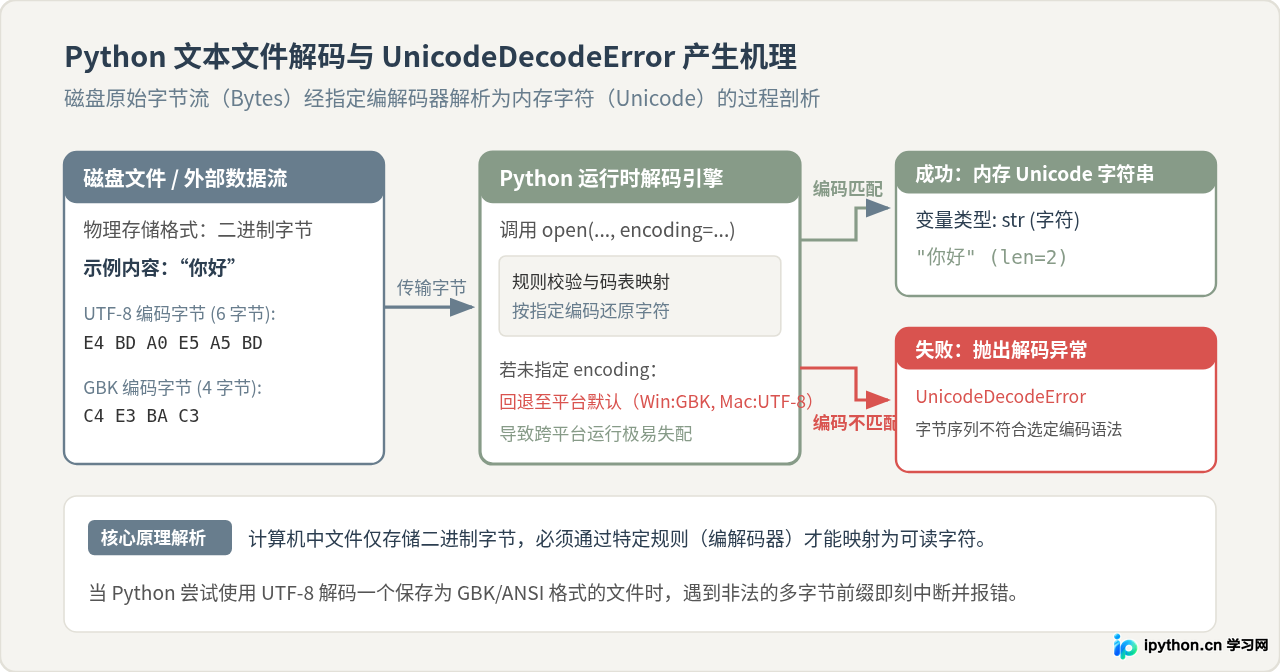
针对运行Python脚本时出现的UnicodeDecodeError编码错误,系统梳理报错原因、排查路径、修复方案及预防规范,帮助开发者彻底解决文本文件读写与终端输出中的字符解码异常。
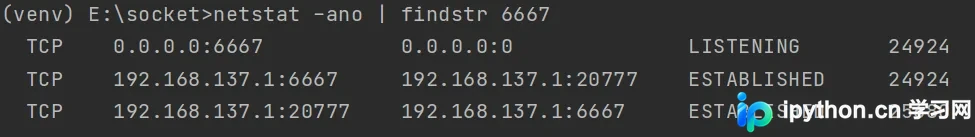
本文介绍基于Python Socket的TCP/IP网络通信基础,涵盖UTF-8与UTF-16编码的空间效率对比及适用场景。通过服务端与客户端代码示例,演示如何建立连接并执行远程系统命令,包括文件查看、目录管理及弹窗调用等具体操作,旨在提供技术层面的原理说明。
本文详解Python使用MySQLdb库插入中文数据时出现的乱码及数据未保存问题。通过设置连接参数charset为utf-8,并在插入前对字符串进行gbk到utf-8的编码转换,可有效解决乱码。同时强调执行插入语句后必须调用conn.commit()提交事务,否则断开连接后数据不会持久化。
本文深入解析 Python 字符编码机制,对比 Python2 与 Python3 在默认编码及内存处理上的差异,重点阐述 .py 文件头编码声明的作用。同时详细介绍文件处理的两种模式:字符方式(t)与二进制方式(b),强调 encoding 参数的使用场景及资源释放规范,帮助开发者避免乱码并高效管理文件资源。



