


MySQL中utf8与utf8mb4的区别及使用建议

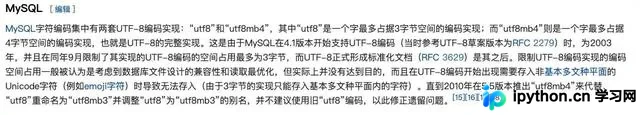
MySQL 中有两套名为 "utf8" 的字符集,其中默认的 utf8 仅支持最多3个字节,会导致包含 Emoji 或生僻字的插入报错。真正的完整 UTF-8 编码应使用 utf8mb4。
认识字符编码与字符集
字符集是文字、符号的集合,字符编码则是将这些字符转换为计算机可存储的二进制数据的规则。常见的字符集包括 ASCII、GB2312、GBK 等。
- ASCII:定义 128 个字符,主要用于英文,最高位为校验位,实际使用 7 位。
- GB2312/GBK:针对汉字设计的字符集,GBK 兼容 GB2312 并收录了更多汉字。
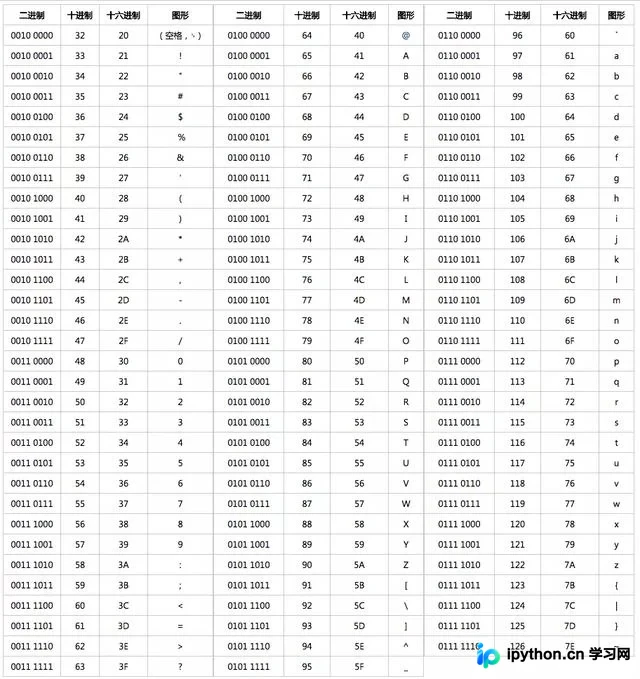
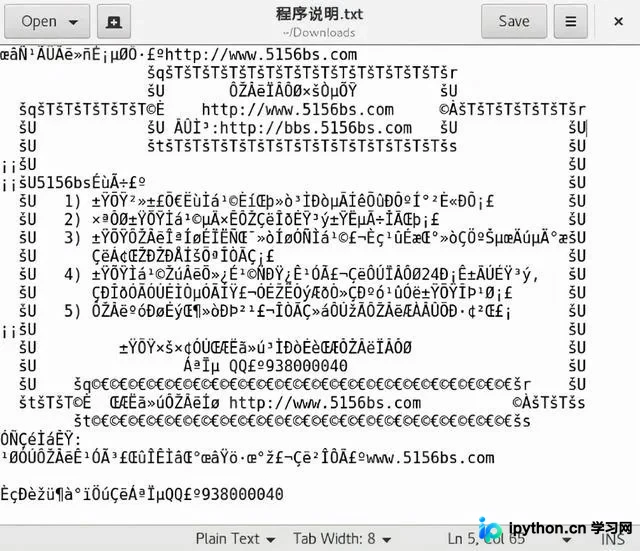
随着全球化的发展,不同编码体系间的转换常常引发乱码问题,因为同样的二进制序列在不同编码下代表不同的字符。
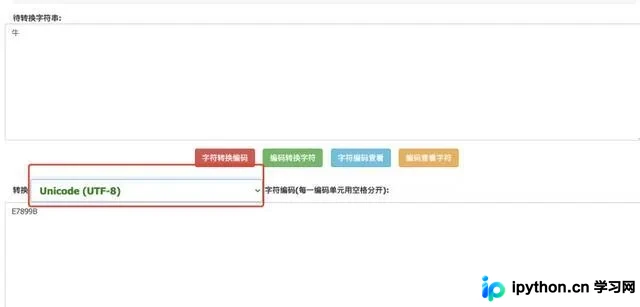
为解决此问题,Unicode 应运而生,它统一了全球所有字符的编码标准。而 UTF-8 则是 Unicode 的一种变长编码方式(其他还有 UTF-16、UTF-32),能根据字符自动选择 1 到 4 个字节进行存储。
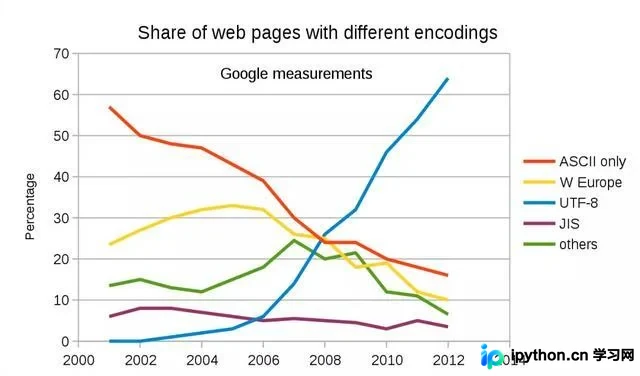
MySQL 中的“陷阱”:utf8 并非真 UTF-8
在 MySQL 中,开发者通常被建议使用 UTF-8 作为数据库默认编码,但 MySQL 中存在两个名字极易混淆的选项:
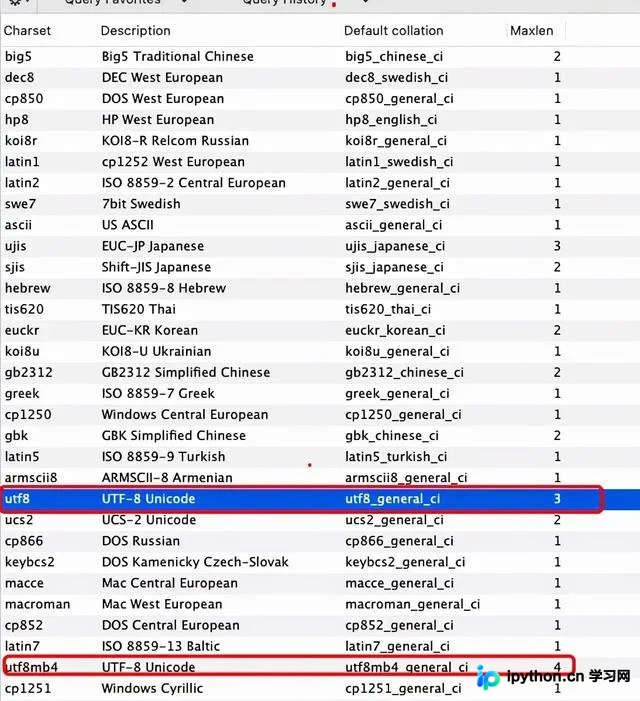
- utf8:这是 MySQL 的历史遗留命名,实际上它只支持最大 **3个字节** 的字符编码。这意味着它只能存储基本的多文种平面(BMP)字符,如常规的中英文。当遇到需要 4 个字节的字符时(如大部分 Emoji 表情、部分生僻繁体字),数据库将无法处理。
- utf8mb4:这才是对 UTF-8 标准的完全实现(mb4 即 most bytes 4)。它支持从 1 到 4 个字节的任意长度编码,可以完美存储 Emoji 和罕见汉字。
错误复现与正确实践
第1步:观察常见报错场景
如果在 MySQL 建表时使用了 CHARSET=utf8,尝试插入包含 Emoji 的数据时,通常会收到以下 SQL 异常:
Incorrect string value: '\xF0\x9F\x98\x98...' for column 'name' at row 1
F0 开头的十六进制串通常表示一个占用 4 个字节的数据,这证明了 utf8 在处理该列时的能力上限。
第2步:建立正确的表结构
为避免此类问题,在建表时应显式指定数据库或字段的字符集为 utf8mb4。
CREATE TABLE `user` (
  `id` varchar(66) CHARACTER SET utf8mb4 NOT NULL,
  `name` varchar(33) CHARACTER SET utf8mb4 NOT NULL,
  `phone` varchar(33) CHARACTER SET utf8mb4 DEFAULT NULL,
  `password` varchar(100) CHARACTER SET utf8mb4 DEFAULT NULL
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
注意参数:
- 推荐将表的默认引擎设置为
DEFAULT CHARSET=utf8mb4。 - 若表中字段可能包含中文或 Emoji,请确保对应字段的
CHARACTER SET也设为utf8mb4。
完成以上设置后,即可正常存储和检索包含 Emoji 等特殊字符的数据。以上就是关于 MySQL utf8 与 utf8mb4 区别的详细内容,更多关于 MySQL 字符集配置的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















