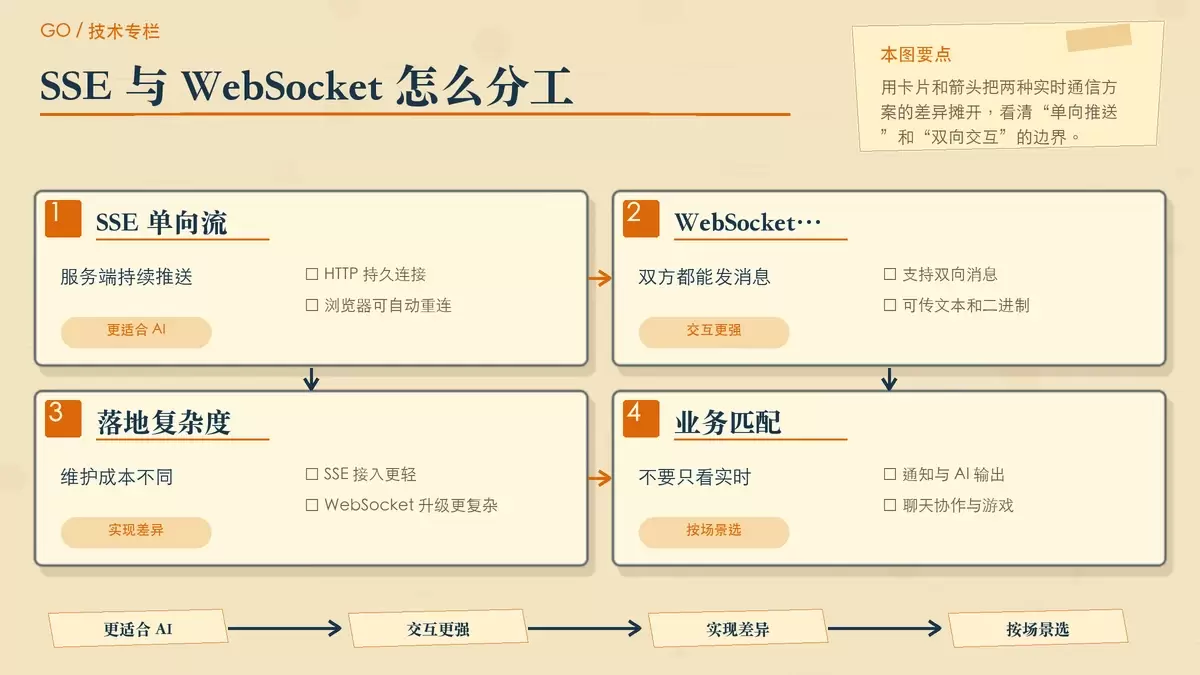
为什么说 SSE 是 AI 流式传输的“天作之合”?Go 开发者该怎么选
SSE 和 WebSocket 都能做实时通信,但在 AI 场景里,SSE 往往更贴近“边生成边输出”的产品需求。本文从通信模型、实现复杂度、Go 示例和 AI 流式接口实践几方面拆开说明,帮助你判断什么时候该优先选 SSE,什么时候该换成 WebSocket。
08-25
65




SSE 和 WebSocket 都能做实时通信,但在 AI 场景里,SSE 往往更贴近“边生成边输出”的产品需求。本文从通信模型、实现复杂度、Go 示例和 AI 流式接口实践几方面拆开说明,帮助你判断什么时候该优先选 SSE,什么时候该换成 WebSocket。
本文详解如何将Keras训练的模型转换为TensorFlow二进制格式(.pb),并解决直接转换导致的TensorFlow Serving加载失败问题。通过冻结会话生成常量图,再进一步转换为SavedModel格式,确保模型可在服务端正常推理部署。
本文深入解析Python中multiprocessing模块的多进程实现方式,涵盖Process类重写run、target传参及直接调用三种用法。重点对比Queue与Pipe在进程间通信(IPC)中的性能差异与应用场景,并通过数据清洗、模型推理等实际案例,展示如何利用进程池与异步通信机制高效处理高并发任务。
Google发布的TensorFlow物体检测API提供了预训练模型及重新训练脚本,助力快速构建图像检测应用。本文详解如何载入预训练的SSD MobileNet模型,配置环境,下载并加载冻结图,映射标签,并通过辅助代码实现图像检测与可视化,帮助用户在30秒内上手物体检测任务。
本文介绍如何将Keras模型转换为TensorFlow的.pb格式,以便进行前端部署。同时涵盖将模型进一步转换为移动端友好的TFLite文件的方法。文章提供了基于TensorFlow 1.12.0和Python 3.6.5环境的完整代码示例,包括模型冻结、变量名处理及常见报错排查。
从TypeScript类型推断的基本机制出发,理解上下文类型如何影响表达式推断,并进一步掌握条件类型中的类型判断、分发与推断技巧,最后通过实际代码验证常见场景并规避类型推断失效与过度复杂的问题。
本文总结了一次Python服务内存泄漏的完整排查过程。通过对比新旧代码与依赖,锁定异常处理逻辑为根源:全局异常实例未回收导致内存持续攀升。文章详细演示了如何利用objgraph和pympler等工具定位泄漏变量,并通过traceback调用链分析确认问题,最终提供修复方案及进阶排查思路。
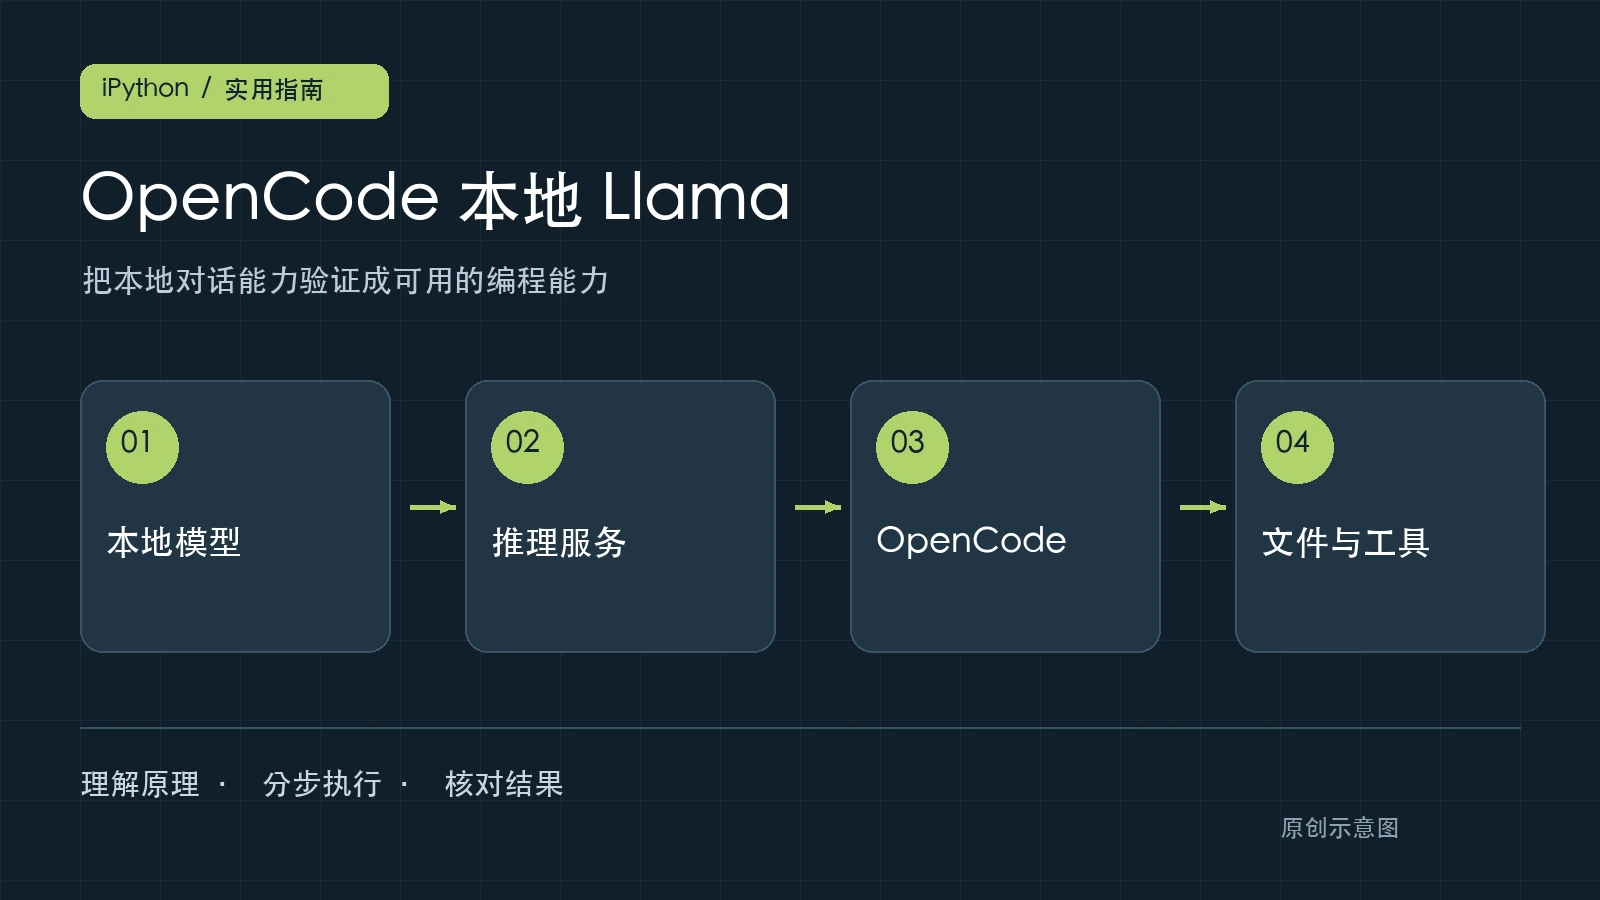
让 OpenCode 使用本地 Llama,需要同时解决两个问题:本机是否能稳定运行目标模型,以及模型是否能正确执行编程工具调用。只看到一句流畅回答,还不足以判断它能处理真实代码任务。
Python的价值并不局限于网站后端开发。在数据分析、自动化办公、科学计算、人工智能、网络运维、测试与桌面工具等场景中,Python同样具备较高的实用性。本文从应用场景、适用条件、实际落地和常见误区几个方面,梳理那些容易被低估的Python用途。