



在聊天机器人、代码补全、智能客服这类 AI 应用里,用户往往不愿意等模型“整段生成完”再一次性返回结果,大家更在意首个字符能不能尽快出现。要回答为什么很多 AI 产品偏爱 SSE,不能只看“能不能实时”,还得看通信方向、接入成本、浏览器支持和 Go 服务端实现复杂度。本文会把 SSE 与 WebSocket 放在同一张桌子上比较,再结合 Go 示例说明:哪些场景 SSE 足够好,为什么它会成为 AI 流式输出里常见的一种实现。
实时通信的关键,不只是快
现代 Web 应用对“实时”的要求早就不局限于即时聊天。在线协作、监控告警、消息通知、AI 对话,都在推动通信方式从传统的请求-响应,转向更低延迟、更持续的数据传输模式。
传统 HTTP 最大的问题不是不能传数据,而是服务器必须等客户端先发起请求。在需要持续更新内容的场景里,这会让实现变得低效:要么频繁轮询,要么改成长轮询,连接和状态管理都会越来越重。
SSE 和 WebSocket 的出现,正是为了解决这类问题。两者都能把“服务端有数据就立刻发出去”这件事做得更自然,但路线并不相同:一个更贴近 HTTP 生态,一个更适合高频双向交互。
SSE 是什么,为什么它适合流式输出
它解决的是服务端单向推送
SSE(Server-Sent Events)是一种基于 HTTP 的服务器推送技术。它的核心思路很直接:客户端建立一个持续连接,之后由服务器不断往这个连接里写入文本事件。
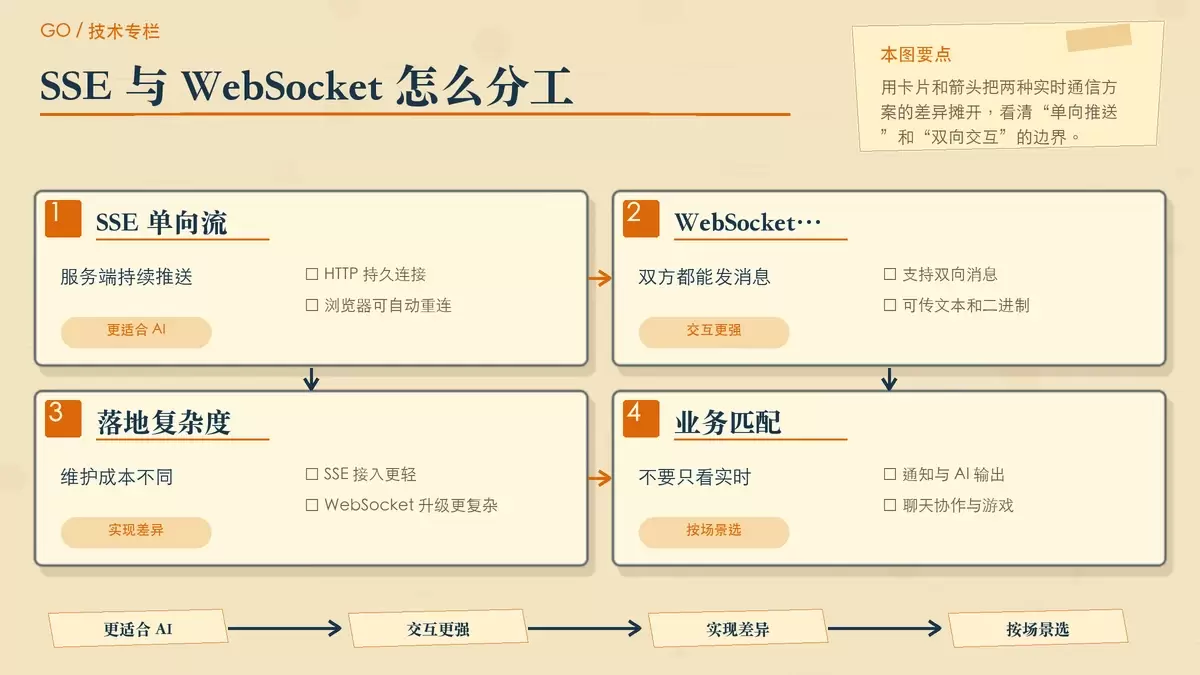
它有几个很适合资讯流、通知流、AI 输出流的特点:
- 单向通信:只负责服务器向客户端发数据
- 基于 HTTP:通常不需要额外协议栈,基础设施更容易复用
- 自动重连:连接断开后,浏览器侧通常会自动尝试恢复
- 文本友好:天然适合消息片段、状态更新、JSON 文本块
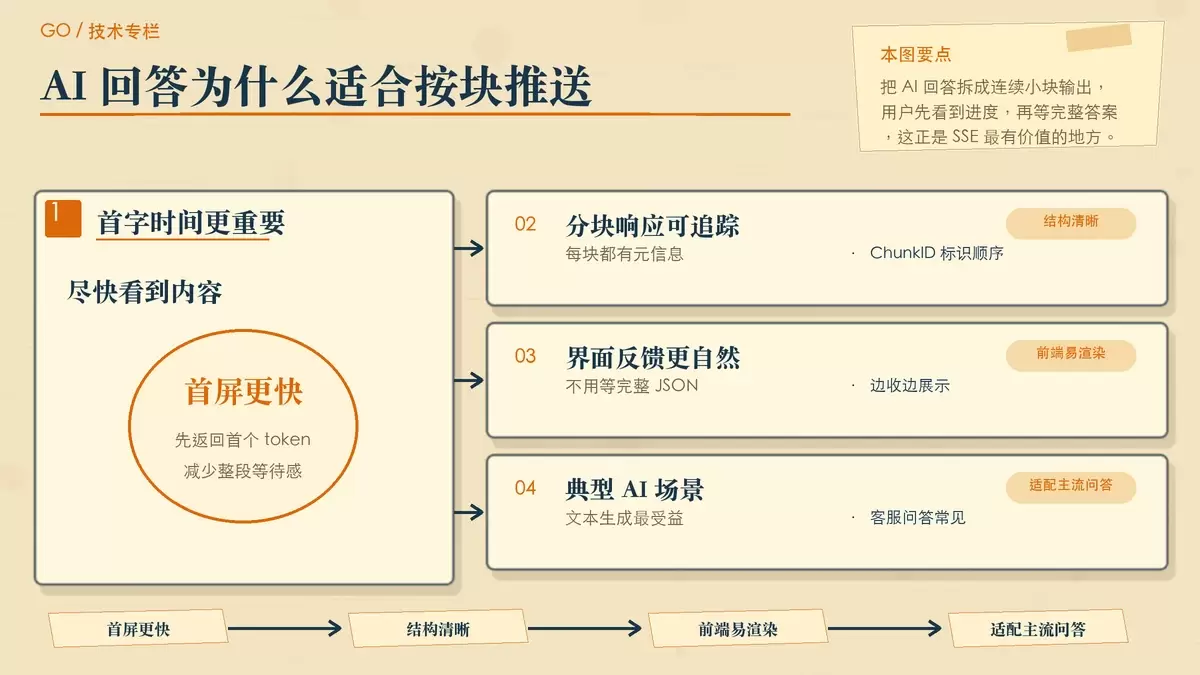
这也解释了它为什么经常出现在 AI 产品里。大多数聊天型 AI 交互,真正高频传输的一侧其实是服务端:模型一边生成 token,一边往前端推。客户端虽然会发起提问,但在回答生成阶段并不需要持续双向对话。
Go 里怎么实现一个基础 SSE 接口
SSE 的服务端实现并不复杂,重点在于设置正确的响应头,并在每次写出数据后及时刷新缓冲区。
package main

import (
    "fmt"
    "log"
    "net/http"
    "time"
)

func sseHandler(w http.ResponseWriter, r *http.Request) {
    // 设置SSE必需的响应头
    w.Header().Set("Content-Type", "text/event-stream")
    w.Header().Set("Cache-Control", "no-cache")
    w.Header().Set("Connection", "keep-alive")

    flusher, ok := w.(http.Flusher)
    if !ok {
        http.Error(w, "Streaming unsupported", http.StatusInternalServerError)
        return
    }

    // 模拟实时数据推送
    for i := 0; i < 10; i++ {
        data := fmt.Sprintf("当前时间: %v", time.Now().Format("15:04:05"))
        fmt.Fprintf(w, "data: %snn", data)
        flusher.Flush()
        time.Sleep(1 * time.Second)
    }
}

func main() {
    http.HandleFunc("/events", sseHandler)
    log.Println("SSE服务器运行在 http://localhost:8080")
    log.Fatal(http.ListenAndServe(":8080", nil))
}
这段代码已经把 SSE 的核心动作展示出来了:
- 响应头声明这是一个
text/event-stream - 通过
http.Flusher强制把当前数据立即发给客户端 - 服务端维持连接,在循环里持续输出内容
换句话说,SSE 并不是“更高级的 WebSocket 替代品”,它只是针对“服务端持续推送文本数据”这个目标,提供了一条更短的实现路径。
WebSocket 很强,但问题在于你是否真的需要它
WebSocket 的优势在双向和高频交互
WebSocket 提供的是全双工通信。连接建立之后,客户端和服务器都可以主动发送消息,不再受限于传统 HTTP 请求-响应模型。
它的典型优势包括:
- 双向通信:两端都能主动发消息
- 低延迟:连接建立后,后续通信开销较小
- 支持二进制:适合图片、音频等非文本内容
- 高频互动能力强:适合聊天室、协同编辑、在线游戏
Go 里常见的做法是借助 github.com/gorilla/websocket 处理升级和收发消息:
package main

import (
    "log"
    "net/http"
    "github.com/gorilla/websocket"
)

var upgrader = websocket.Upgrader{
    CheckOrigin: func(r *http.Request) bool { return true },
}

func websocketHandler(w http.ResponseWriter, r *http.Request) {
    conn, err := upgrader.Upgrade(w, r, nil)
    if err != nil {
        log.Println("WebSocket升级失败:", err)
        return
    }
    defer conn.Close()

    for {
        // 读取客户端消息
        messageType, message, err := conn.ReadMessage()
        if err != nil {
            log.Println("读取错误:", err)
            break
        }

        // 处理并回复消息
        response := "服务器回复: " + string(message)
        err = conn.WriteMessage(messageType, []byte(response))
        if err != nil {
            log.Println("写入错误:", err)
            break
        }
    }
}

func main() {
    http.HandleFunc("/ws", websocketHandler)
    log.Fatal(http.ListenAndServe(":8080", nil))
}
如果你的业务本质上需要客户端频繁上行消息,或者需要传输二进制内容,WebSocket 的确更顺手。但很多团队在 AI 输出场景里一上来就选 WebSocket,往往并不是因为它最合适,而是因为它“看起来更实时”。
SSE 和 WebSocket 到底该怎么选
| 特性 | WebSocket | SSE |
|---|---|---|
| 通信模式 | 双向通信 | 单向通信(服务器→客户端) |
| 协议基础 | 独立WebSocket协议 | HTTP协议 |
| 数据格式 | 文本和二进制 | 仅文本 |
| 自动重连 | 需手动实现 | 内置支持 |
| 实现复杂度 | 相对复杂 | 简单易用 |
| 浏览器兼容性 | 现代浏览器支持良好 | 现代浏览器支持良好 |
| 适用场景 | 聊天、游戏、实时协作 | 实时通知、数据流、AI推送 |
可以把判断标准压缩成一句话:
- 如果核心需求是“服务端不断把文本结果往前端送”,优先看 SSE
- 如果核心需求是“双方都要频繁说话,甚至要传二进制”,再选 WebSocket
更具体一点,下面这些情况更适合 SSE:
- 主要是服务器向客户端推送数据
- 希望尽量复用现有 HTTP 基础设施
- 传输内容以文本为主
- 想快速上线,降低实现和维护复杂度
- 希望直接利用自动重连能力
而以下场景更偏向 WebSocket:
- 需要真正意义上的双向持续通信
- 要传图片、音频等二进制数据
- 高频交互且对延迟非常敏感
- 业务过程不是“推送结果”,而是“持续会话”
为什么 AI 流式传输常常首选 SSE
AI 输出最需要的是“尽快看到第一段结果”
大语言模型的生成过程天然是分段完成的。无论是 token、句子片段还是结构化 JSON 块,后端通常都不是一次性拿到完整结果,而是逐步收到模型输出。
如果还沿用普通 HTTP 的一次性响应模式,用户只能等模型全部生成结束后再看到内容。回答一长,等待就会被放大,产品体验也会明显变差。
SSE 在这里的价值,不在于“它能实时”,而在于它和 AI 生成链路的节奏非常一致:
- 模型生成一点,就可以推一点
- 前端能更早展示首个 token 或首句文本
- 用户可以感知到系统正在工作,而不是页面长时间静止
- 服务端实现成本相对可控,不必为单向流输出搭建完整双工通道
这就是它被称为 AI 流式传输“天作之合”的原因。很多 AI 交互本质上是一种“请求一次,结果流式返回”的模式,真正持续高频输出的是模型侧,而不是用户侧。
典型场景:客服、问答、代码生成
在智能客服里,用户往往更在意系统有没有立即回应。哪怕完整答案需要几十秒,能先看到“思考中”或前几句回复,体感也会完全不同。
在问答产品里,SSE 让前端可以边收边渲染,尤其适合长回答、知识整理、摘要生成这类内容型任务。
在代码生成和补全工具里,流式推送同样重要。开发者并不总是要等整段代码彻底生成完成,很多时候只要建议足够早出现,就能开始判断是否采用。像 GitHub Copilot 这类工具强调的,就是这种“尽早反馈”的编码体验。
Go 里如何实现 AI 流式输出接口
下面这段示例用 Gin 模拟了一个 AI 聊天接口,把结果按块推送到客户端:
package main

import (
    "encoding/json"
    "fmt"
    "github.com/gin-gonic/gin"
    "time"
)

type AIResponse struct {
    Token     string `json:"token"`
    ChunkID   int    `json:"chunk_id"`
    IsEnd     bool   `json:"is_end"`
    Timestamp int64  `json:"timestamp"`
}

func aiStreamHandler(c *gin.Context) {
    c.Header("Content-Type", "text/event-stream")
    c.Header("Cache-Control", "no-cache")
    c.Header("Connection", "keep-alive")

    prompt := c.Query("prompt")
    if prompt == "" {
        prompt = "默认问题"
    }

    // 模拟AI流式响应
    responses := []string{"思考中", "我正在分析", "您的问题", "答案是..."}

    for i, chunk := range responses {
        response := AIResponse{
            Token:     chunk,
            ChunkID:   i + 1,
            IsEnd:     i == len(responses)-1,
            Timestamp: time.Now().Unix(),
        }

        jsonData, _ := json.Marshal(response)
        fmt.Fprintf(c.Writer, "data: %snn", string(jsonData))
        c.Writer.Flush()

        time.Sleep(500 * time.Millisecond) // 模拟AI处理时间
    }
}

func main() {
    router := gin.Default()
    router.GET("/ai/chat", aiStreamHandler)
    router.Run(":8080")
}
这段实现透露出几个很关键的设计点:
- 接口仍然是普通 HTTP 路由,例如
/ai/chat - 返回内容是连续的事件流,而不是一次性 JSON
- 每个 chunk 都可以带上
ChunkID、IsEnd、Timestamp之类的元信息 - 前端可以按块渲染,也可以根据结束标记做收尾处理
对于多数文本类 AI 产品,这样的接口模型已经足够实用,而且更贴近现有 Web 服务体系。
Go 落地时要注意哪些性能、容错和安全问题
性能优化先看连接管理和数据节奏
SSE 看起来简单,但真正上线后,问题往往出在连接数量、刷新频率和内存压力上。尤其是 AI 接口,一次回答可能持续几十秒,如果并发上来,连接管理就不能太粗糙。
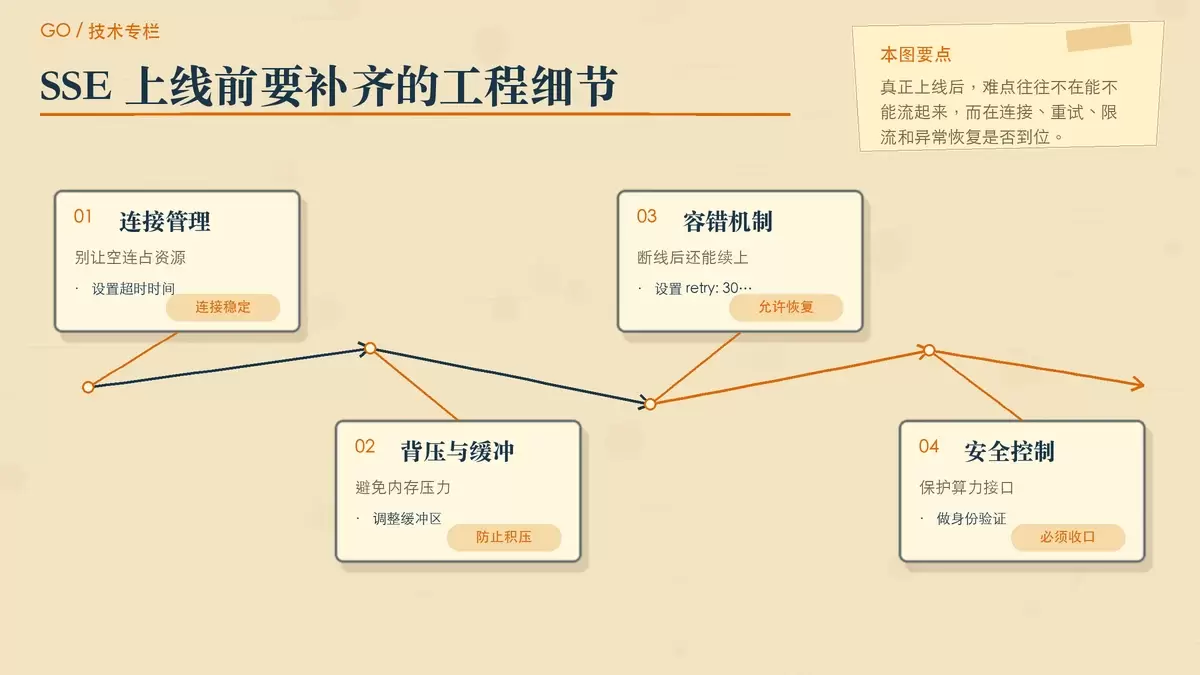
常见优化点包括:
连接管理:
- 合理设置超时时间,避免资源浪费
- 实现连接池管理,复用现有连接
- 使用心跳机制保持连接活跃
数据处理:
- 对文本数据启用压缩
- 合理设置缓冲区大小
- 实现背压控制,避免内存溢出
对 AI 流式接口来说,另一个容易忽视的点是 chunk 粒度。切得太碎,前端会频繁刷新,服务端写出压力也会增大;切得太大,又会失去“流式反馈”的意义。这个粒度应该结合模型输出速度和前端渲染策略一起调。
错误处理不能只停留在能跑通
SSE 的连接可能被浏览器、代理层、移动网络中途打断,所以错误处理和恢复机制必须提前考虑。
// 增强的错误处理机制
func robustSSEHandler(w http.ResponseWriter, r *http.Request) {
    w.Header().Set("Content-Type", "text/event-stream")

    flusher, _ := w.(http.Flusher)

    // 设置重试时间
    fmt.Fprintf(w, "retry: 3000nn")
    flusher.Flush()

    defer func() {
        if r := recover(); r != nil {
            log.Printf("SSE处理异常: %v", r)
        }
    }()

    // 业务逻辑...
}
这段示例里至少体现了两个方向:
- 通过
retry: 3000告诉客户端断开后的重试间隔 - 通过
recover()兜住处理过程中的异常,避免整个请求链路直接失控
实际项目里,通常还要补上日志追踪、客户端断开检测、上游模型超时处理、流结束标记规范化等机制。否则接口看似能流式返回,实际一遇到网络抖动或模型阻塞就很难排查。
安全问题同样不能省
流式接口并不意味着可以弱化安全控制。相反,因为连接持续时间更长,资源占用更明显,滥用风险往往更高。
- 使用HTTPS:防止中间人攻击
- 身份验证:实现严格的访问控制
- 输入验证:防止注入攻击
- 速率限制:防止滥用和DDoS攻击
尤其在 AI 场景里,SSE 接口通常直接连接模型推理资源,成本不只是带宽,还有算力。如果没有限流和鉴权,接口暴露后的风险会比普通查询接口更大。
结论:AI 场景下,SSE 常常是更合适而不是更强大
SSE 和 WebSocket 都是成熟的实时通信方案,差别不在“谁更先进”,而在业务需要什么样的通信模型。
如果你的系统本质上是服务器持续向前端推送文本结果,例如 AI 对话、内容生成、实时通知、状态流更新,那么 SSE 通常更贴合需求:实现轻、接入顺、HTTP 友好,还有自动重连能力。
如果你的业务强调双向高频互动,或者必须传输二进制数据,例如在线协作、游戏、音视频互动,那么 WebSocket 依旧是更稳妥的选择。
放到 AI 产品里看,很多场景真正需要的不是一个“万能实时通道”,而是一条能把模型生成结果稳定、连续、尽快送到用户面前的链路。从这个角度说,SSE 的优势并不花哨,但非常实用,这也是它在 AI 流式输出里越来越常见的原因。
技术选型的关键,不是追求最强,而是先确认通信方向、数据类型、交互频率和交付成本,再决定用 SSE 还是 WebSocket。















