Python多进程fork()函数详解与跨平台实现
本文深入解析Python中os.fork()函数的运行机制,阐述其在Unix/Linux系统下“调用一次返回两次”的特性及父子进程ID获取方式。同时介绍Apache服务器等典型应用场景,并针对Windows系统无fork接口的情况,详细讲解如何利用multiprocessing模块实现跨平台的多进程开发,涵盖Process类的使用及进程间通信基础。
10-13
7




本文深入解析Python中os.fork()函数的运行机制,阐述其在Unix/Linux系统下“调用一次返回两次”的特性及父子进程ID获取方式。同时介绍Apache服务器等典型应用场景,并针对Windows系统无fork接口的情况,详细讲解如何利用multiprocessing模块实现跨平台的多进程开发,涵盖Process类的使用及进程间通信基础。
本文详解Python中multiprocessing.Pool的apply_async方法,阐述其异步非阻塞特性及提升执行效率的原理。针对多参数传递问题,提供通过封装函数或使用starmap/starmap_async解决Map和Apply异步调用的具体代码示例,帮助开发者高效实现进程并行计算。
本文分析Python multiprocessing模块中调用类内函数时触发的PicklingError错误。由于原生pickle仅支持顶层定义的对象,类方法无法被序列化导致报错。通过引入pathos库(基于dill)或手动实现序列化,可有效解决该问题,实现类方法的并行处理。
本文介绍Python中multiprocessing模块的Pool进程池用法。通过创建指定数量的进程池,利用apply_async进行异步任务提交,配合close和get方法获取结果。示例展示了100个任务在25个进程中的执行情况及进程状态查看。
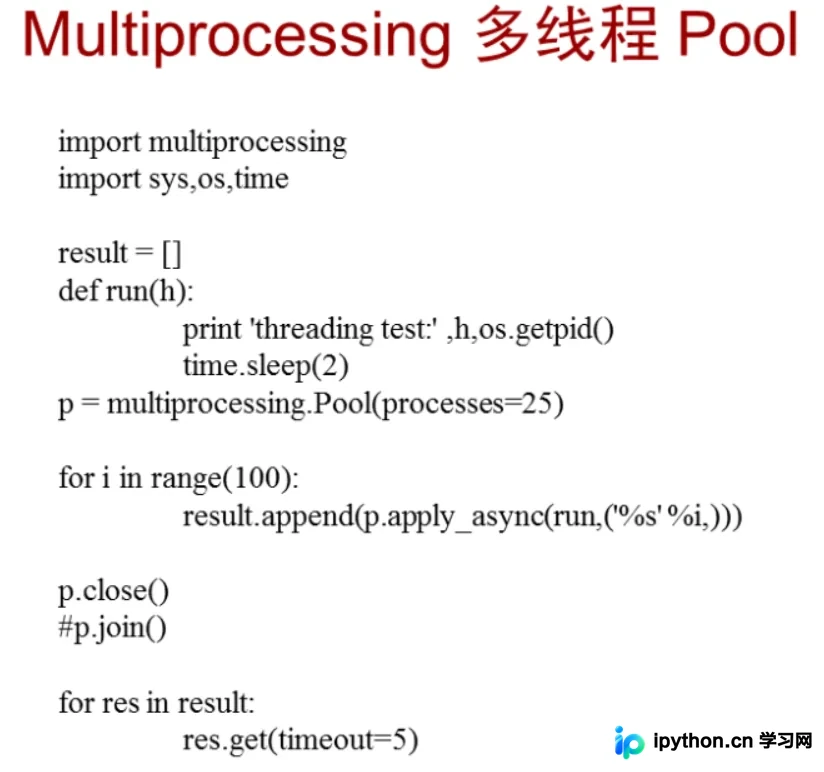
本文通过四个具体示例,深入解析Python中multiprocessing模块Pool.map()方法的执行实质。重点探讨进程池大小、任务耗时对总执行时间的影响,以及输入列表顺序与输出结果的一一对应关系。通过对比不同场景下的运行日志,阐明Pool.map按序分发任务且保持结果顺序的核心特性,帮助开发者优化多进程编程策略。
本文详细介绍Python3中multiprocessing模块的核心组件,包括Process类的创建与同步、Pool进程池的apply_async与apply方法对比、Queue进程间通信的put/get机制及参数设置,以及Pipe双向通信的实现。通过代码示例解析各组件特性与适用场景,帮助开发者高效实现并发编程。
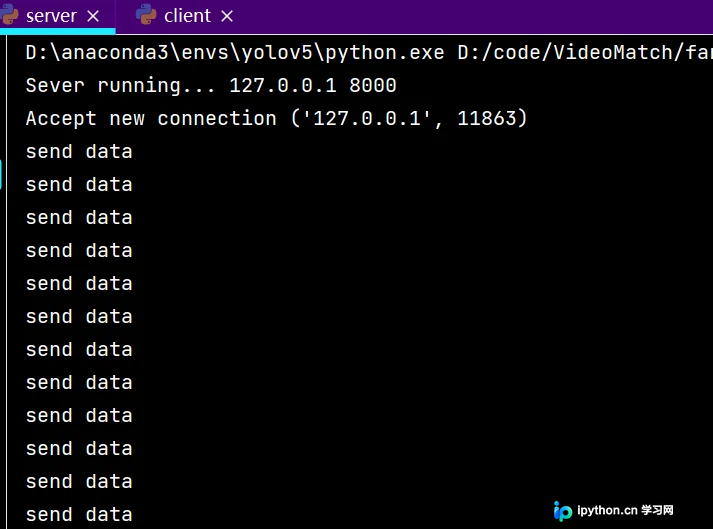
本文介绍如何使用Python的multiprocessing模块实现跨进程通信。通过封装Server端和Client端代码,展示基于监听器和客户端连接的交互流程。示例包含完整的接收、发送及异常处理逻辑,适用于字符串、数字等多种数据类型的跨文件通信场景。
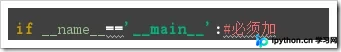
本文详解Python中利用multiprocessing模块的Process类创建新进程的两种方法:直接实例化与继承子类。重点解析构造参数、run方法重写及__main__判断的必要性,对比两种方式的优劣,推荐直接使用Process类实例化方式。
本文详解Python中使用multiprocessing.Pool时的关键注意事项。重点说明Pool必须在__main__下调用,多进程内异常默认被静默跳过且需手动捕获记录,以及数据通过参数传入或全局变量(只读)传递的正确方式。
本文分析Python多线程编程中常见的AttributeError: Can't pickle local object错误。该错误通常由在类属性中初始化不可序列化的对象(如HTTPDigestAuth)引起。通过修改代码,将认证逻辑移至方法内部而非实例属性,可有效解决序列化失败问题,确保多线程池正常运行。
本文深入解析Python中multiprocessing模块的使用,涵盖进程创建、继承Process类及常用API。重点讲解进程池Pool的串行与并行执行、回调函数机制,以及close和join的正确调用顺序,通过代码实例帮助开发者高效实现并发编程。
本文介绍Python中multiprocessing模块的多进程编程方法。通过具体代码实例,演示如何创建独立进程、获取进程ID,以及使用进程池Pool进行任务管理。内容涵盖Process类的基础用法和Pool池的高级特性,帮助开发者掌握Python并发编程的核心技巧。



