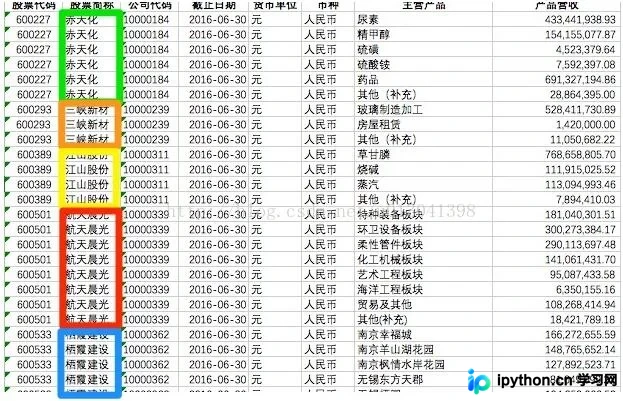
pandas中df.groupby()方法深入讲解
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
10-16
12




本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详细介绍Python Pandas库中groupby分组函数与agg聚合函数的使用方法。通过具体代码示例,演示如何按单列或多列进行分组统计,包括计算均值、标准差及自定义聚合。同时讲解如何利用transform保持原始索引结构,以及如何利用cut进行数据分箱分组,帮助开发者高效处理复杂数据分析任务。
本文介绍如何利用Python Pandas库中的cumsum函数,结合groupby操作,实现按用户ID分组统计历史累计安装次数。通过具体数据集示例,演示从数据分组到计算累加值的全过程,帮助开发者快速掌握累计统计技巧。
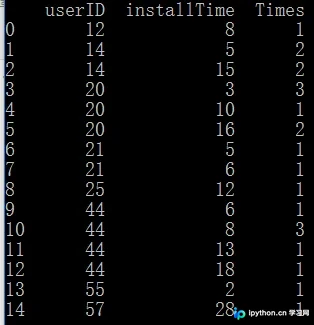
本文介绍在Python数据处理中,如何使用Pandas库的groupby结合shift函数对指定列进行向上或向下平移操作。通过调整shift参数的正负值控制偏移方向,缺失值自动填充为NaN,相比传统循环方式更加高效便捷,适用于基于分组的错位相加减场景。
本文详解pandas中rolling函数的核心参数与用法。重点解析window类型(int与offset)、min_periods、center及closed等关键配置,并通过物流场景示例,展示如何结合groupby实现基于时间的滚动聚合计算,提供高效的数据处理方案。
本文详细介绍Pandas中GroupBy对象的几种核心索引与迭代方法。通过GroupBy.iter()可遍历分组,返回组名与子DataFrame;groups属性展示组名及对应索引列表;indices返回类似但为数组形式;get_group()用于提取特定分组数据。结合示例代码,帮助开发者高效处理分组数据。
本文介绍在Python中如何识别列表内的连续数字范围并进行分块处理。针对已排序的连续数字,利用itertools.groupby结合枚举索引差值进行分组;针对非连续或未排序数据,先执行排序(如冒泡排序)再应用相同逻辑。文章提供了完整代码示例,展示如何提取连续区间并格式化输出范围字符串,适用于数据清洗与区间分析场景。
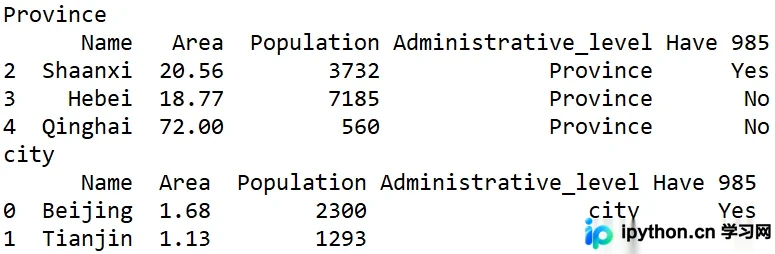
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。
本文介绍如何在pandas中使用groupby进行分组统计后,按照自定义的特定顺序输出结果。通过定义索引列表并应用于groupby对象,可确保数据按期望顺序排列,进而生成符合逻辑的柱状图,便于后续对比分析与绘图展示。
本文深入解析pandas中agg与apply函数的区别。agg专用于聚合运算,将一维数组简化为标量;而apply更通用,支持排序等无法简化的自定义操作。两者均作用于groupby对象,理解其适用场景有助于提升数据处理效率。
本文介绍如何在pandas中结合groupby和sort_values对DataFrame进行分组后排序。通过示例展示利用groupby分组后,使用nlargest方法获取各组最大值或Top N记录的技巧,适用于需要按多个维度统计并排序的场景。
本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。