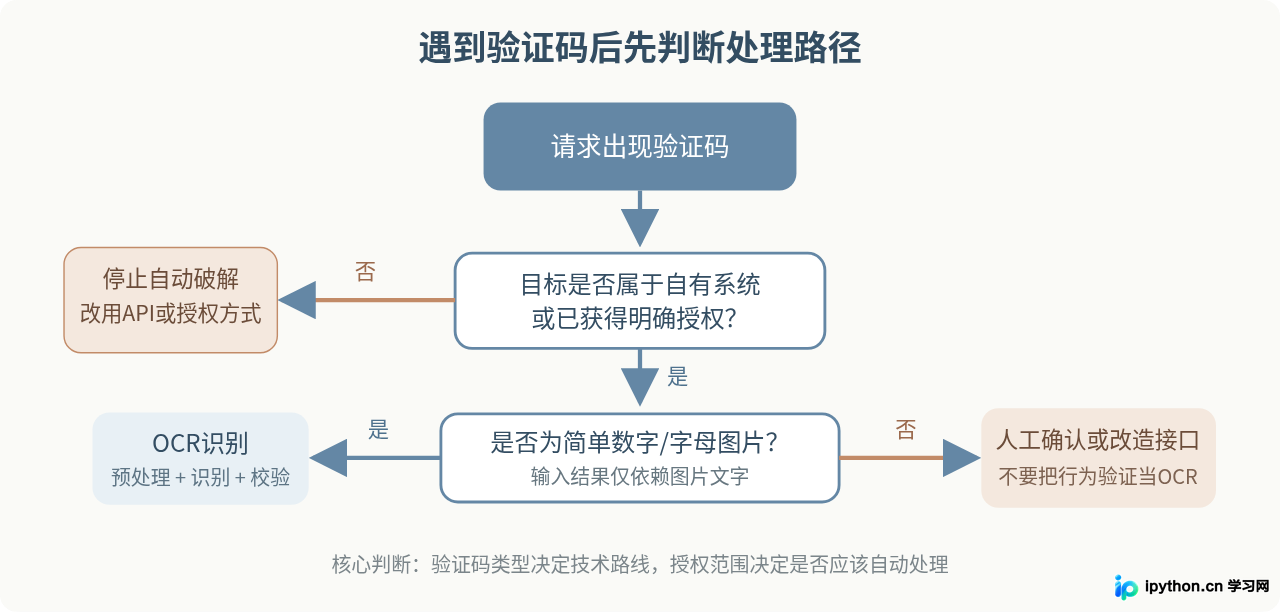
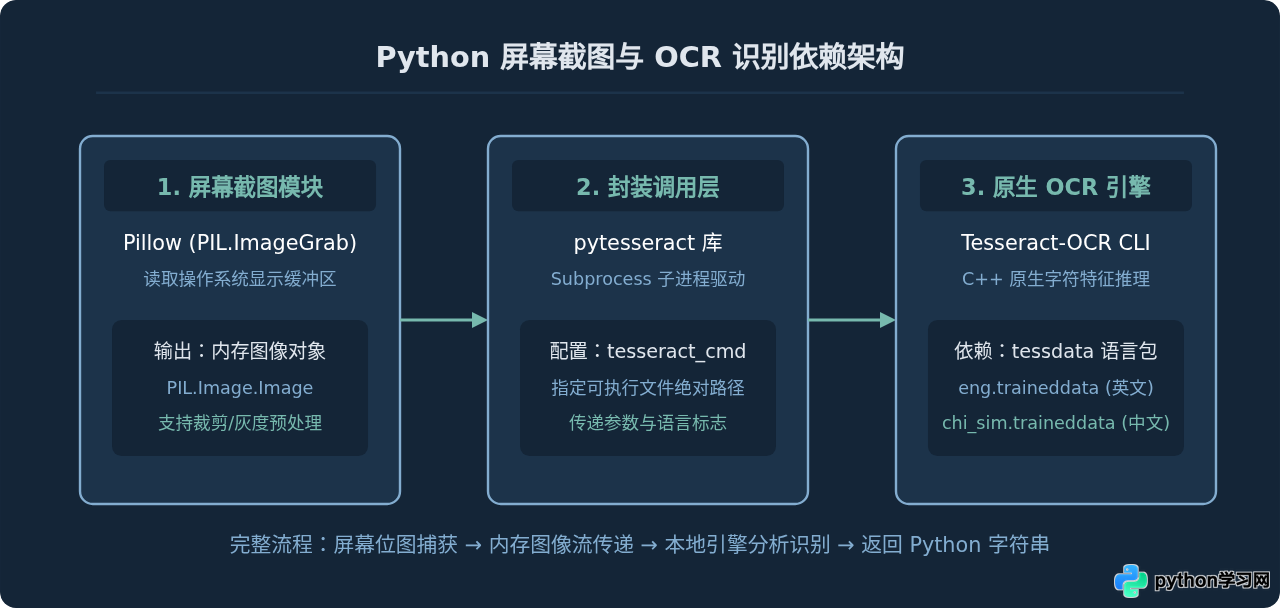
Python实现截图与OCR识别:pytesseract基础代码示例
介绍如何使用Python的Pillow库进行屏幕截图,并结合pytesseract与Tesseract-OCR引擎实现文字识别,包含环境配置、全屏与局部截图识别代码示例及常见问题排查。
10-30
25




介绍如何使用Python的Pillow库进行屏幕截图,并结合pytesseract与Tesseract-OCR引擎实现文字识别,包含环境配置、全屏与局部截图识别代码示例及常见问题排查。
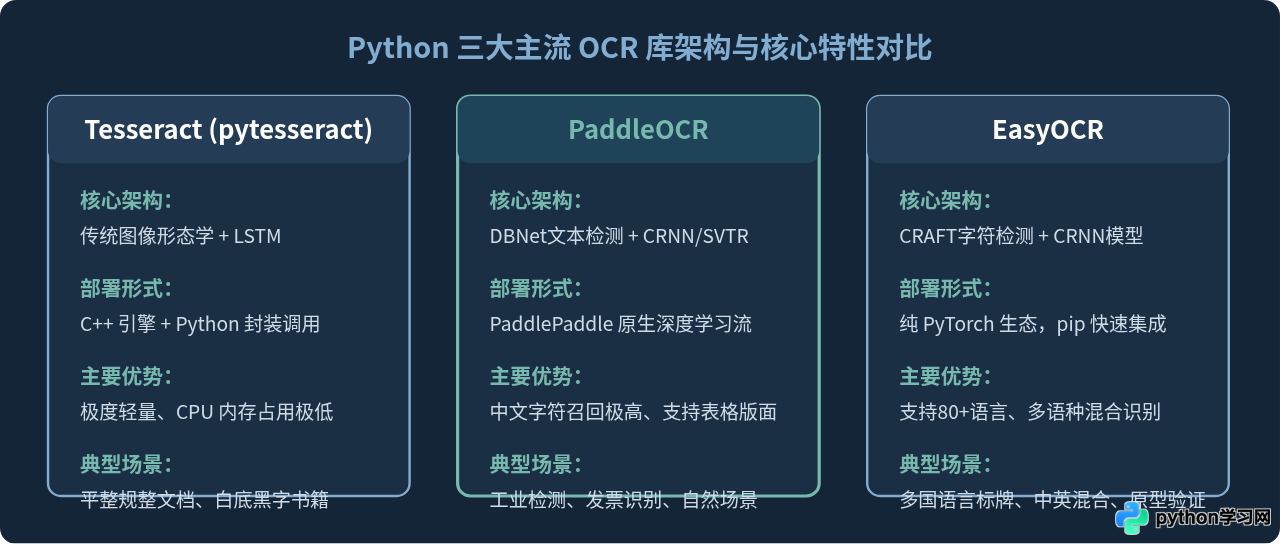
针对Python开发者在文字识别任务中的选型需求,系统对比Tesseract、PaddleOCR与EasyOCR的架构差异、识别精度、资源占用及落地难易度,提供清晰实用的选型决策指南。
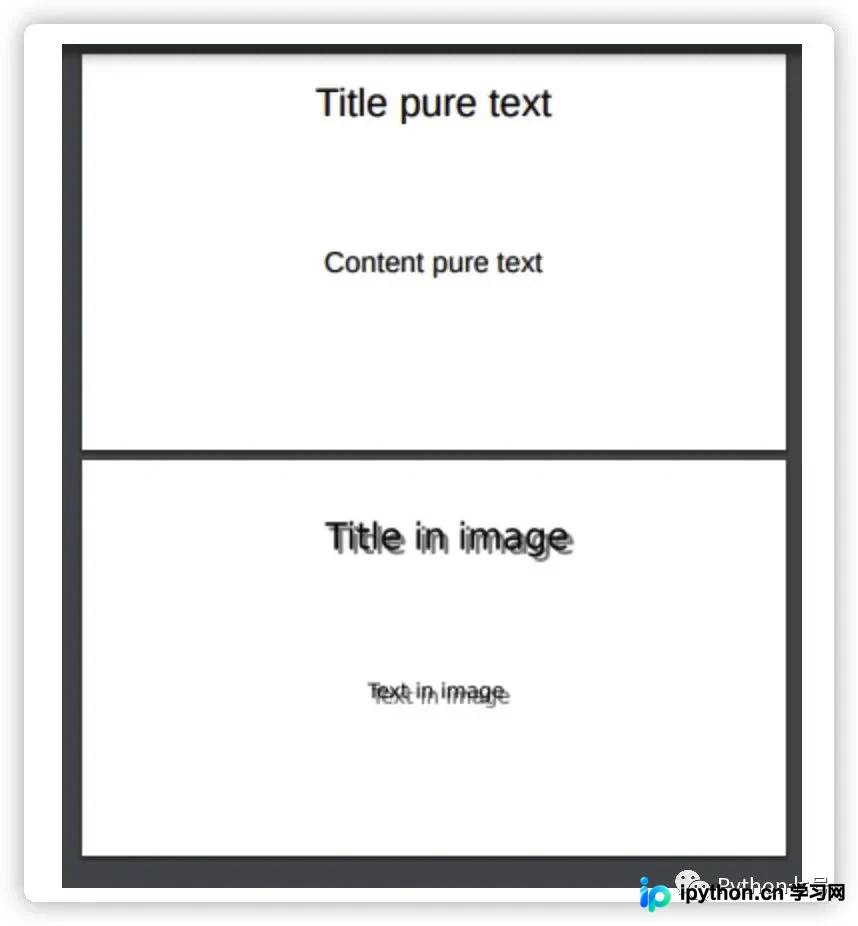
本文介绍如何利用Python从包含文字和图片的PDF文件中提取文本。通过安装tika、wand和pytesseract库,结合Tika进行基础文本解析与Pytesseract进行OCR图像识别,实现完整的内容提取。文章提供了完整的代码示例、中文语言包配置方法及命令行执行步骤,帮助开发者快速处理复杂PDF文档。
本文详细讲解在Python环境中集成OCR技术以处理验证码识别的完整流程。重点涵盖Tesseract引擎的安装与环境变量配置,解决tesserocr库在Windows下pip安装失败的whl文件获取与依赖处理问题,以及pytesseract库的便捷安装方式。通过对比两种库的实际识别效果与代码示例,提供从环境搭建到实战应用的完整解决方案。

本文详解如何使用Python进行图片文字识别。涵盖Tesseract引擎的安装与系统环境变量配置,解决中文语言包缺失问题,并通过pytesseract与Pillow库实现单图及批量图片的OCR识别,同时分析不同字体与排版对识别准确率的影响。
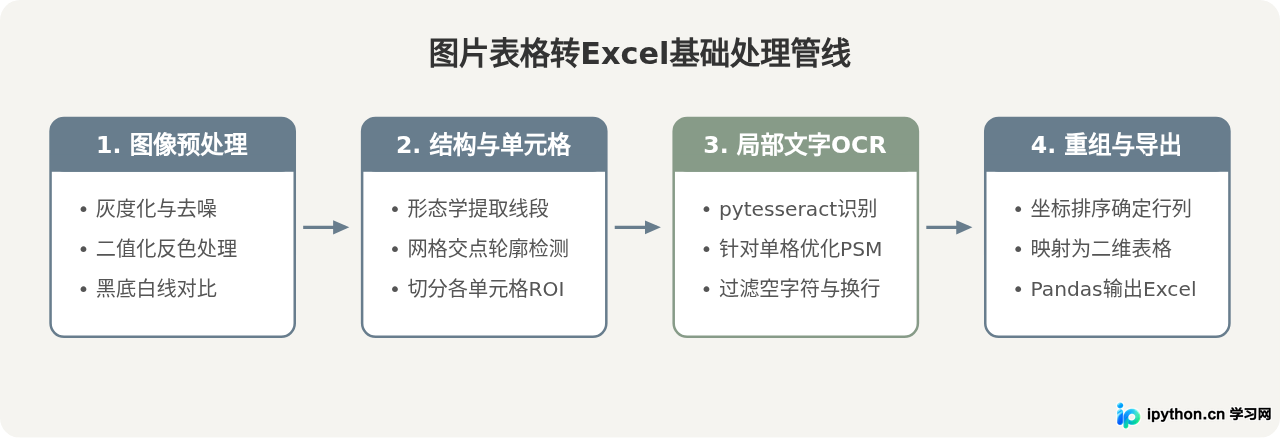
介绍如何使用Python配合pytesseract与OpenCV提取图片表格内容,并将识别结果解析转换为Excel表格文件的基础实现流程与代码。
讲解Python爬虫遇到验证码时的处理思路,包括验证码类型判断、OCR识别、图像预处理、人工打码平台接口设计、失败重试和合规边界,并提供可运行的Python示例。