


Python OCR库怎么选:Tesseract、PaddleOCR与EasyOCR对比

如果你正在为 Python 项目挑选文字识别(OCR)方案,最直接的选择结论是:处理标准扫描件或英文文档优先考虑轻量成熟的 Tesseract;处理自然场景复杂图片、中文票据及表格优先选择识别率高且功能全面的 PaddleOCR;而在需要开箱即用、支持多语种混合且依托 PyTorch 技术栈时,EasyOCR 是集成成本最低的选择。
假设你接到了一个需要自动解析发票和身份证照片的需求,输入图片可能存在微小的倾斜、阴影,甚至夹杂着印章干扰。如果直接拿最传统的 OCR 工具去跑,可能会发现不仅识别率低,连文本框都定位不准。在 Python 生态中,Tesseract、PaddleOCR 与 EasyOCR 代表了不同技术代际与设计取向的开源主力方案。明确它们在架构设计、环境依赖和识别能力上的差异,是避免后续项目返工的关键。
一、三大主流 OCR 库架构与特性速览
要做出合理的选型,首先需要理解这三个库底层依赖的技术架构及其擅长的应用侧重点。
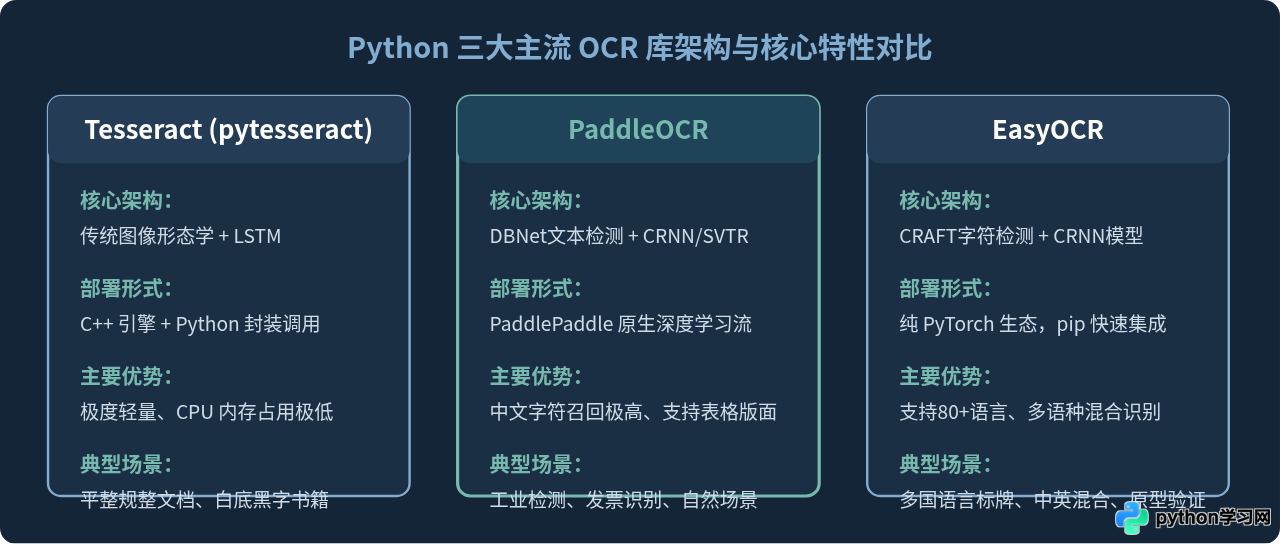
Tesseract 最初由惠普开发,后由 Google 长期维护,是开源界历史最悠久的 OCR 引擎。Python 中的 pytesseract 并不是真正的算法实现,而是一个包装器(Wrapper),负责调用底层本地安装的 tesseract 二进制可执行文件。在第 4 代及以后版本中,它引入了基于 LSTM 的序列识别神经网络,但在文本行检测层面仍较依赖传统图像形态学处理。
PaddleOCR 是百度开源的深度学习 OCR 工具套件。它集成了前沿的深度学习检测与识别模型(如 DBNet 检测模型与轻量级 PP-OCR 识别模型),并在海量中文数据集上进行了专门调优。除基础识别外,还自带文本方向分类、版面分析与表格识别能力,工业落地体系非常完整。
EasyOCR 由 Jaided AI 开发,基于 PyTorch 构建。其文本检测模块采用 CRAFT(Character Region Awareness for Text Detection)算法,识别模块采用结合 ResNet、LSTM 与 CTC 的标准 CRNN 模型。EasyOCR 最大的特点是易于安装与扩展,支持 80 多种语言且可以非常直观地配置中英文混合识别。
二、关键维度综合对比
为了直观评估各个库在生产环境中的表现,我们从识别精度、硬件与资源消耗、安装维护复杂度等维度进行综合横向对比:
| 对比维度 | Tesseract (pytesseract) | PaddleOCR | EasyOCR |
|---|---|---|---|
| 中文字符识别率 | 中等(强依赖图像二值化与方向校正) | 极高(针对中文特化,小字与形近字表现优异) | 良好(中英文混合表现稳定,生僻字稍逊) |
| 自然场景与复杂背景 | 较弱(容易受背景噪点、倾斜影响) | 极强(DBNet 检测能准确应对变形和复杂背景) | 强(CRAFT 检测精度高,对倾斜字体友好) |
| 硬件加速 (GPU) | 支持有限(主要依赖 CPU 运行) | 原生支持 CUDA,且支持 TensorRT 加速 | 原生支持 CUDA(基于 PyTorch) |
| 依赖与安装成本 | 需在系统层安装二进制文件及语言包 | 需安装 PaddlePaddle 深度学习框架 | 标准 pip 即可,仅依赖 PyTorch 与模型文件 |
| 内存/显存开销 | 极小(内存一般几十 MB) | 中等(轻量化 PP-OCR 模型在 CPU/GPU 均很克制) | 相对较高(CRAFT 模型加载后内存通常需 500MB+) |
| 多语言混合 | 通过加号组合语言包,但中文语料分词较弱 | 支持主流语言,中英文档支持极佳 | 极佳(原生支持 80+ 语言列表自由组合) |
三、通用图像处理与识别管道
现代深度学习 OCR(如 PaddleOCR 与 EasyOCR)与传统 OCR(Tesseract)在内部执行流程上存在明显的管线差异。理解识别管道有助于在识别率不足时准确定位问题。
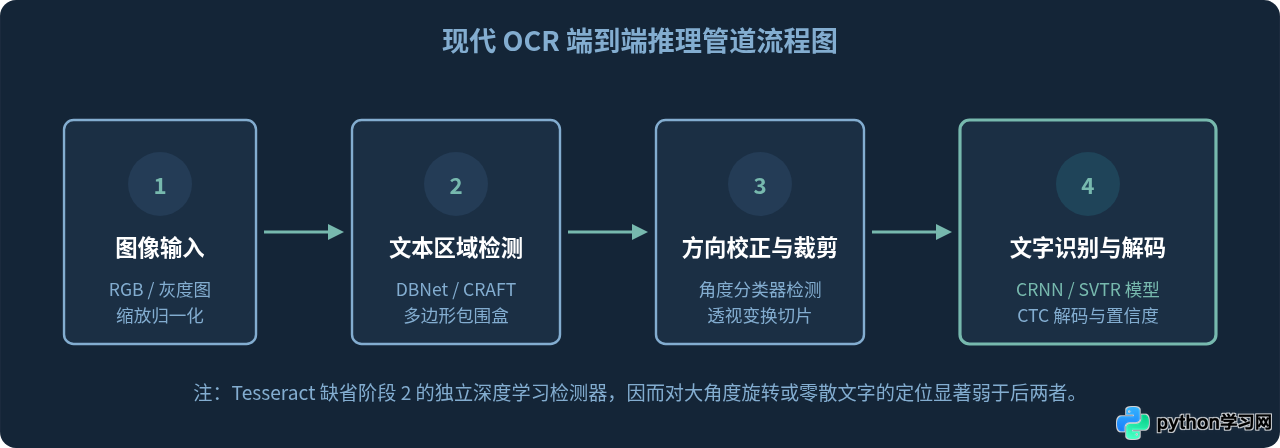
四、各库代码示例与环境配置
1. Tesseract (pytesseract)
在 Python 中使用 Tesseract 前,操作系统必须先安装引擎本身及对应语言包。例如在 Ubuntu 环境下执行 sudo apt-get install tesseract-ocr tesseract-ocr-chi-sim,macOS 环境下执行 brew install tesseract tesseract-lang。
import pytesseract
from PIL import Image

# 若系统 PATH 未包含可执行文件路径,需显式指定:
# pytesseract.pytesseract.tesseract_cmd = r'/usr/local/bin/tesseract'

image_path = 'document_sample.png'
img = Image.open(image_path)

# 识别中文简体与英文混合文档
# --psm 3 为全自动页面分割模式
text = pytesseract.image_to_string(img, lang='chi_sim+eng', config='--psm 3')

print("--- 识别结果 ---")
print(text.strip())2. PaddleOCR
PaddleOCR 安装时需要对应的 PaddlePaddle 基础环境。对于无 GPU 的普通服务器,安装 paddlepaddle 与 paddleocr 即可;若有显卡,需安装对应的 paddlepaddle-gpu 版本。
from paddleocr import PaddleOCR

# 首次执行时会自动下载轻量级检测模型、方向分类器与识别模型
# use_angle_cls=True 开启文字方向分类器,支持旋转 90/180/270 度的图片校正
ocr = PaddleOCR(use_angle_cls=True, lang='ch')

image_path = 'invoice_sample.jpg'
result = ocr.ocr(image_path, cls=True)

print("--- 识别结果 ---")
for line in result[0]:
    bbox, (text, score) = line
print(f"置信度: {score:.2f} | 内容: {text}")3. EasyOCR
EasyOCR 仅依赖常规 Python 环境及 PyTorch,执行 pip install easyocr 即可完成依赖安装。
import easyocr

# 指定需识别的语言列表,首次加载自动缓存模型权重
# gpu=False 为仅使用 CPU 运算,有 CUDA 环境时建议设为 True
reader = easyocr.Reader(['ch_sim', 'en'], gpu=False)

image_path = 'signboard_sample.jpg'
result = reader.readtext(image_path)

print("--- 识别结果 ---")
for bbox, text, prob in result:
    print(f"概率: {prob:.2f} | 文本: {text}")
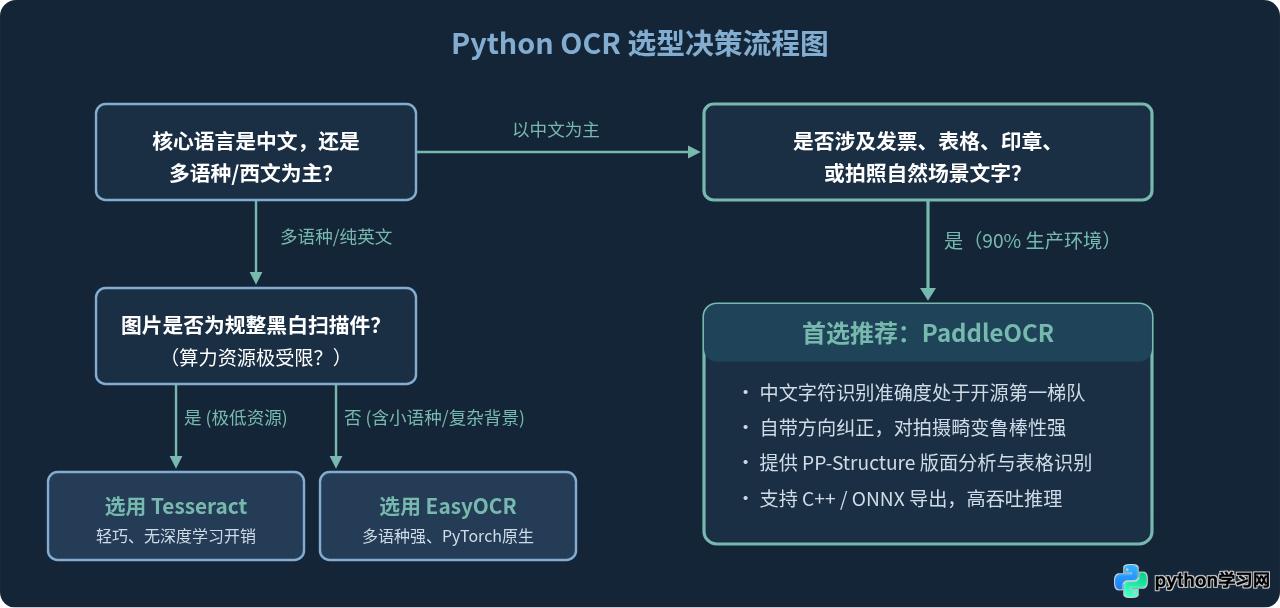
五、工程落地选型决策路径
为了在具体业务开发中快速定案,请参考以下决策路径,按照输入特征、算力约束和业务形态进行判定:
六、选型建议与落地避坑指南
-
不要指望 OCR 模型解决所有图像问题:
在任何生产管线中,前置处理都是投入产出比最高的环节。如果输入图来自手机拍摄,应在送入 OCR 之前做适度的几何校正、去高斯噪点或直方图均衡化。对于 Tesseract,这几乎是识别中文是否可用的决定性步骤。 -
长驻服务避免频繁实例化:
无论是PaddleOCR()还是easyocr.Reader(),实例化过程都会加载权重至内存或显存。必须将其作为单例或全局对象持久化在服务启动阶段,避免在 API 处理函数中每次请求重复init,导致请求耗时激增数十倍。 -
多进程并发部署(Gunicorn / Celery)时的显存隔离:
在使用 GPU 加速推理时,Python 多进程可能会遇到 CUDA 上下文初始化冲突。使用 PaddleOCR 或 EasyOCR 搭配 Celery/Gunicorn 部署时,建议设置工作进程单任务重启机制,或统一使用 TorchScript/ONNX Runtime 隔离推理过程。
七、总结
综上所述,三者并没有绝对的优劣,而是有着鲜明的分工:
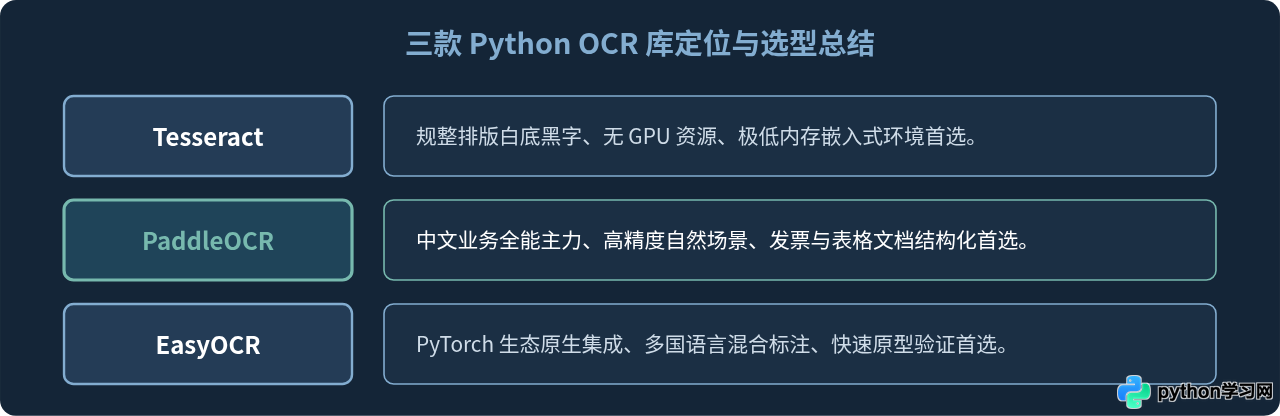
只要依据自身的“语言要求”、“图片规整程度”和“服务器资源承受力”三条基线,就能在项目初期迅速锁定最合适的 OCR 工具,高效推进技术研发与落地。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















