Python实现列表连续数字范围识别与分块处理
本文介绍在Python中如何识别列表内的连续数字范围并进行分块处理。针对已排序的连续数字,利用itertools.groupby结合枚举索引差值进行分组;针对非连续或未排序数据,先执行排序(如冒泡排序)再应用相同逻辑。文章提供了完整代码示例,展示如何提取连续区间并格式化输出范围字符串,适用于数据清洗与区间分析场景。
10-13
6




本文介绍在Python中如何识别列表内的连续数字范围并进行分块处理。针对已排序的连续数字,利用itertools.groupby结合枚举索引差值进行分组;针对非连续或未排序数据,先执行排序(如冒泡排序)再应用相同逻辑。文章提供了完整代码示例,展示如何提取连续区间并格式化输出范围字符串,适用于数据清洗与区间分析场景。
本文详细介绍Python内置模块itertools的核心功能与常用函数。涵盖chain串联迭代、groupby分组、count/cycle/repeat无穷迭代,以及product、permutations、combinations等排列组合工具。通过具体代码示例解析语法与参数,帮助开发者高效处理数据迭代任务,无需额外安装即可直接使用。
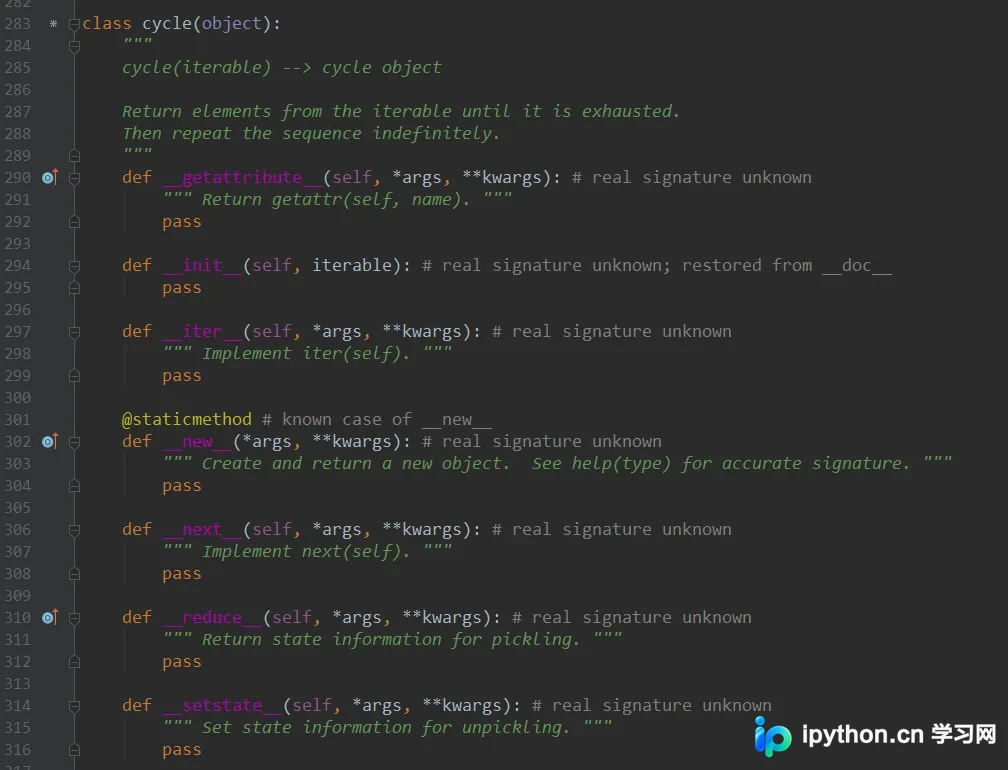
本文详细介绍Python标准库itertools中cycle函数的用法。通过对比普通列表遍历,演示如何利用cycle构造无限循环迭代器,并解析其__iter__与__next__实现原理。结合爬虫场景中Cookie池顺序调用的实例,展示如何在遵守法律前提下高效管理请求频率,实现资源的循环复用。
本文介绍在Python中同时遍历多个可迭代对象的方法。默认使用itertools.chain时,字典仅遍历键。通过自定义my_chain函数,利用yield实现完整遍历字典值的功能,帮助开发者灵活处理复杂数据结构。
本文深入解析Python标准库itertools模块,涵盖count、cycle、repeat等无限迭代器,chain、groupby、accumulate等聚合工具,以及combinations、product等组合数学函数。通过具体代码示例展示切片、过滤与多迭代器拆分技巧,帮助开发者高效处理复杂数据流与算法逻辑。
本文介绍Python中zip函数如何同时迭代多个序列。解析zip在Python 2与3中的行为差异,演示生成元组迭代器的用法,并针对序列长度不一致的情况,介绍使用itertools.zip_longest的解决方案,帮助开发者高效处理多数据源遍历。
本文详细介绍Python中列表的排列与组合操作,通过itertools模块中的product和combinations函数实现。示例展示了如何对列表['1','2','3']生成全排列,以及对[1, 2, 3, 4, 5]进行组合选取。代码简洁高效,适合Python初学者及需要处理数据排列组合场景的开发者参考。
本文介绍Python中跳过文件第一行读取内容的两种实现方式。传统方法通过行号判断过滤首行,但存在额外时间开销;推荐做法是利用itertools模块中的islice函数,通过切片机制直接定位起始位置,从而提升读取效率并简化代码逻辑。
本文详细介绍Python标准库itertools中的内置无限迭代器,包括count()生成自然数序列、cycle()循环序列、repeat()重复元素以及takewhile()截取有限序列的方法,并演示chain()串联和groupby()分组技巧,帮助开发者高效处理迭代对象。
本文详细解析 Python 中将两层嵌套列表展开为单层扁平列表的五种实现方式,包括 map、sum、reduce、列表推导式及 itertools.chain。通过实际代码示例与性能测试数据,对比各方法的执行效率与代码简洁性,并补充嵌套字典平铺的递归实现方案,帮助开发者选择最优解。
本文详细解析Python中合并列表的八种常见方法,包括使用加号、itertools.chain、解包操作符、extend方法、列表推导式、heapq.merge、魔法方法__add__结合reduce以及yield from生成器。文章强调在团队协作中,代码简洁性与可读性优于炫技,建议根据具体场景(如是否需要排序、性能要求等)选择最合适的合并策略,并指出理解多种写法有助于阅读他人代码。
本文详细介绍Python标准库itertools模块的核心功能,涵盖chain、count、filterfalse、compress、starmap、repeat、dropwhile、takewhile、islice、product、permutations及combinations等常用函数的用法与参数说明,并提供质数求和等实战应用示例,帮助开发者高效处理迭代数据。



