Python操作RabbitMQ的三种工作模式详解
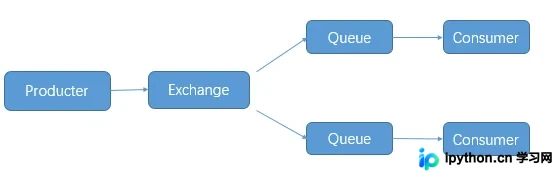
本文详细介绍Python使用Pika库操作RabbitMQ的三种核心工作模式:Fanout(发布订阅)、Direct(路由键匹配)和Topic(主题匹配)。内容涵盖生产者与消费者实现、队列与Exchange持久化配置、消息持久化及ACK确认机制,帮助开发者在高并发、分布式系统中合理选择消息队列模式。
10-15
5




本文详细介绍Python使用Pika库操作RabbitMQ的三种核心工作模式:Fanout(发布订阅)、Direct(路由键匹配)和Topic(主题匹配)。内容涵盖生产者与消费者实现、队列与Exchange持久化配置、消息持久化及ACK确认机制,帮助开发者在高并发、分布式系统中合理选择消息队列模式。
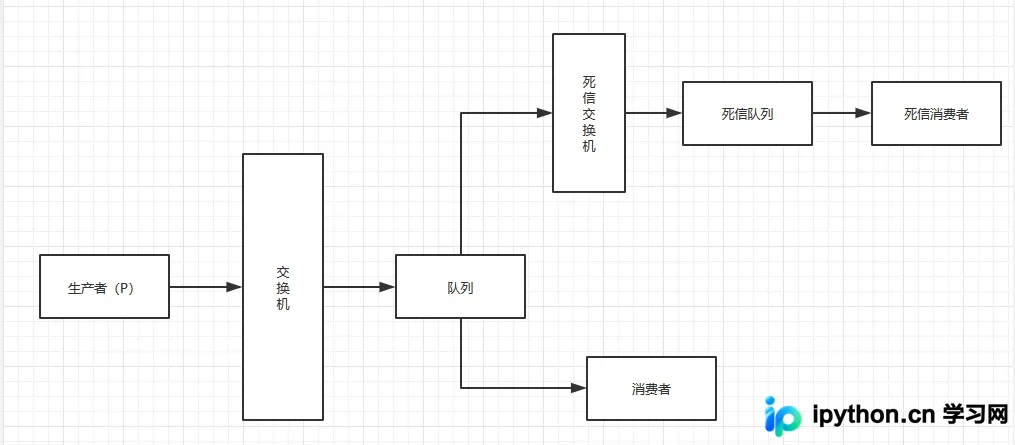
本文介绍如何利用Python和RabbitMQ实现延迟队列。通过结合消息生存时间(TTL)和死信交换机(DLX)两个核心特性,将过期消息转发至指定队列,从而实现延迟消费。文章详细解析了Queue TTL与Per-Message TTL的区别,并提供了完整的Python生产者与消费者代码示例,解决异步任务中需要延迟处理的场景。
本文介绍如何利用Python的Pika库监听RabbitMQ默认的系统日志交换机amq.rabbitmq.log。通过绑定info、error、warning三个队列,分别接收对应级别的日志消息,实现简单的日志监控功能。
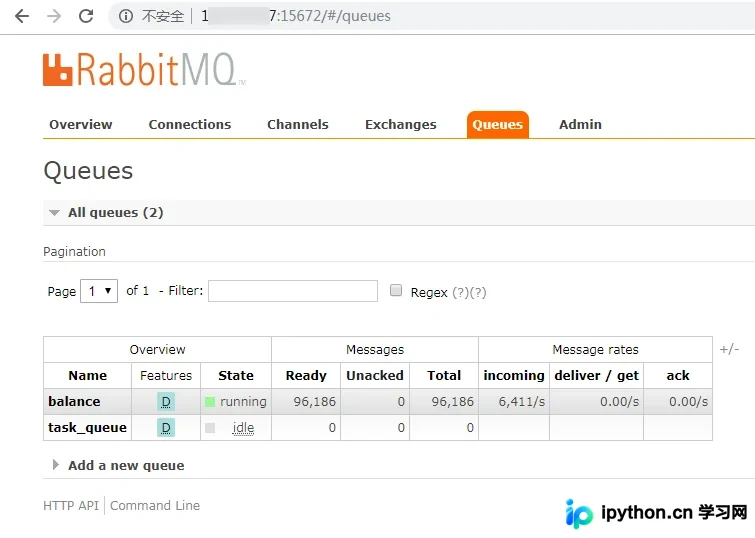
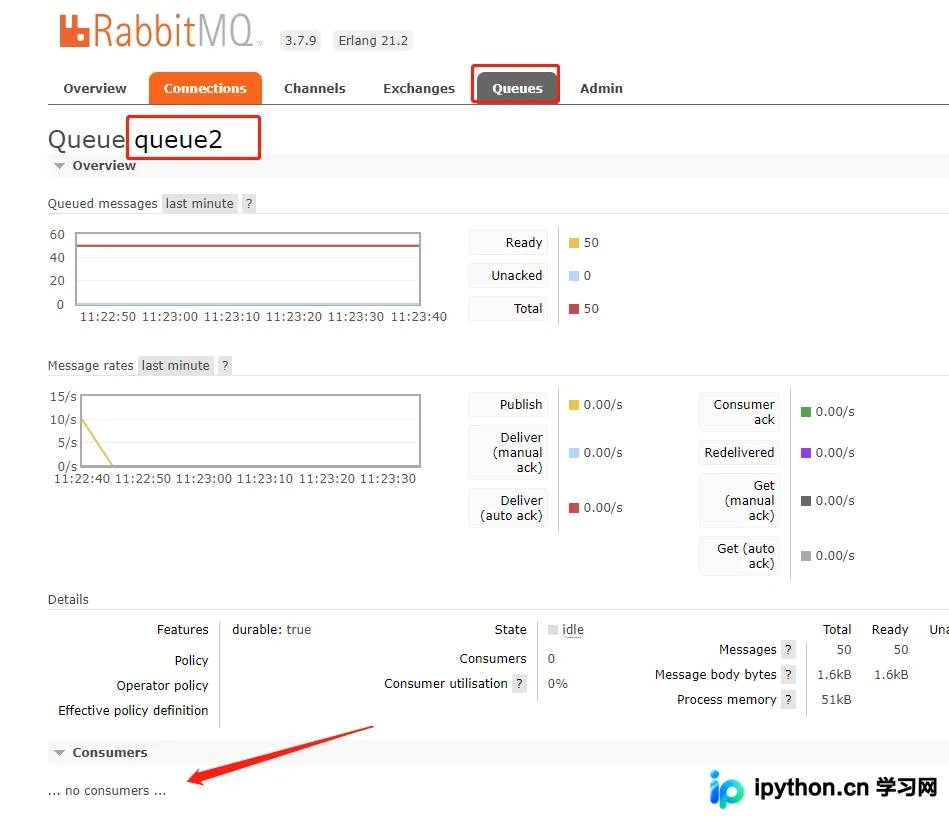
本文介绍如何使用Python的Pika库实现RabbitMQ的生产者与消费者模式。通过配置连接参数、声明持久化队列、发送消息及设置回调函数接收消息,完整演示了消息队列的基本交互流程。包含代码示例及通过管理界面或命令行验证消息数量的方法,帮助开发者快速掌握RabbitMQ在Python中的应用。
本文介绍如何使用Python的Pika库连接RabbitMQ实现进程间通信。详细解析Queue、Fanout广播、Direct过滤、Topic通配符匹配及RPC双向通信五种模式,提供完整代码示例与安装配置指南,帮助开发者掌握分布式消息传递核心技能。
本文详细介绍Python Celery框架中多队列的配置方法。通过实例代码展示如何定义Queue对象、设置CELERY_QUEUES与CELERY_ROUTES参数,实现任务到指定队列和routing_key的精准路由。涵盖项目结构、配置文件编写及Worker启动命令,帮助开发者优化异步任务分发策略。
本文详细讲解如何在 Python Django 2.0 项目中集成 Celery 4.1,实现异步任务处理与周期性定时任务。涵盖环境准备、Broker 配置、Worker 启动、Beat 调度器设置以及使用 django-celery-results 存储任务结果等关键步骤,帮助开发者快速搭建高效的任务队列系统。
本文详解Python环境下RabbitMQ队列的使用方法,涵盖交换机路由策略、队列创建及消息发送流程。通过对比PHP实现的AMQP连接与消费者代码,演示了如何配置Direct类型交换机、持久化队列以及启用自动ACK应答模式,帮助开发者掌握消息中间件的核心集成步骤。
本文针对Python3使用Pika库消费RabbitMQ队列时出现的连接断开问题进行分析。通过排查发现,当回调函数执行耗时操作时,若未正确理解heartbeat_interval参数含义,会导致连接被服务端强制关闭。文章详细解释了该参数的作用机制,并提供了正确的配置建议,避免手动添加复杂心跳线程。
本文通过Python Pika库详细演示了RabbitMQ中Fanout、Direct和Topic三种Exchange模式的具体实现。内容涵盖广播、精确路由及通配符路由的配置方法、代码示例及运行结果分析,帮助开发者理解不同场景下的消息分发机制。
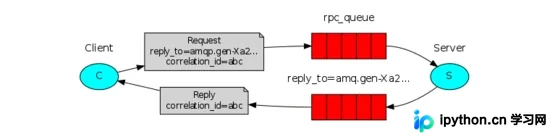
本文介绍在Python中利用Pika库实现RabbitMQ的RPC功能。通过对比ActiveMQ,阐述为何选择RabbitMQ,并详细解析客户端、服务器及处理器的目录结构与代码实现。重点说明RPC调用中corr_id与reply_to队列的携带机制,以及如何处理异步响应和任务状态查询,帮助开发者避开常见坑点。
本文详解如何在Linux环境下安装RabbitMQ,并利用Python的Pika库实现消息队列的基本操作。内容涵盖生产者与消费者的代码实现、消息确认机制(ACK)以防止数据丢失,以及通过持久化配置保障RabbitMQ宕机后的数据安全性。此外,还介绍了Fanout发布订阅模式的应用,帮助开发者构建高可用、解耦的分布式系统架构。



