SQL Server 常用统计查询语句实战汇总
本文整理了 SQL Server 中高频使用的统计查询场景,涵盖单人总分计算与排名、单科最高分提取、平均成绩统计、课程分数段分布计数、行转列(透视表)处理以及复杂排名截取等需求。通过标准 SQL 语法提供可直接运行的示例,帮助开发者和数据库管理员快速解决常见的数据聚合与分析难题。
10-16
7




本文整理了 SQL Server 中高频使用的统计查询场景,涵盖单人总分计算与排名、单科最高分提取、平均成绩统计、课程分数段分布计数、行转列(透视表)处理以及复杂排名截取等需求。通过标准 SQL 语法提供可直接运行的示例,帮助开发者和数据库管理员快速解决常见的数据聚合与分析难题。
本文详细讲解如何在 SQL Server Management Studio (SSMS) 中创建和管理数据库表的五种核心约束。涵盖主键(PRIMARY KEY)、外键(FOREIGN KEY)、唯一(UNIQUE)、默认(DEFAULT)和检查(CHECK)约束的定义区别,并通过图形化界面操作指南,演示如何设置单列主键、表间关联及数值范围限制,确保数据完整性。
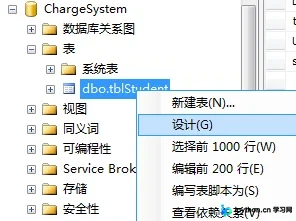
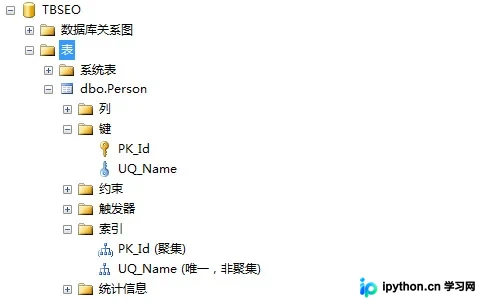
在 SQL Server 中,主键与唯一约束均保证字段值的唯一性,但存在关键差异。同一表仅允许一个主键,且不能包含 NULL 值;唯一约束允许多个且可含 NULL。主键默认创建聚集索引并常作为外键关联,而唯一约束通常创建非聚集索引。
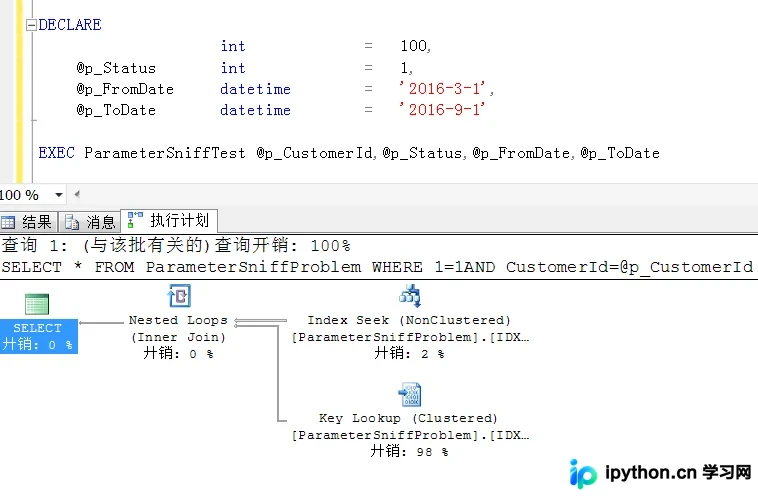
在 SQL Server 中,数据分布不均常导致参数化存储过程产生 Parameter Sniff(参数嗅探)现象,即错误的执行计划被重用。本文通过模拟测试展示了该问题的成因及表现,并提供了一种针对高风险参数的“混合参数化”解决方案:对易引发数据倾斜的参数直接使用字符串拼接以触发按需重编译,其余条件保持参数化以复用执行计划,从而在避免极端性能下降的同时平衡缓存效率。
本文介绍了在SQL Server和Oracle数据库中,如何编写SQL语句来实现数据的日报和月报功能。通过具体的代码示例,展示了如何利用日期转换和过滤条件来统计特定时间段内的数据汇总,适用于需要生成日常或月度报表的场景。
本文介绍 SQL Server 中局部 (#) 和全局 (##) 临时表的创建、查询及删除方法。对比 SELECT INTO 与 CREATE TABLE + INSERT INTO 的性能差异,提供完整的语法示例与存储过程中的嵌套应用注意事项。
在 SQL Server 中,系统视图 sys.dm_db_missing_index_details 等可用于分析性能瓶颈。本文提供一段 T-SQL 查询代码,通过关联多个动态管理视图(DMV),计算潜在索引的收益指标,并直接输出可执行的 CREATE INDEX 语句。该脚本帮助 DBA 快速识别高频访问且收益显著的数据表,无需依赖图形界面即可批量生成索引建议,提升数据库查询效率。
本文详解 SQL Server 中登录名(Login)与用户名(User)的核心区别及映射机制。阐述两者在服务器与数据库层面的权限分配差异,解析 dbo、public 和 guest 等特殊账户的作用,并说明通过所有者限定访问不同用户创建对象的操作方法及注意事项。
当MSSQL Server服务无法开机自启或需要快速控制时,可使用Windows命令行工具进行手动启动与关闭。通过执行"net start mssqlserver"命令即可在服务管理器中拉起数据库进程,而"net stop mssqlserver"用于安全停止服务。本文介绍如何编写批处理文件简化日常操作。
本文对比 SQL Server 与 Oracle 数据库在执行 DELETE 和 UPDATE 语句时对表别名支持的差异。SQL Server 中 DELETE FROM 子句后直接跟别名会导致语法错误,需将别名置于 FROM 子句中;而 Oracle 允许直接在表名后使用别名。UPDATE 语句同理,标准写法需调整别名位置以确保跨库兼容或正确执行。
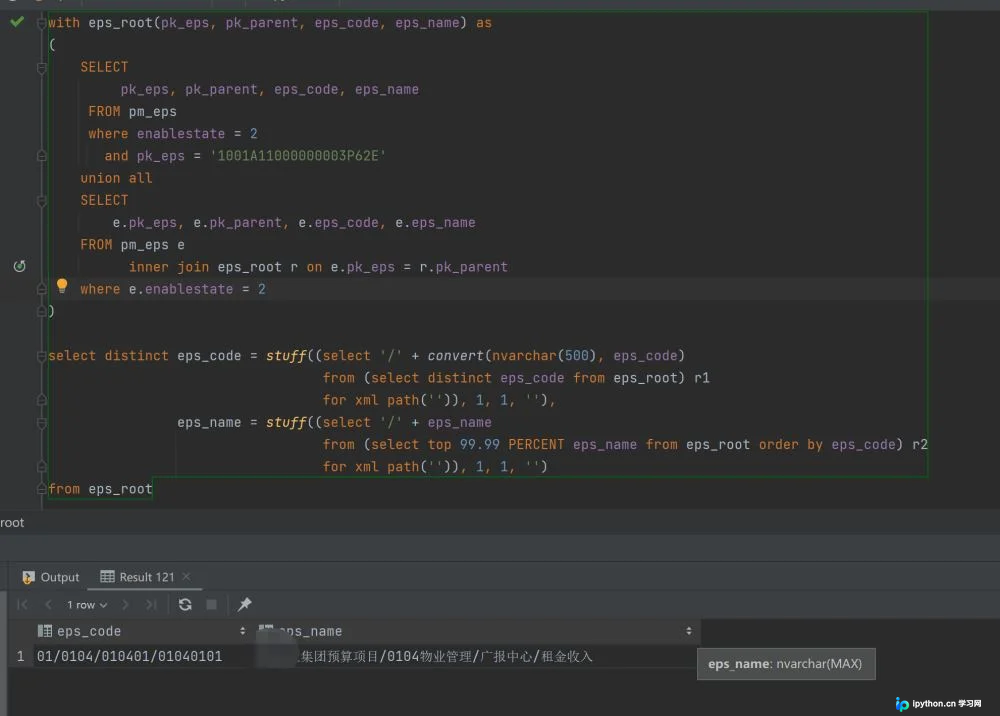
本文介绍如何在 SQL Server 中使用公用表表达式(CTE)进行递归查询,以获取树形结构中某节点的所有上级节点,并利用 STUFF 函数结合 FOR XML PATH 将这些多行数据合并为一行字符串,同时解决中文乱序问题。
在 SQL Server 中,可以利用内置的 CHARINDEX 函数快速判断一个字符串是否包含特定的单字符或子串。本文介绍了两种实用场景:基于分隔符(如逗号)拆分比对和逐字匹配。通过创建自定义标量函数,可以将这些逻辑封装,以便在复杂的表查询中直接调用,提高数据处理效率。



