


MySQL与Oracle、SQL Server有什么区别?数据库选型对比

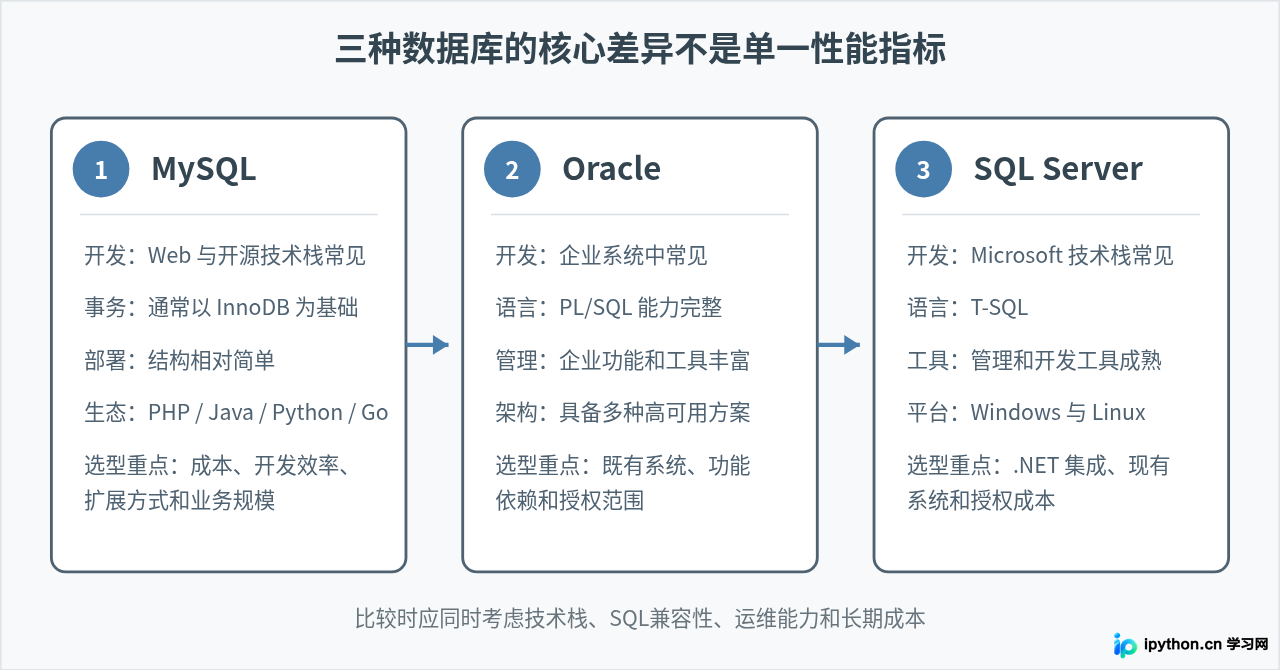
MySQL、Oracle 和 SQL Server 都属于成熟的关系型数据库,但真正影响项目选型的,并不是“谁的功能更多”,而是现有技术栈、并发模型、SQL 兼容性、高可用要求、团队经验、授权成本以及未来迁移成本。对于普通 Web 应用,MySQL 往往更容易部署和控制成本;已经大量使用 Oracle 技术体系的核心业务,通常更关注 Oracle 的企业级能力和兼容性;以 .NET、Microsoft 工具链为主的系统,则往往会重点考察 SQL Server。
因此,数据库选型不能只看一张性能排行榜。下面从实际开发和维护中最容易遇到的差异开始比较。
先看清三种数据库最主要的差异
| 比较项目 | MySQL | Oracle | SQL Server |
|---|---|---|---|
| 常见使用方向 | Web 网站、互联网应用、中小型到大型业务系统 | 复杂企业系统、已有 Oracle 技术体系的核心业务 | .NET、Microsoft 技术体系以及企业内部业务系统 |
| SQL 扩展 | MySQL 自身 SQL 方言和存储程序语法 | SQL + PL/SQL | SQL + T-SQL |
| 事务存储 | 通常使用 InnoDB | 数据库自身统一管理 | 数据库引擎统一管理 |
| 开发生态 | PHP、Java、Python、Go 等开源技术栈中非常常见 | Java、企业中间件及 Oracle 相关产品体系常见 | .NET、Windows、Azure 等 Microsoft 生态结合较紧密 |
| 部署环境 | Linux 使用非常普遍,也支持其他主流平台 | 常见于 Linux、Unix 类及企业服务器环境 | 支持 Windows,也支持 Linux |
| 授权特点 | 存在社区版以及商业产品、服务 | 商业授权体系较复杂,具体功能与选项需按版本确认 | 不同版本和使用场景存在不同授权方式,也有面向开发或轻量场景的版本 |
| 学习和部署门槛 | 通常较低 | 企业功能较多,管理和授权知识要求较高 | 管理工具完善,Microsoft 技术栈用户上手较自然 |
上表只是第一层判断。真正选型时,还要继续分析 SQL 差异、事务特性以及现有系统对特定数据库功能的依赖程度。
SQL 都叫 SQL,但实际写法并不完全一样
三种数据库都支持标准 SQL 的核心部分,例如 SELECT、INSERT、UPDATE、DELETE、JOIN 和事务操作。不过一旦进入主键生成、分页、日期函数、字符串处理、存储过程等场景,差异就会明显增加。
自增主键写法不同
假设要建立一张用户表,并让数据库自动生成主键,不同数据库可以采用不同写法。
MySQL:
CREATE TABLE users (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    username VARCHAR(100) NOT NULL
);
SQL Server:
CREATE TABLE users (
    id BIGINT IDENTITY(1,1) PRIMARY KEY,
    username VARCHAR(100) NOT NULL
);
支持标识列语法的 Oracle 环境:
CREATE TABLE users (
    id NUMBER GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    username VARCHAR2(100) NOT NULL
);
这三个表表达的业务意图相同:插入用户时自动生成 ID。但是表结构源码不能直接复制到另外一个数据库中运行。
分页查询也存在方言差异
MySQL 中经常可以看到:
SELECT id, username
FROM users
ORDER BY id
LIMIT 20 OFFSET 40;
SQL Server 可以使用:
SELECT id, username
FROM users
ORDER BY id
OFFSET 40 ROWS
FETCH NEXT 20 ROWS ONLY;
支持 OFFSET ... FETCH 的 Oracle 环境也可以使用类似方式:
SELECT id, username
FROM users
ORDER BY id
OFFSET 40 ROWS
FETCH NEXT 20 ROWS ONLY;
看起来差异不大,但如果一个系统有几百条手写 SQL,再加入日期函数、JSON 操作、存储过程和数据库特有函数,迁移工作量就可能迅速增加。
事务和并发控制要看具体数据库机制
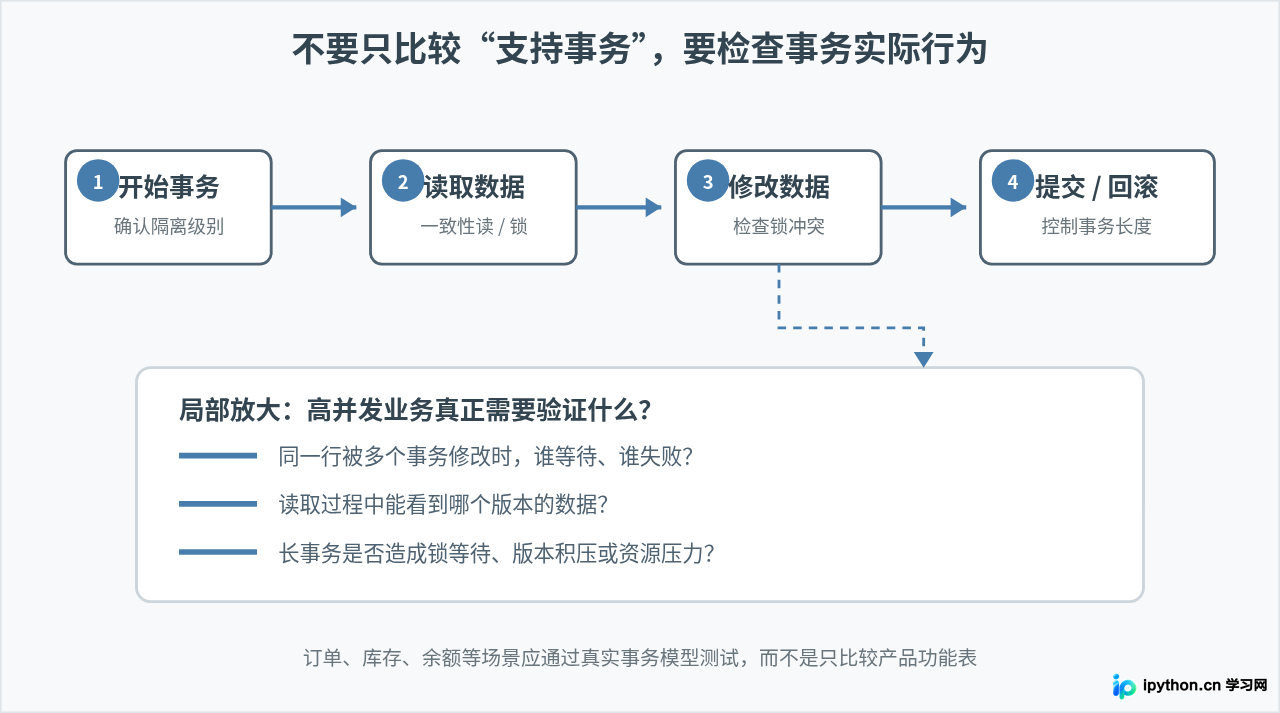
业务系统不只是“把数据写进表里”。订单扣库存、账户余额变化、任务抢占等场景都依赖事务隔离和并发控制,这部分也是三种数据库选型时不能忽略的内容。
MySQL 实际项目中通常以 InnoDB 作为事务表的基础。InnoDB 支持事务、行级锁和多版本并发控制。Oracle 同样长期采用多版本一致性读取等机制处理并发访问。SQL Server 则同时具有基于锁的并发控制能力,并提供基于行版本的相关隔离选项。
这里有一个容易产生误解的地方:“支持 MVCC”并不意味着三个数据库在所有隔离级别下行为完全相同。例如默认事务隔离级别、读写冲突方式、快照读取实现以及锁等待行为都有差别。
| 关注点 | MySQL / InnoDB | Oracle | SQL Server |
|---|---|---|---|
| 常见默认隔离级别 | REPEATABLE READ | READ COMMITTED | READ COMMITTED |
| 一致性读取 | 通过 InnoDB 多版本机制实现 | 通过多版本一致性读取机制实现 | 可结合锁机制以及启用的行版本相关选项实现 |
| 并发问题排查 | 关注事务持续时间、锁等待、索引和执行计划 | 关注事务、等待事件、执行计划及数据库资源 | 关注阻塞链、锁、执行计划以及相关等待信息 |
表中的隔离级别描述的是常见默认配置,实际服务器可以调整。因此接手现有数据库时,应检查服务器和数据库的真实配置,而不是仅凭产品名称推断事务行为。
MySQL 的优势主要体现在部署和 Web 开发生态
如果项目是常规网站、API 服务、内容系统、电商业务或 SaaS 应用,MySQL 往往是比较自然的候选方案。
原因并不只是免费版本容易获得,而是围绕 MySQL 的开发工具、ORM、备份工具、中间件和云数据库服务非常丰富。PHP、Java、Python、Go、Node.js 等技术栈通常都有成熟驱动,开发人员也比较容易找到相关资料。
例如一个典型网站架构可以是:
Nginx
  ↓
PHP / Java / Python / Go 应用
  ↓
MySQL
  ↓
主从复制、备份或云数据库服务
这类系统如果主要处理用户、文章、订单、商品、日志索引等结构化数据,并没有大量依赖数据库端复杂业务逻辑,MySQL 通常比较合适。
但不能由此得出“MySQL 只适合小项目”的结论。数据库能否承担大型业务,更取决于表结构、索引设计、SQL 质量、缓存、读写拆分、分片策略以及业务架构。
Oracle 的区别不只是“价格更高”
谈 Oracle 时,如果只概括成“企业数据库、价格高”,会忽略真正影响技术选型的内容。
很多长期运行的企业系统会把相当多的业务逻辑放在数据库端,包括 PL/SQL 包、过程、函数、触发器、作业以及数据库特有的数据类型和功能。如果一个现有系统已经大量采用这些能力,把数据库换成 MySQL 或 SQL Server 往往不是简单导出表再导入。
例如应用中调用:
BEGIN
    order_pkg.create_order(
        p_user_id  => :user_id,
        p_amount   => :amount
    );
END;
此时真正需要迁移的不只是 orders 表,而是整个 order_pkg 里面的业务逻辑。过程中的异常处理、事务控制、游标、函数调用也要重新实现。
因此,对于已经形成 Oracle 技术体系的系统,数据库选型需要重点统计:
- PL/SQL 代码数量;
- 触发器、作业、序列以及数据库对象数量;
- 应用是否依赖 Oracle 特有 SQL;
- 现有备份、容灾、监控体系;
- 业务对特定高可用或企业功能的依赖;
- 相应版本和功能所涉及的授权范围。
这些内容往往比单纯比较一条 SQL 的执行速度更加重要。
SQL Server 更适合哪些技术环境
SQL Server 与 Microsoft 开发工具和企业技术体系结合较自然,尤其是项目本身大量使用 .NET、Microsoft 身份体系、Microsoft 数据平台或相关管理工具时,统一技术栈可以减少不少集成工作。
SQL Server 的 T-SQL 也提供了比较完整的存储过程、变量、错误处理和事务控制能力。例如:
BEGIN TRY
    BEGIN TRANSACTION;

    UPDATE account
    SET balance = balance - 100
    WHERE id = 1;

    UPDATE account
    SET balance = balance + 100
    WHERE id = 2;

    COMMIT TRANSACTION;
END TRY
BEGIN CATCH
    IF @@TRANCOUNT > 0
        ROLLBACK TRANSACTION;

    THROW;
END CATCH;
如果团队长期使用 C#、ASP.NET 和 SQL Server,开发、调试以及数据库管理通常能够保持相对统一的工作方式。
需要注意,不能再简单把 SQL Server 理解为“只能安装在 Windows 上”。SQL Server 也支持 Linux。不过现有企业环境到底应该部署在哪个平台,仍要结合运维工具、认证体系、备份方案和团队能力确定。
高可用不能只比较有没有主从复制
生产数据库通常还会面临服务器故障、磁盘故障、机房故障以及误操作等问题。MySQL、Oracle 和 SQL Server 都有相应的复制、高可用和灾难恢复技术,但实现方式、适用条件和管理体系并不完全相同。
选型时应把“高可用”拆成具体指标:
- 主库故障后允许中断多长时间;
- 最多允许丢失多少数据;
- 是否需要跨机房或跨地域副本;
- 切换由人工执行还是自动执行;
- 备库主要用于容灾,还是还要承担读取任务;
- 是否需要时间点恢复;
- 备份损坏时有没有第二份独立副本。
例如,“要求数据库高可用”这个描述过于模糊,而下面的要求就更容易用于技术选型:
数据库节点故障:
目标:10 分钟内恢复服务

数据恢复:
允许最多丢失 1 分钟数据

容灾:
至少保留一个异地副本

备份:
每日完整备份 + 持续日志/增量保护

恢复验证:
定期执行独立恢复演练
确定这些条件后,再去判断 MySQL、Oracle 或 SQL Server 应采用哪种具体方案,结果会可靠得多。
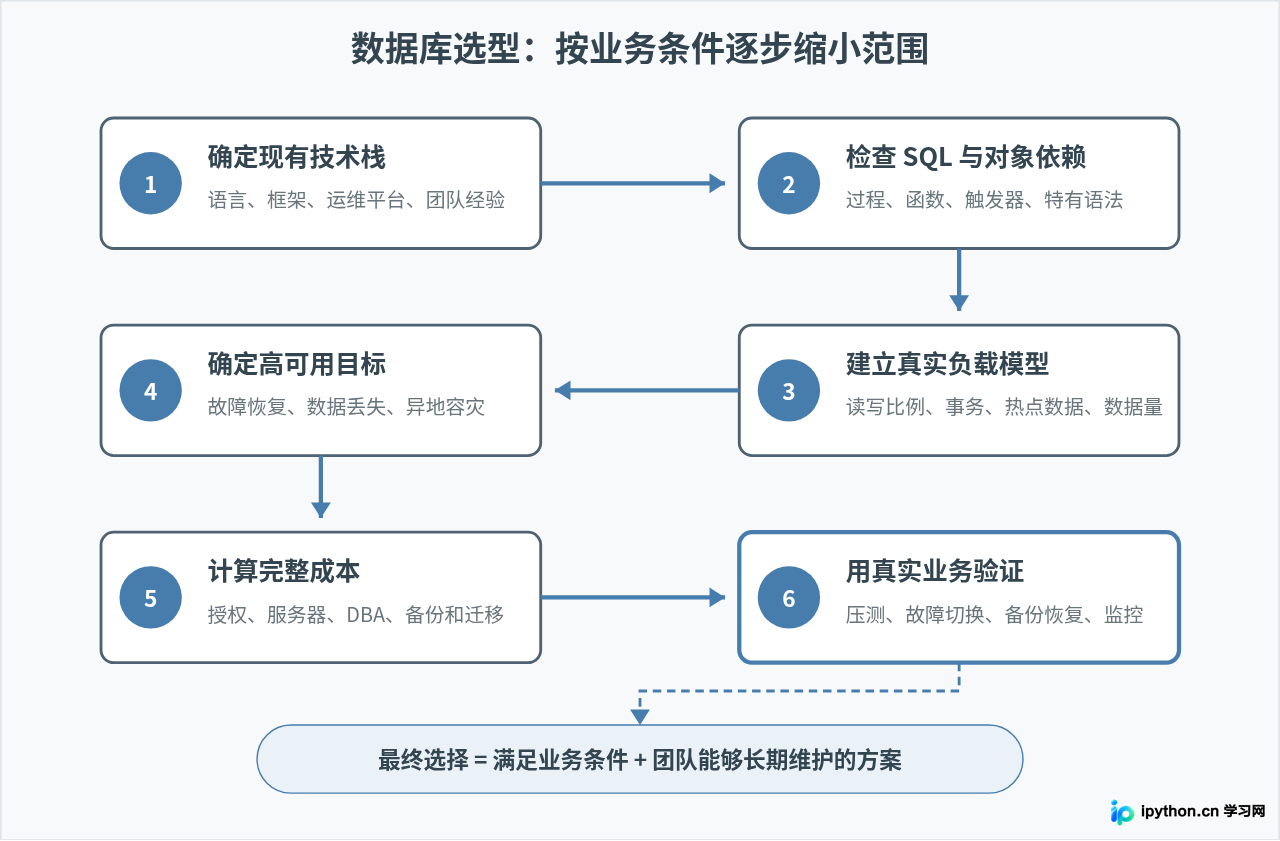
实际项目可以按六个步骤完成数据库选型
对于新项目,不建议先问“哪个数据库性能最好”,而应先把业务条件整理出来。下面这套流程比直接比较产品功能更实用。
第一步:看团队和现有系统
如果团队已经维护大量 MySQL 服务,而新项目没有明确要求 Oracle 或 SQL Server 的特殊功能,那么引入全新的数据库体系意味着需要增加监控、备份、故障处理和人员培训成本。
反过来也是一样。一个拥有大量 PL/SQL 资产的 Oracle 系统,如果单纯为了降低数据库授权成本迁移到 MySQL,必须把改造应用程序和数据库代码的成本一起计算。
第二步:检查数据库依赖
可以重点搜索现有项目中的这些内容:
- 存储过程和函数;
- 触发器;
- 数据库任务;
- 特有字段类型;
- 特有分页语法;
- 序列、自增列;
- 日期和字符串函数;
- 数据库 Hint;
- 复杂分析函数。
依赖越多,换数据库的迁移成本越高。
第三步:不要拿一条 SELECT 代表整个业务
数据库性能测试至少应该覆盖实际使用的查询模式。例如一个电商系统可以分别测试:
- 商品列表查询;
- 关键词搜索后的数据库过滤;
- 创建订单;
- 并发扣减库存;
- 用户订单历史分页;
- 后台统计查询;
- 批量写入;
- 大事务和慢 SQL 对其他请求的影响。
只有这样得到的结果,才具有真正的选型意义。
不要忽略数据库之外的维护成本
数据库成本并不只是购买软件或者租一台服务器。长期运行一个数据库,通常还会涉及:
- 主库和备用节点;
- 备份存储;
- 异地备份流量;
- 监控系统;
- DBA 或运维人员;
- 数据库升级;
- 故障演练;
- 数据迁移;
- 商业技术支持;
- 特定版本或功能的授权。
因此,即使某个数据库本身可以低成本部署,也不表示整个数据库系统没有维护成本;同样,商业数据库价格较高,也不能在不分析业务依赖的情况下直接认定更换数据库一定更省钱。
几个常见场景应该怎样比较
普通内容网站或 API 服务
如果主要技术栈是 PHP、Python、Java、Go 或 Node.js,数据库操作以常规 CRUD、索引查询和事务为主,对特殊数据库功能依赖不强,可以优先把 MySQL 放入候选范围。
重点验证的是索引设计、数据增长速度、备份、复制以及未来是否需要拆分数据,而不是因为数据库功能列表较短就直接排除。
大量 PL/SQL 的现有企业系统
这类系统继续使用 Oracle 往往能够避免大规模重构。若计划迁移,则应该先统计数据库代码和专有功能依赖,再评估迁移,而不是把数据库表导出成功当成迁移完成。
以 C# 和 Microsoft 技术体系为主的业务
SQL Server 值得重点考察,特别是团队已经熟悉 T-SQL、相关管理工具及现有 Microsoft 基础设施的情况下。此时数据库和应用技术栈的一致性本身就是维护优势。
准备从一种数据库迁移到另一种
优先评估兼容性,而不是重新进行一轮抽象的数据库排名。迁移项目可以建立这样一张清单:
| 检查项 | 需要确认的问题 |
|---|---|
| 表结构 | 字段类型、默认值、自增方式是否兼容 |
| SQL | 分页、函数、日期计算、字符串操作是否需要改写 |
| 数据库代码 | 存储过程、函数、触发器能否迁移 |
| 事务 | 隔离级别改变后业务行为是否一致 |
| 应用程序 | 驱动、ORM、连接池参数是否需要调整 |
| 运维 | 监控、备份、恢复、复制方案是否需要重建 |
| 性能 | 关键 SQL 是否重新建立索引并检查执行计划 |
几个容易出现的选型误区
误区一:Oracle 一定比 MySQL 快
没有业务模型,这种比较没有实际意义。一条查询快慢可能受到 SQL 写法、索引、缓存、磁盘、CPU、统计信息、并发量和数据分布等多个因素影响。
更准确的问题应该是:在自己的表结构、数据规模和并发条件下,哪种方案能达到目标,并且能够长期维护?
误区二:MySQL 免费,所以总成本最低
数据库软件成本只是整体成本的一部分。如果系统需要复杂分片、大量中间件或者额外的人力维护,同样会产生明显成本。
误区三:SQL Server 只能用于 Windows
SQL Server 也支持 Linux,因此平台已经不能简单用“Windows 数据库”进行概括。真正应该比较的是组织现有基础设施、运维工具和应用生态。
误区四:更换数据库只需要迁移数据
这是数据库迁移中风险较大的判断。数据本身可能只是最容易移动的一部分,真正困难的通常是 SQL 方言、存储过程、事务行为和外围运维体系。
MySQL、Oracle、SQL Server到底怎么选
如果把前面的内容压缩成选型规则,可以先从现有技术环境和数据库依赖开始判断。
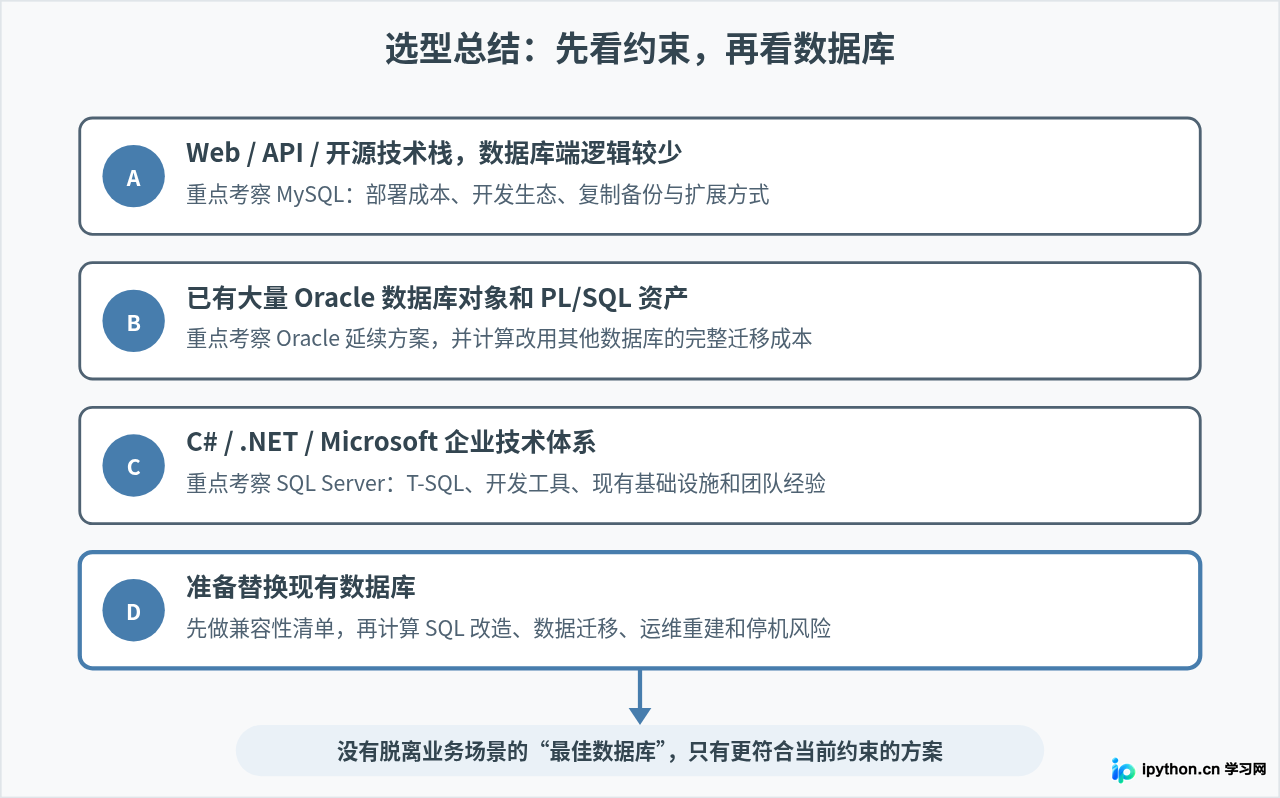
可以把最终判断概括成下面几种情况:
- 常规网站、API 和开源应用:MySQL 通常值得优先评估,尤其是业务逻辑主要位于应用层时。
- 已经深度使用 Oracle:继续使用 Oracle 与迁移到其他数据库都应计算完整成本,PL/SQL 和数据库专有功能是重点。
- Microsoft 技术体系:SQL Server 通常值得重点考察,尤其是应用、开发人员和基础设施已经围绕 Microsoft 产品建立。
- 大型复杂系统:不要通过产品名称直接判断,应建立真实数据规模、事务模型和高可用要求后进行验证。
- 准备迁移数据库:SQL 兼容性、事务差异和外围运维体系通常比数据导入本身更值得关注。
如果是从零开始的新项目,而且没有数据库专有功能要求,可以先确定应用技术栈、数据规模、事务模型、容灾目标和预算,再选择两种候选数据库做真实业务测试。这样得到的结论,比单纯比较“MySQL、Oracle、SQL Server谁更强”更有实际价值。
另外,Oracle、SQL Server 和 MySQL 都存在不同版本、版本授权或商业服务方式,部分企业功能的可用范围也可能不同。正式采购或部署商业功能前,应根据准备采用的具体版本查阅对应厂商的官方授权与功能说明,避免把其他版本的功能直接套用到当前项目。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















