Python爬虫处理验证码同步问题的三种方案及Selenium Cookie操作详解
本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
10-13
7




本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
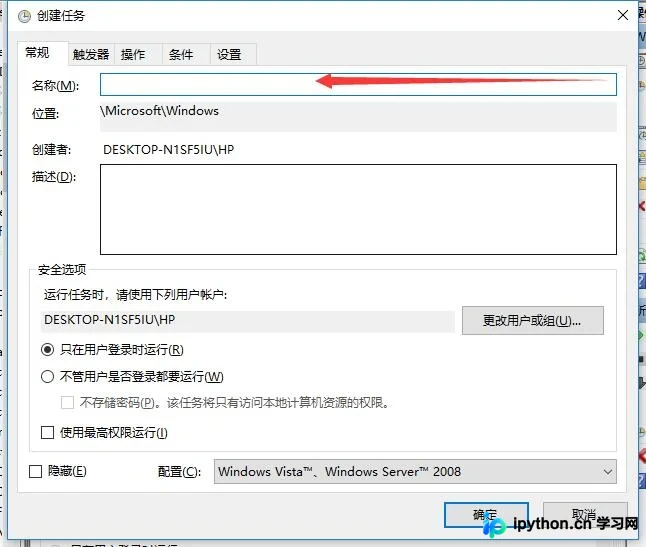
本文详细介绍如何使用Python的Selenium库实现网页自动签到功能。内容涵盖环境配置、ChromeDriver驱动安装、自动化脚本编写及Windows任务计划程序的设置。通过具体代码示例和注册表修改建议,帮助用户解决常见报错并实现每日自动登录签到,适合Web自动化入门者参考。
本文介绍如何在Python3.4环境下利用Splinter库模拟浏览器行为,实现12306网站的自动登录与订票流程。通过代码示例展示如何初始化Chrome浏览器、访问网址、填写账号密码、设置Cookie及执行查询预订操作,为Web自动化测试提供参考。
本文全面介绍XPath(XML路径语言)的核心概念,包括其作为XSLT和XPointer共享语法的用途。详细解析了XPath的四种返回类型、节点树模型及地址路径语法(如/、//、@的使用)。同时系统梳理了核心函数库,涵盖节点集合、字符串处理、布尔逻辑及数字运算函数,为XML数据提取和Web自动化测试提供基础参考。
本文介绍如何利用Python的Selenium库模拟浏览器行为,实现百度搜索引擎的自动输入、内容修改及搜索提交。通过实例演示了文本输入、Backspace删除、空格添加、全选剪切粘贴及回车搜索等具体操作步骤,适用于Web自动化测试场景。
本文介绍如何利用Python3结合Splinter库实现Web门户的自动登录。内容涵盖环境准备、浏览器驱动指定(如Firefox或Chrome)、HTML属性修改及多线程处理等关键步骤,并提供完整的代码示例与注意事项,帮助开发者快速掌握Web自动化登录技术。
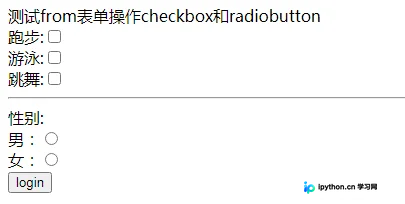
本文详细介绍在Python Selenium自动化测试中如何操作HTML表单中的复选框(Checkbox)和单选按钮(Radio Button)。通过具体示例代码,演示了如何利用click()方法实现选项的选择与反选,以及如何根据名称定位元素组并依据值进行单选操作。内容涵盖HTML结构分析与Python脚本实现,适用于Web自动化测试初学者参考。