使用Seaborn进行NBA球员数据可视化与相关性分析
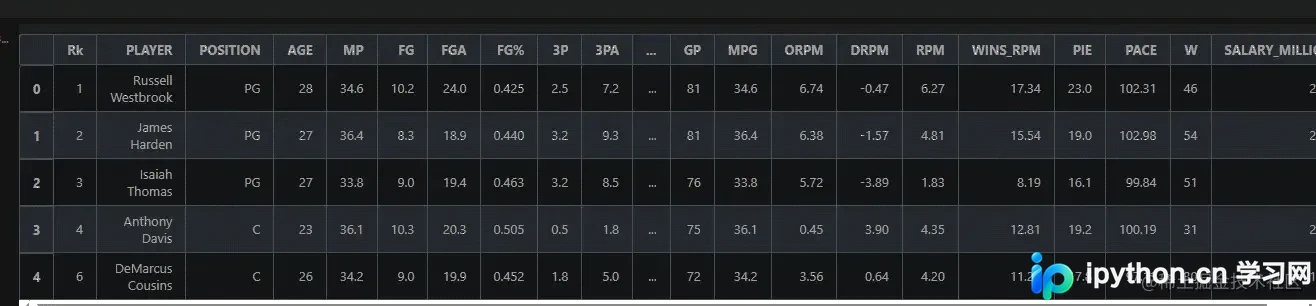
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
2026-10-16
0



本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
本文详细介绍Python中NetworkX库的核心功能,涵盖无向图与有向图的创建、顶点与边的属性管理、图的遍历算法(DFS/BFS)及可视化绘制。重点解析PageRank算法原理与参数配置,通过代码示例演示如何计算节点重要性,适用于社会网络分析与复杂系统建模。
本文详细解析了Python中RGB到YCbCr颜色空间的转换原理与代码实现。通过ITUT BT-601标准矩阵进行像素级计算,并展示了逆变换过程。同时,对比了自定义实现与OpenCV标准库在YCrCb格式下的转换差异,帮助开发者深入理解颜色空间变换机制。
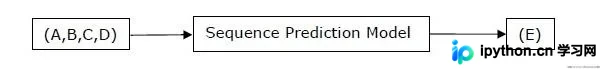
本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
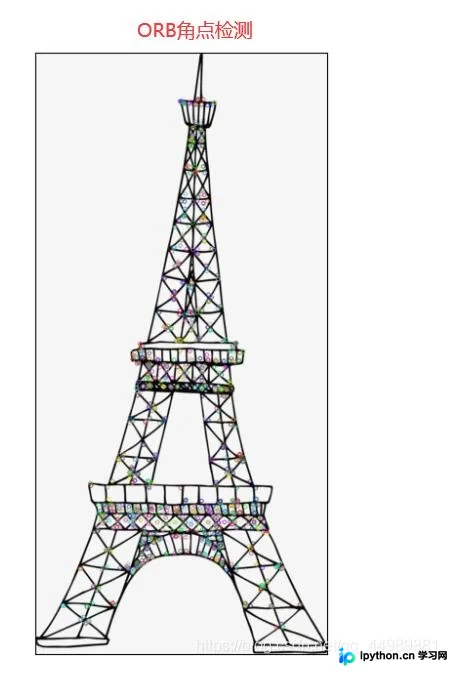
本文详细介绍如何利用OpenCV中的ORB算法进行图像角点检测。内容涵盖ORB算法原理、cv.ORB_create实例化参数设置、detectAndCompute函数用法及返回值解析,以及cv.drawKeypoints绘图函数的颜色与标志位配置,附带完整Python代码示例供参考。
本文介绍如何利用 Python 的 OpenCV 和 PIL 库制作个性化表情包。通过导入前景照片,执行等比例缩放、二值化、旋转及感兴趣区域提取等处理步骤,去除多余黑色背景。随后将处理后的前景与熊猫头背景图拼接,并分别演示了使用 OpenCV 添加英文文本和使用 PIL 添加中文文本的方法,最终保存生成完整的表情包图片。
本文介绍如何使用Python将包含节点对的两列Excel或CSV文件转换为邻接矩阵,并进一步将其转化为COO(坐标)格式。文中提供了基于numpy和pandas的完整代码示例,详细解析了无权无向图的对称性处理、节点索引从0开始的规则,以及PyG中COO格式形状的计算逻辑,适用于复杂网络运算和图神经网络预处理。
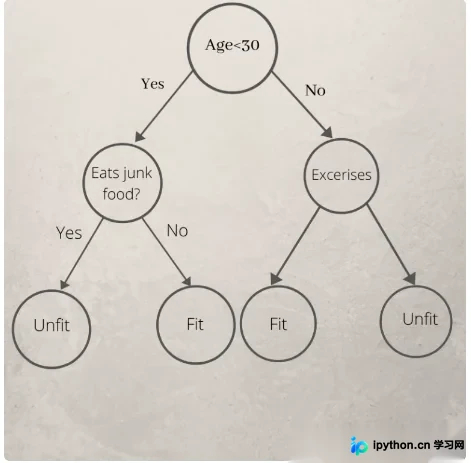
本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
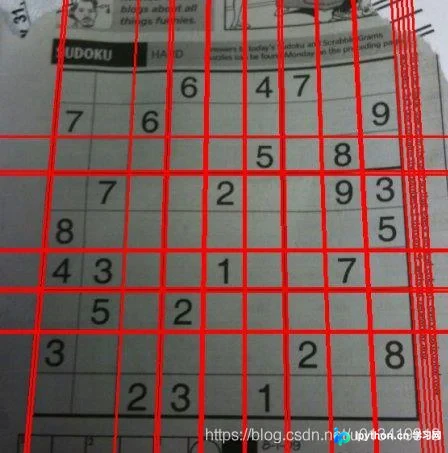
本文详细介绍OpenCV中HoughLines()函数的使用方法。该函数需配合二值化或Canny边缘检测结果使用,通过设置极径和极角精度及累加阈值来检测直线。文中提供了完整的Python代码示例,展示如何从读取图像、边缘检测到绘制检测结果的全过程,并解析了关键参数的物理意义与代码实现细节。
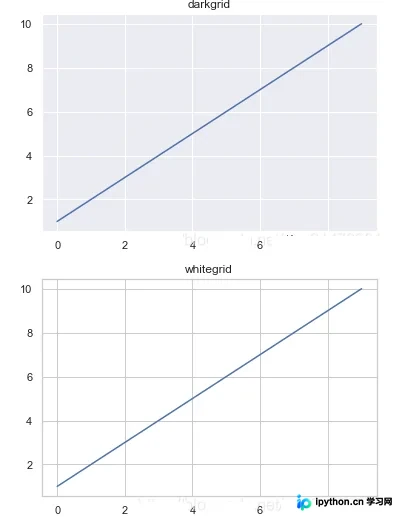
本文详细介绍Python中seaborn库的图形外观设置方法。涵盖使用set_style配置五种背景风格,通过axes_style结合with语句为不同子图应用独立样式,以及利用despine函数控制外框显示。此外,还讲解了plotting_context与set_context对图形缩放的四种模式调整,最后演示如何同时配置背景、缩放及调色板。
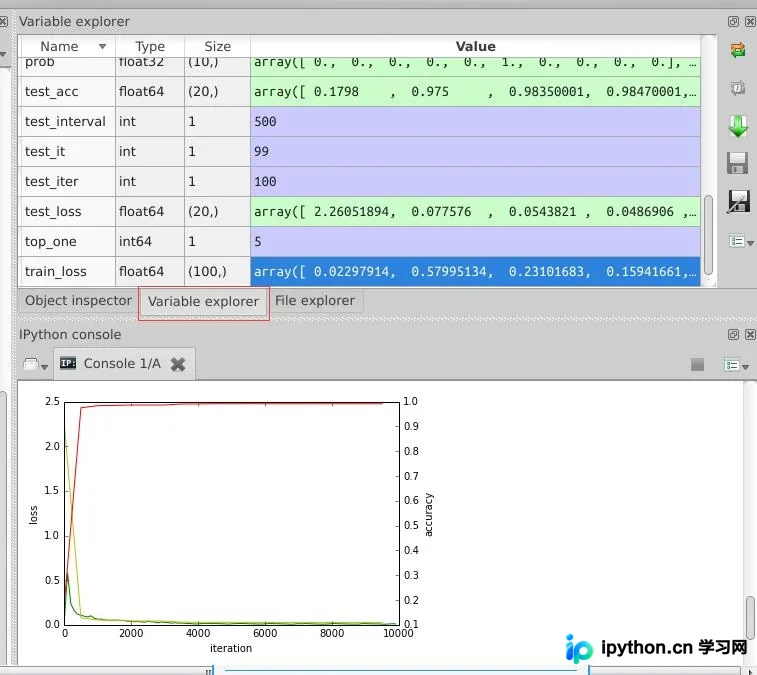
本文介绍如何使用Caffe的Python接口可视化训练过程中的Loss和Accuracy。通过推荐Anaconda环境及Spyder工具,展示如何配置SGDSolver参数,并在迭代过程中收集数据,最终生成训练损失、测试损失及测试准确率的对比图表,帮助开发者直观监控模型训练状态。
本文介绍Python数据分析中Numpy库的核心使用方法。涵盖通过array、arange及random模块创建多维数组,详解dtype、ndim和shape属性以查看数据类型与维度,并简述ones、zeros等辅助创建函数,帮助初学者快速掌握Numpy基础操作。



