Python利用BeautifulSoup与迅雷接口自动抓取视频示例
本文介绍使用Python编写爬虫程序,通过BeautifulSoup解析网页获取视频URL,并利用迅雷COM接口实现自动批量下载的方法。代码包含获取最新网址、分页处理、URL提取及调用迅雷一键下载功能,适合需要自动化视频采集场景的开发者参考。



本文介绍使用Python编写爬虫程序,通过BeautifulSoup解析网页获取视频URL,并利用迅雷COM接口实现自动批量下载的方法。代码包含获取最新网址、分页处理、URL提取及调用迅雷一键下载功能,适合需要自动化视频采集场景的开发者参考。
本文详细介绍如何使用Python的multiprocessing.dummy模块实现线程池爬虫,以梨视频为例演示短视频的批量抓取与下载。内容涵盖URL解析、动态链接拼接、文件命名冲突处理及并发下载优化,提供完整代码示例与关键技术点解析,帮助开发者掌握高效网络爬虫开发技巧。
本文介绍 TensorFlow 官方提供的自动升级脚本 tf_upgrade.py,用于将 0.n 版本代码迁移至 1.0。涵盖单文件与目录批量更新命令、参数配置及局限性说明,帮助开发者高效完成版本兼容处理。
本文详细介绍在Python3爬虫项目中安装RedisDump的方法。由于RedisDump基于Ruby实现,需先配置Ruby环境及rvm工具。文章涵盖通过gem命令安装redis-dump的详细步骤,包括国内源配置、版本验证及命令测试,帮助开发者顺利完成Redis数据迁移工具的部署。
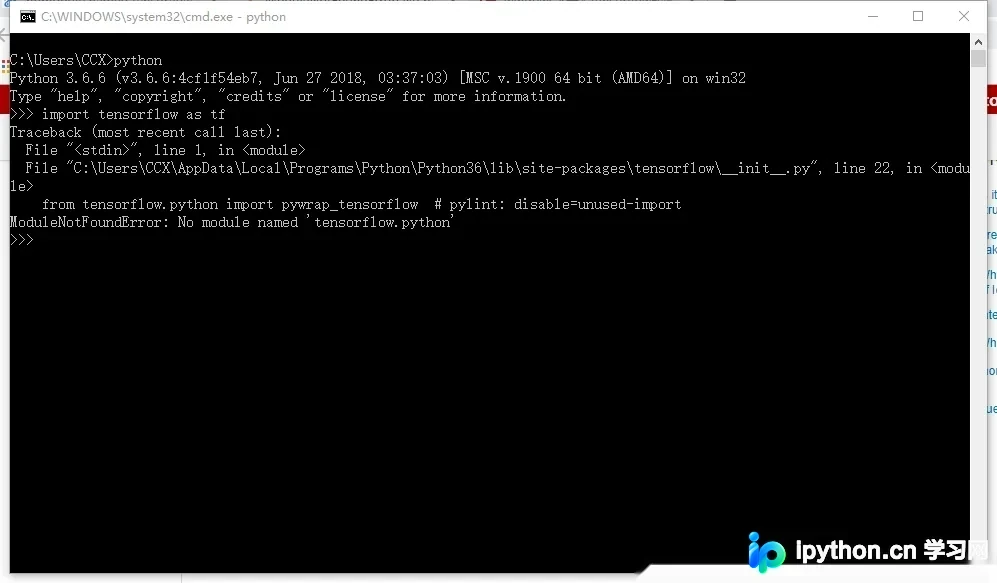
本文针对使用pip安装TensorFlow后运行Python报错“no module named tensorflow.python”的问题提供解决方案。该错误通常因pip未将库安装至Python 3目录所致,建议改用pip3命令重新安装以匹配Python版本,确保模块路径正确。
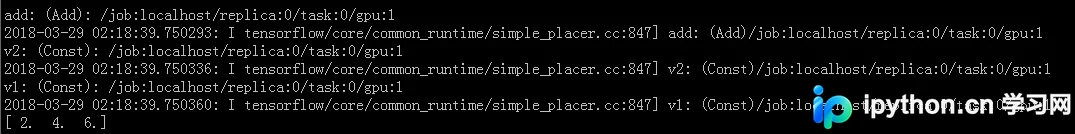
本文详细介绍如何在TensorFlow中使用tf.device()指定模型运行的具体设备,包括GPU和CPU的选择。通过示例代码展示如何指定特定GPU运行Session,以及如何配置ConfigProto打印设备放置信息。同时解释了默认情况下Session在GPU:0上运行的机制,以及如何将计算指定到CPU。
本文详细介绍如何使用Python和Pygame库开发一款猴子摘桃小游戏。内容涵盖项目文件目录结构、图片资源(monkey.png、background.jpg、apple.png)的配置方法,以及在PyCharm中修改代码路径的具体步骤。附带完整源代码及运行截图,适合Python初学者进行实战练习。
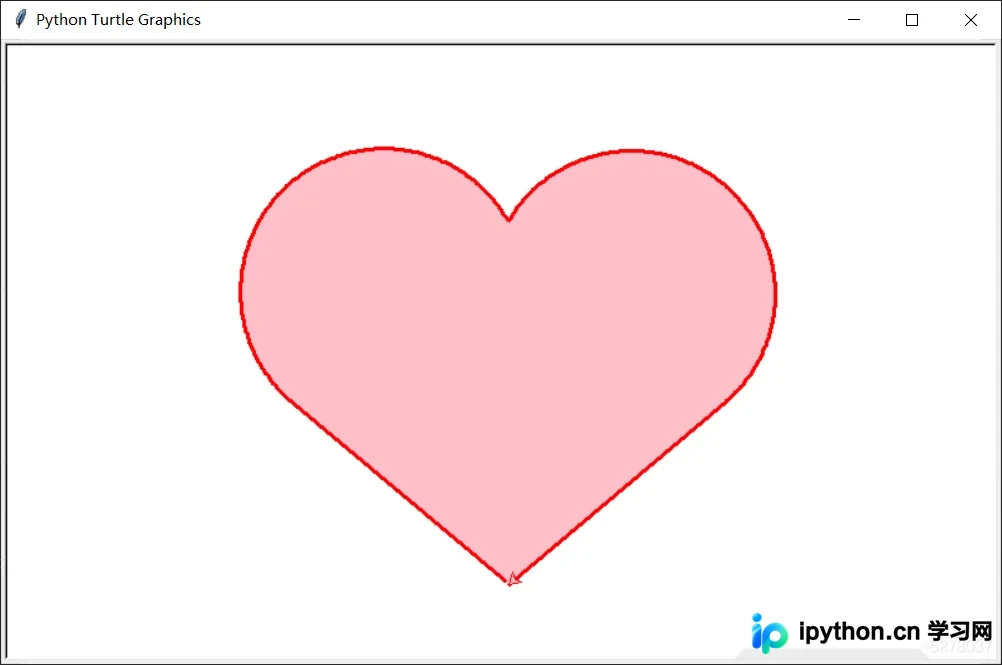
本文详细介绍如何使用Python的Turtle库绘制静态爱心及动态发射爱心的小人。通过解析两段完整源码,涵盖窗口设置、路径规划、圆弧绘制及文字输出等关键步骤,帮助开发者快速掌握基础图形绘制技巧与动画实现逻辑。
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
本文详细解析pandas中DataFrame的条件筛选方法。重点介绍使用布尔型DataFrame进行单条件与多条件筛选的正确写法,指出使用and/or运算符导致的ValueError错误及解决方案。深入对比loc、iloc及已弃用的ix方法的索引机制,说明标签索引与位置索引的区别,并演示如何结合逻辑表达式进行行列筛选。

本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。